Gdy aplikacja webowa korzysta z wielu ekranów, urządzeń i źródeł danych, klasyczne API szybko zaczyna zwracać albo zbyt dużo informacji, albo zbyt mało. GraphQL porządkuje ten problem, pozwalając klientowi precyzyjnie określić, jakiej odpowiedzi potrzebuje. Wyjaśnię, jak działa ta technologia, czym różni się od REST, gdzie sprawdza się najlepiej i na jakie pułapki uważać podczas wdrożenia w aplikacji .NET.
GraphQL daje klientowi większą kontrolę nad danymi
- GraphQL to język zapytań i środowisko uruchomieniowe dla API, a nie baza danych.
- Jedno zapytanie może pobrać dane z wielu powiązanych obiektów.
- Schemat jasno opisuje dostępne typy, pola i operacje.
- Mutacje służą do zapisu danych, a subskrypcje do aktualizacji w czasie rzeczywistym.
- Największe ryzyka to złożone zapytania, problem N+1 i nieprzemyślane uprawnienia.
Czym jest GraphQL w praktyce
GraphQL to sposób projektowania API, w którym klient opisuje dokładnie strukturę danych, jaką chce otrzymać. Serwer sprawdza zapytanie względem schematu, wykonuje odpowiednią logikę i zwraca odpowiedź o bardzo podobnym kształcie.
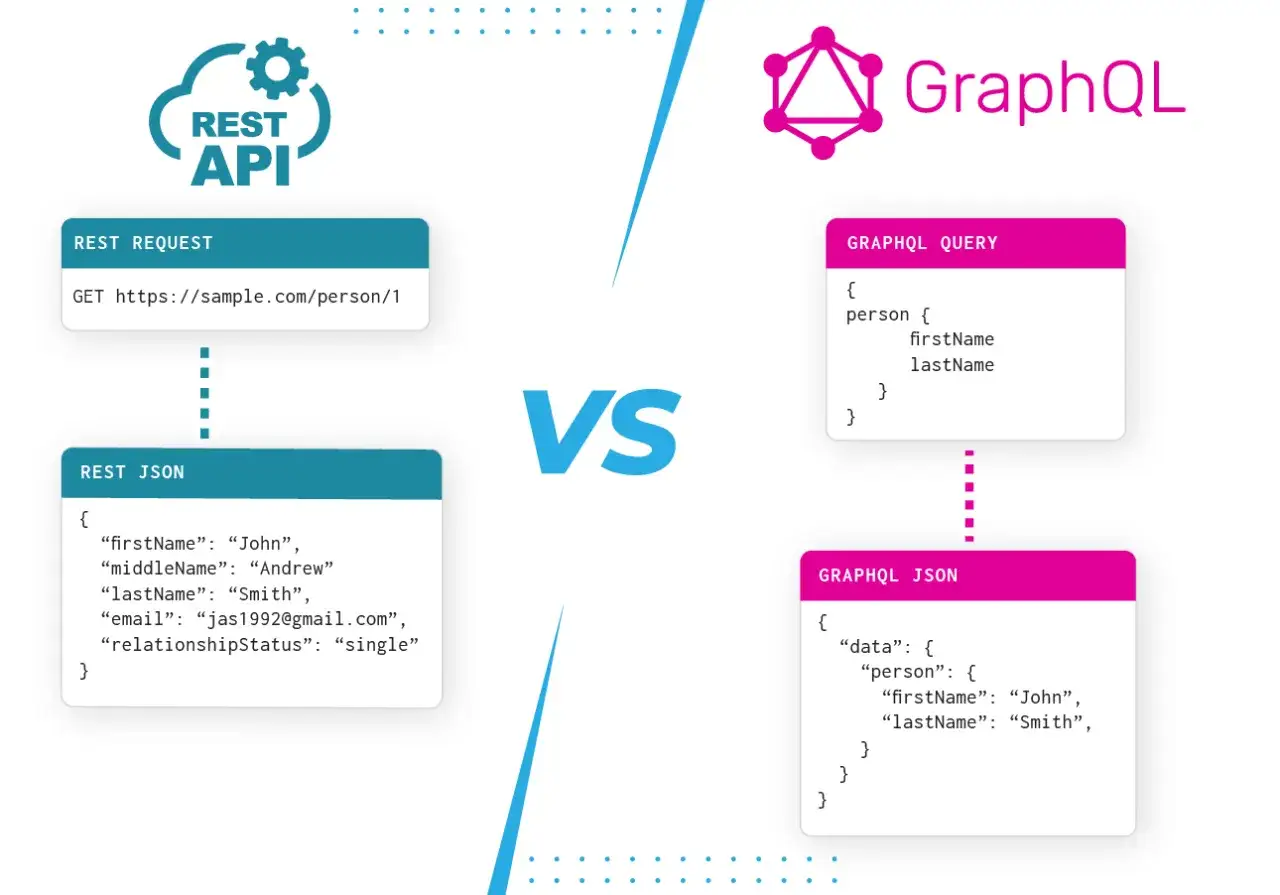
Najprościej wyobrazić to sobie jak zamówienie w restauracji. W REST klient często wybiera gotowy zestaw danych przypisany do konkretnego endpointu. W GraphQL sam wskazuje, czy potrzebuje tylko nazwy produktu, czy również ceny, kategorii i opinii. Dzięki temu pobiera konkretny zestaw pól, bez nadmiarowych informacji.
Technologia nie zastępuje bazy SQL, NoSQL ani istniejących usług REST. GraphQL działa jako warstwa API i może pobierać dane z bazy danych, mikroserwisów, innych API, a nawet kilku źródeł jednocześnie. To ważne rozróżnienie, bo nazwa sugeruje coś związanego z bazami grafowymi, ale GraphQL nie jest językiem zapytań do Neo4j ani alternatywą dla SQL.
Dlaczego powstał GraphQL
W rozbudowanych aplikacjach mobilnych i webowych zespoły często trafiają na dwa problemy. Endpoint zwraca za dużo danych, czyli występuje overfetching, albo trzeba wykonać kilka żądań, by złożyć jeden widok, czyli underfetching.
GraphQL ogranicza oba zjawiska, ponieważ klient może w jednym zapytaniu pobrać na przykład dane użytkownika, jego zamówienia i produkty przypisane do tych zamówień. Nie oznacza to automatycznie mniejszej liczby operacji po stronie serwera. Ostateczna wydajność zależy od resolverów, bazy danych, cache i sposobu rozwiązania zależności.
Jak działa zapytanie, schemat i resolver
Podstawą GraphQL jest schemat. Definiuje on typy danych, pola, argumenty oraz operacje dostępne dla klienta. Dzięki temu narzędzia mogą podpowiadać składnię, a błędy, takie jak żądanie nieistniejącego pola, da się wykryć jeszcze przed wykonaniem logiki biznesowej.
Przykładowy schemat dla sklepu internetowego może wyglądać tak:
type Product {
  id: ID!
  name: String!
  price: Decimal!
  category: Category
}

type Query {
  product(id: ID!): Product
  products(categoryId: ID): [Product!]!
}
Wykrzyknik oznacza pole wymagane, a zapis [Product!]! mówi, że serwer zwróci listę, lista nie będzie pusta, a jej elementy również nie będą miały wartości null. Takie szczegóły wyglądają niepozornie, ale dobrze zaprojektowany schemat ogranicza liczbę niejasności między frontendem a backendem.
Zapytanie od strony klienta
Klient może pobrać tylko te dane, które są potrzebne na konkretnym ekranie:
query ProductDetails($id: ID!) {
  product(id: $id) {
    id
    name
    price
    category {
      name
    }
  }
}
Odpowiedź będzie miała podobny kształt:
{
  "data": {
    "product": {
      "id": "42",
      "name": "Klawiatura mechaniczna",
      "price": 349.00,
      "category": {
        "name": "Akcesoria"
      }
    }
  }
}
Za zwrócenie wartości odpowiada resolver, czyli fragment kodu przypisany do pola lub operacji. Resolver może odczytać rekord z Entity Framework Core, wywołać usługę aplikacyjną albo połączyć dane z kilku systemów. GraphQL kontroluje strukturę zapytania, ale nie narzuca jednej technologii dostępu do danych.
Query, mutation i subscription
GraphQL rozróżnia trzy podstawowe rodzaje operacji. Query służy do odczytu, mutation do zmiany danych, a subscription do przekazywania aktualizacji, gdy po stronie serwera zajdzie określone zdarzenie.
Mutacja może utworzyć zamówienie, zmienić profil użytkownika albo anulować płatność. Subskrypcja ma sens na przykład w czacie, panelu monitoringu lub aplikacji śledzącej status dostawy. Nie każdy projekt potrzebuje komunikacji czasu rzeczywistego, więc nie warto wdrażać subskrypcji wyłącznie dlatego, że GraphQL ją obsługuje.
GraphQL a REST w aplikacji webowej
GraphQL i REST rozwiązują podobny problem, ale robią to przy użyciu innych założeń. REST organizuje API wokół zasobów i endpointów, natomiast GraphQL zwykle udostępnia jeden punkt wejścia oraz schemat opisujący cały model danych.
| Kryterium | GraphQL | REST |
|---|---|---|
| Pobieranie danych | Klient wybiera pola w zapytaniu | Serwer definiuje zawartość odpowiedzi endpointu |
| Liczba endpointów | Często jeden punkt wejścia | Zwykle wiele endpointów dla zasobów |
| Wersjonowanie | Możliwe rozwijanie schematu bez wersji URL | Często stosuje się wersje, na przykład v1 i v2 |
| Cache HTTP | Trudniejszy do skonfigurowania | Naturalnie współpracuje z cache GET |
| Elastyczność frontendu | Bardzo duża | Zależna od przygotowanych endpointów |
| Złożoność backendu | Większa przez schemat i resolvery | Często prostsza na początku |
Nie traktuję GraphQL jako automatycznego następcy REST. Dla prostego CRUD-u, publicznego API z przewidywalnymi zasobami albo systemu mocno wykorzystującego cache HTTP REST może być rozsądniejszy. GraphQL zaczyna wygrywać, gdy wiele klientów potrzebuje różnych widoków tych samych danych.
Dobrym przykładem jest aplikacja e-commerce. Widok produktu w przeglądarce może potrzebować zdjęć, wariantów i opinii, aplikacja mobilna tylko ceny i dostępności, a panel administratora dodatkowo stanów magazynowych. Jeden elastyczny schemat może obsłużyć te scenariusze bez tworzenia osobnych endpointów dla każdego ekranu.
Gdzie GraphQL sprawdza się najlepiej
Największą wartość widać w aplikacjach, w których frontend szybko się zmienia, a dane mają wiele relacji. Dotyczy to platform SaaS, sklepów internetowych, paneli analitycznych, aplikacji mobilnych oraz systemów agregujących dane z mikroserwisów.
- Frontendy wielokanałowe mogą pobierać różne pola na komputerze, tablecie i telefonie.
- Dashboardy składające widok z wielu źródeł ograniczają liczbę ręcznie tworzonych endpointów.
- Mikroserwisy mogą zostać ukryte za jedną warstwą API dla klienta.
- Aplikacje mobilne unikają pobierania dużych odpowiedzi, co ma znaczenie przy wolnym połączeniu.
- Produkty rozwijane przez kilka zespołów korzystają z jawnego schematu i wspólnych kontraktów.
W ekosystemie .NET popularnym wyborem jest Hot Chocolate, który pozwala budować serwery GraphQL w ASP.NET Core. Można też połączyć go z Entity Framework Core, usługami domenowymi i istniejącymi endpointami. Samo dodanie biblioteki nie rozwiązuje jednak problemów architektonicznych. Najpierw trzeba ustalić, jakie dane i operacje powinny być publicznie dostępne.
GraphQL dobrze pasuje również do modelu backend-for-frontend. Taka warstwa przygotowuje dane pod konkretny typ klienta, ale zachowuje jeden kontrakt zapytań. W praktyce często upraszcza pracę frontendu, choć zwiększa odpowiedzialność backendu za wydajność i bezpieczeństwo.
Najważniejsze pułapki i zasady bezpiecznego wdrożenia
Elastyczność zapytań jest jednocześnie największą zaletą i źródłem ryzyka. Użytkownik może wysłać zapytanie, które przechodzi przez wiele relacji i wymusza setki odwołań do bazy. Dlatego produkcyjne API powinno mieć limity głębokości, złożoności i czasu wykonania.
Problem N+1
Jeżeli zapytanie pobiera 100 produktów, a resolver kategorii wykonuje osobne zapytanie dla każdego produktu, zamiast jednego zapytania powstaje 101 operacji. To klasyczny problem N+1. Rozwiązaniem jest między innymi batching i DataLoader, który grupuje odczyty oraz korzysta z pamięci podręcznej w obrębie jednej operacji.
Uprawnienia i dane wrażliwe
Autoryzacja nie może kończyć się na sprawdzeniu, czy użytkownik jest zalogowany. Każde pole lub resolver powinien uwzględniać role, zakres dostępu i właściciela danych. Szczególnej ostrożności wymagają pola finansowe, dane osobowe i operacje zmieniające stan systemu.
Warto ograniczyć introspekcję na publicznej produkcji, stosować limity zapytań, rejestrować koszt operacji i rozważyć persisted queries. Te ostatnie pozwalają wykonywać tylko wcześniej zatwierdzone zapytania, co zmniejsza ryzyko nadużyć. Nie zastępują autoryzacji, ale dodatkowo zawężają powierzchnię ataku.
Przeczytaj również: ng command not found? Jak naprawić Angular CLI
Cache, błędy i obserwowalność
Cache w GraphQL wymaga więcej planowania niż zwykłe cache’owanie żądań GET. Trzeba określić, które dane mogą być przechowywane, jak identyfikować obiekty i kiedy unieważniać wynik. W systemach o wysokim ruchu przydają się także metryki czasu resolverów, liczby błędów i najczęściej używanych zapytań.
Nie należy ukrywać wszystkich problemów w jednym ogólnym komunikacie błędu. Klient powinien dostać informację wystarczającą do obsługi sytuacji, ale bez ujawniania szczegółów infrastruktury. W logach warto zapisywać identyfikator operacji, użytkownika, czas wykonania i koszt zapytania.
Jak zacząć z GraphQL bez niepotrzebnego ryzyka
Najbezpieczniej zacząć od małego, dobrze odgraniczonego obszaru, na przykład katalogu produktów albo profilu użytkownika. Nie przenosiłbym od razu całego monolitu. Pierwszy etap powinien pokazać, czy elastyczność zapytań rzeczywiście upraszcza pracę zespołu.
- Zdefiniuj przypadki użycia, a nie tylko encje z bazy danych.
- Zaprojektuj schemat zgodnie z językiem domeny i potrzebami klientów.
- Oddziel resolvery od logiki biznesowej, korzystając z usług aplikacyjnych.
- Dodaj testy zapytań oraz sprawdzanie uprawnień dla każdego wrażliwego pola.
- Włącz limity i monitoring przed udostępnieniem API poza środowiskiem testowym.
Warto też ustalić zasady zmian schematu. GraphQL ułatwia dodawanie pól bez łamania istniejących klientów, ale usuwanie lub zmiana znaczenia pola nadal może być destrukcyjna. Oznaczanie starych pól jako deprecated i obserwowanie ich użycia daje klientom czas na migrację.
Moja praktyczna rada jest prosta: traktuj schemat GraphQL jak publiczny kontrakt, nawet jeśli początkowo korzysta z niego tylko jeden frontend. Taka dyscyplina procentuje, gdy do projektu dołącza aplikacja mobilna, integracja zewnętrzna albo drugi zespół.
GraphQL jako decyzja architektoniczna, nie modny dodatek
GraphQL ma sens wtedy, gdy aplikacja potrzebuje elastycznego pobierania powiązanych danych, obsługuje wiele typów klientów albo łączy kilka źródeł w jeden spójny interfejs. W prostym API z kilkoma zasobami REST może pozostać lżejszym i bardziej przewidywalnym wyborem.
Jeśli zdecydujesz się na GraphQL, zacznij od schematu, przypadków użycia i zasad bezpieczeństwa. Dopiero później dobieraj biblioteki, cache i dodatkowe mechanizmy. Dobrze zaprojektowana warstwa GraphQL potrafi znacząco uprościć rozwój aplikacji webowej, ale źle zaprojektowana szybko zamienia się w trudny do kontrolowania punkt dostępu do całego backendu.