Masz działający monolit, ale każda większa zmiana zaczyna wpływać na całą aplikację, wdrożenie trwa coraz dłużej, a skalowanie jednego modułu wymaga uruchamiania wszystkiego od nowa. Mikroserwisy w .NET mogą rozwiązać ten problem, pod warunkiem że granice usług wynikają z domeny, a nie z przypadkowego podziału klas. Pokażę, jak projektować takie systemy, które wzorce naprawdę pomagają oraz jak przygotować aplikację do wdrożenia w kontenerach i chmurze.
Najważniejsze decyzje wpływają na sukces mikroserwisów
- Granice domenowe są ważniejsze niż liczba usług i rozmiar projektów.
- Każdy mikroserwis powinien mieć własne dane i niezależny cykl wdawniania.
- Do komunikacji synchronicznej sprawdzą się HTTP lub gRPC, a do procesów rozproszonych zdarzenia i kolejki.
- Outbox, Saga, retry i circuit breaker ograniczają ryzyko utraty danych oraz kaskadowych awarii.
- ASP.NET Core, Docker, .NET Aspire i Kubernetes tworzą praktyczny stos do budowy i wdrażania usług.
Kiedy mikroserwisy w .NET mają sens
Mikroserwis to osobny proces odpowiedzialny za konkretną zdolność biznesową, na przykład katalog produktów, zamówienia albo płatności. Powinien dać się testować, wdrażać i skalować niezależnie od pozostałych części systemu. Sama technologia .NET nie sprawia jednak, że aplikacja automatycznie staje się mikroserwisowa. Potrzebne są jeszcze właściwe granice, kontrakty i sposób zarządzania zależnościami.
Największą korzyść widzę w systemach, które mają kilka niezależnych obszarów biznesowych oraz zespoły pracujące nad nimi w różnym tempie. Jeśli katalog produktów wymaga częstych wdrożeń, a moduł raportowy obciąża bazę tylko raz dziennie, można rozwijać i skalować te elementy osobno. Zyskujemy wtedy autonomię zespołów i bardziej precyzyjne wykorzystanie infrastruktury.
Cena jest konkretna. Zamiast jednego procesu pojawiają się sieć, kontenery, logi z wielu instancji, problemy z częściową awarią i trudniejsze testy integracyjne. Dlatego dla małego systemu, który rozwija 2-4 osoby, rozsądniejszy bywa modularny monolit. Pozwala zachować granice domenowe, ale nie wymusza od razu całej infrastruktury rozproszonej.
Granice usług trzeba wyprowadzić z domeny
Najczęstszy błąd polega na dzieleniu aplikacji według warstw technicznych. Osobny serwis dla kontrolerów, osobny dla repozytoriów i osobny dla logiki biznesowej nie daje mikroserwisów. Daje rozproszoną aplikację, w której każda prosta zmiana wymaga wielu wdrożeń.
Lepszym punktem wyjścia jest analiza procesów biznesowych. W sklepie internetowym naturalnymi kandydatami mogą być Orders, Catalog, Basket i Payments, ponieważ każdy obszar ma inne reguły, dane oraz tempo zmian. Nie oznacza to, że każdy z nich od razu musi stać się osobnym wdrożeniem. Najpierw warto ustalić, gdzie przebiegają granice odpowiedzialności.
Jedna usługa, jeden właściciel danych
Reguła „jedna baza na cały system” szybko niszczy niezależność usług. Jeśli dwa mikroserwisy zapisują te same tabele, ich wdrożenia są ze sobą związane, a zmiana schematu wymaga koordynacji wszystkich konsumentów. Zdecydowanie bezpieczniej jest, gdy usługa posiada własny model danych, nawet jeśli kilka baz działa w tym samym silniku SQL.
Własna baza nie oznacza, że każda usługa musi używać innej technologii. Orders i Payments mogą korzystać z SQL Servera, a Catalog może używać PostgreSQL albo dokumentowej bazy danych, jeśli uzasadnia to sposób wyszukiwania. Ważniejsze od różnorodności technologii jest to, aby inne usługi nie omijały API i nie czytały cudzych tabel.
Nie przesadzaj z rozmiarem
Mikroserwis nie powinien być tak mały, że każda zmiana biznesowa wymaga komunikacji między pięcioma procesami. Jeśli utworzenie zamówienia wymaga dziesięciu synchronicznych wywołań, system staje się kruchy i trudny do diagnozowania. W praktyce zaczynam od 2-3 dobrze wyznaczonych modułów, a dalszy podział uzależniam od rzeczywistych potrzeb.
Pomocne pytanie brzmi: czy ten fragment może mieć własny cykl życia, własne reguły i własne dane? Jeśli odpowiedź jest negatywna, prawdopodobnie nie ma jeszcze powodu, aby wydzielać go do osobnej usługi.
Komunikacja i spójność danych wymagają świadomych kompromisów
W systemie rozproszonym każde wywołanie między usługami jest operacją sieciową. Może się opóźnić, zakończyć błędem albo zostać wykonane, mimo że odpowiedź nie dotarła do nadawcy. Z tego powodu projektuję komunikację tak, aby awaria jednej usługi nie zatrzymywała całego systemu.
HTTP, gRPC czy komunikaty
| Mechanizm | Kiedy pasuje | Główne ryzyko |
|---|---|---|
| HTTP/REST | Publiczne API, proste operacje i integracje z innymi systemami | Zależność od dostępności usługi wywoływanej w danym momencie |
| gRPC | Szybka komunikacja wewnętrzna między usługami z kontrolowanym kontraktem | Większa złożoność po stronie klientów i mniejsza wygoda dla zewnętrznych konsumentów |
| Broker wiadomości | Procesy asynchroniczne, integracje i reakcje na zdarzenia domenowe | Opóźniona spójność oraz konieczność obsługi ponowień |
REST jest dobrym domyślnym wyborem dla publicznego API. gRPC, czyli binarny protokół komunikacyjny oparty na kontraktach definiowanych w plikach Protobuf, ma sens przy intensywnej komunikacji wewnętrznej. Broker wiadomości, taki jak RabbitMQ, Azure Service Bus albo Kafka, oddziela nadawcę od odbiorcy i pozwala kontynuować pracę nawet wtedy, gdy konsument jest chwilowo niedostępny.
Outbox i Saga zamiast jednej transakcji
Załóżmy, że Orders zapisuje zamówienie w bazie, a potem publikuje zdarzenie OrderCreated. Jeśli proces zakończy się pomiędzy tymi operacjami, zamówienie istnieje, ale Payments nie dostanie informacji o jego utworzeniu. Wzorzec Transactional Outbox zapisuje dane biznesowe i zdarzenie w jednej lokalnej transakcji, a osobny proces publikuje komunikat później.
Gdy proces obejmuje kilka usług, przydaje się Saga. Każda usługa wykonuje własną transakcję, a w razie problemu uruchamiana jest akcja kompensująca, na przykład anulowanie rezerwacji albo zwrot płatności. To nie jest pełny zamiennik transakcji ACID, dlatego trzeba zaakceptować spójność ostateczną i jasno opisać stany pośrednie.
Każdy konsument komunikatów powinien być idempotentny. Oznacza to, że ponowne przetworzenie tego samego zdarzenia nie może podwójnie pobrać płatności ani utworzyć drugiej wysyłki. W praktyce stosuję identyfikator wiadomości, tabelę przetworzonych komunikatów oraz retry z ograniczeniem liczby prób.
Budowa mikroserwisu w ASP.NET Core
Typowa usługa może być aplikacją ASP.NET Core Web API uruchamianą w kontenerze. Jej publiczna część powinna być niewielka, a logika biznesowa oddzielona od infrastruktury. Dla prostego CRUD-u wystarczy prostszy układ, natomiast w bardziej złożonym module lepiej sprawdza się Clean Architecture lub podejście heksagonalne.
Nie stosuję CQRS, czyli rozdzielenia modeli odczytu i zapisu, automatycznie w każdej usłudze. Jest przydatne wtedy, gdy odczyty i zapisy mają różne wymagania, model domenowy jest złożony albo potrzebujemy osobnych ścieżek skalowania. Przy zwykłym katalogu produktów dodatkowa warstwa może tylko zwiększyć ilość kodu.
Minimalny punkt startowy może wyglądać tak:
var builder = WebApplication.CreateBuilder(args);

builder.Services.AddControllers();
builder.Services.AddHealthChecks();

var app = builder.Build();

app.MapControllers();
app.MapHealthChecks("/health");

app.Run();
Sam endpoint zdrowia nie wystarcza do monitorowania aplikacji. Warto rozdzielić liveness, czyli informację, czy proces działa, od readiness, która mówi, czy usługa może przyjmować ruch. Jeśli baza danych jest niedostępna, proces może nadal działać, ale nie powinien otrzymywać nowych żądań wymagających zapisu.
Kontrakt API powinien być wersjonowany ostrożnie. Dodanie opcjonalnego pola zwykle jest bezpieczniejsze niż zmiana znaczenia istniejącego pola. Przy komunikatach asynchronicznych trzeba zachować kompatybilność wsteczną, ponieważ starszy konsument może przetwarzać zdarzenia jeszcze długo po wdrożeniu nowej wersji producenta.
Wdrażanie wymaga automatyzacji i obserwowalności
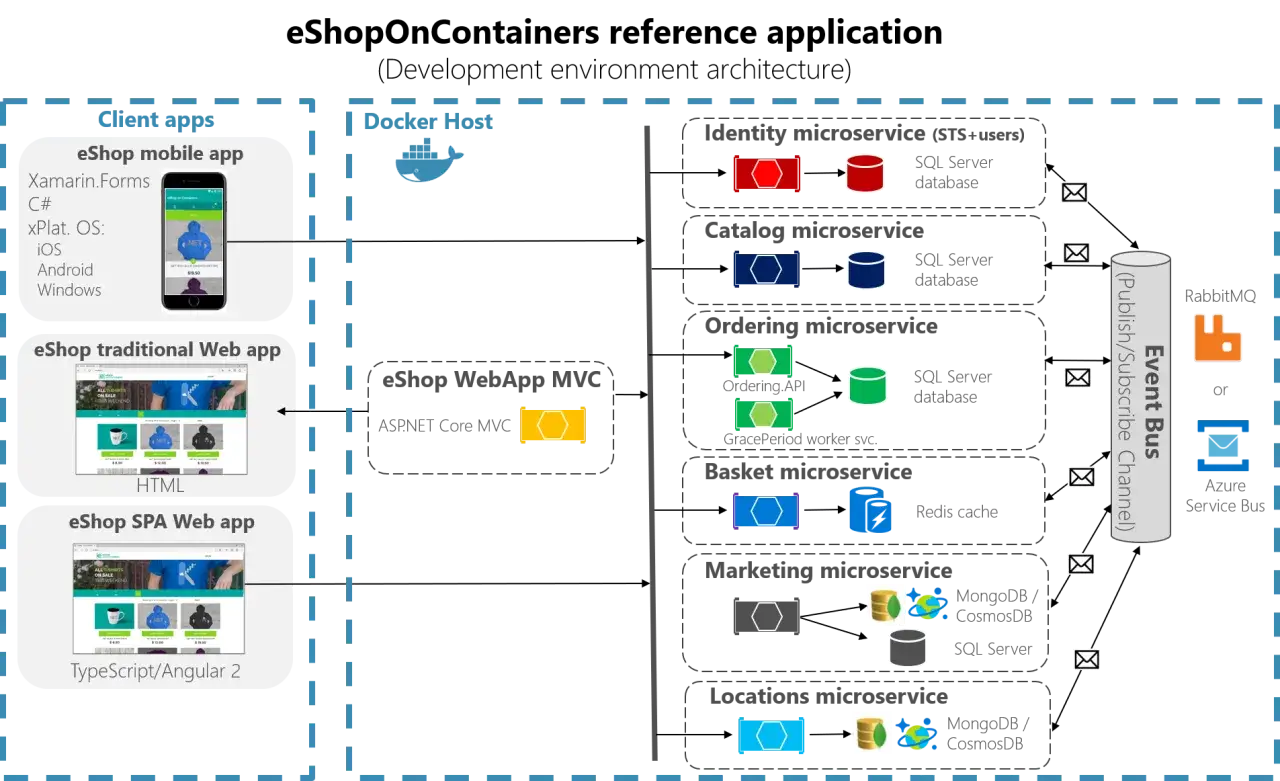
Kontener upraszcza powtarzalne uruchamianie usługi, ale nie rozwiązuje zarządzania całym systemem. W środowisku lokalnym przydaje się Docker Compose, natomiast większe instalacje mogą korzystać z Kubernetes, Azure Container Apps albo innych platform kontenerowych. Wybór zależy od potrzeb zespołu, a nie od mody na konkretny orchestrator.
.NET Aspire ułatwia lokalne uruchamianie aplikacji składającej się z wielu projektów, baz danych i zależności. Szczególnie cenię go podczas developmentu, gdy chcę szybko sprawdzić konfigurację połączeń, health checki oraz podstawową telemetrię. Do produkcji nadal trzeba świadomie wybrać docelową platformę, politykę sekretów, skalowanie i sposób aktualizacji.
Pipeline CI/CD powinien budować obraz, uruchamiać testy, skanować zależności i wdrażać konkretną wersję artefaktu. Nie warto budować obrazu ponownie dla każdego środowiska. Bezpieczniejszy model polega na tym, że ten sam obraz przechodzi przez test, staging i produkcję, a różnią się tylko konfiguracja oraz sekrety.
Przeczytaj również: SOLID w C# bez przesady - zasady, przykłady i refaktoryzacja
Co obserwować od pierwszego dnia
- Logi strukturalne z identyfikatorem korelacji, nazwą operacji i identyfikatorem użytkownika.
- Metryki dotyczące czasu odpowiedzi, liczby błędów, długości kolejek i wykorzystania zasobów.
- Ślady rozproszone, które pokazują przebieg jednego żądania przez kilka usług.
- Alerty dla opóźnień, wzrostu błędów, niedostępności zależności i zalegających komunikatów.
Retry bez limitu potrafi zamienić chwilowy problem w lawinę żądań. Dlatego łączę go z timeoutem, backoffem i circuit breakerem. Ten ostatni czasowo odcina wywołania do niesprawnej usługi, dzięki czemu pozostałe komponenty zachowują częściową sprawność zamiast czekać bez końca.
Największe błędy wynikają z przeceniania technologii
Najczęściej widzę systemy, w których zespół zaczyna od Kubernetes, brokera i kilkunastu projektów, zanim ustali model domeny. Infrastruktura wygląda wtedy profesjonalnie, ale każda zmiana wymaga ręcznego synchronizowania wielu elementów. Mikroserwisy nie naprawią niejasnych reguł biznesowych ani złej komunikacji w zespole.
| Sytuacja | Rozsądny wybór | Dlaczego |
|---|---|---|
| Mała aplikacja i jeden zespół | Modularny monolit | Mniej operacyjnych zależności i prostsze testy |
| Kilka niezależnych obszarów biznesowych | Stopniowe wydzielanie usług | Możliwość skalowania i wdrażania wybranych modułów |
| Dużo procesów asynchronicznych | Mikroserwisy z brokerem zdarzeń | Lepsze odseparowanie producentów i konsumentów |
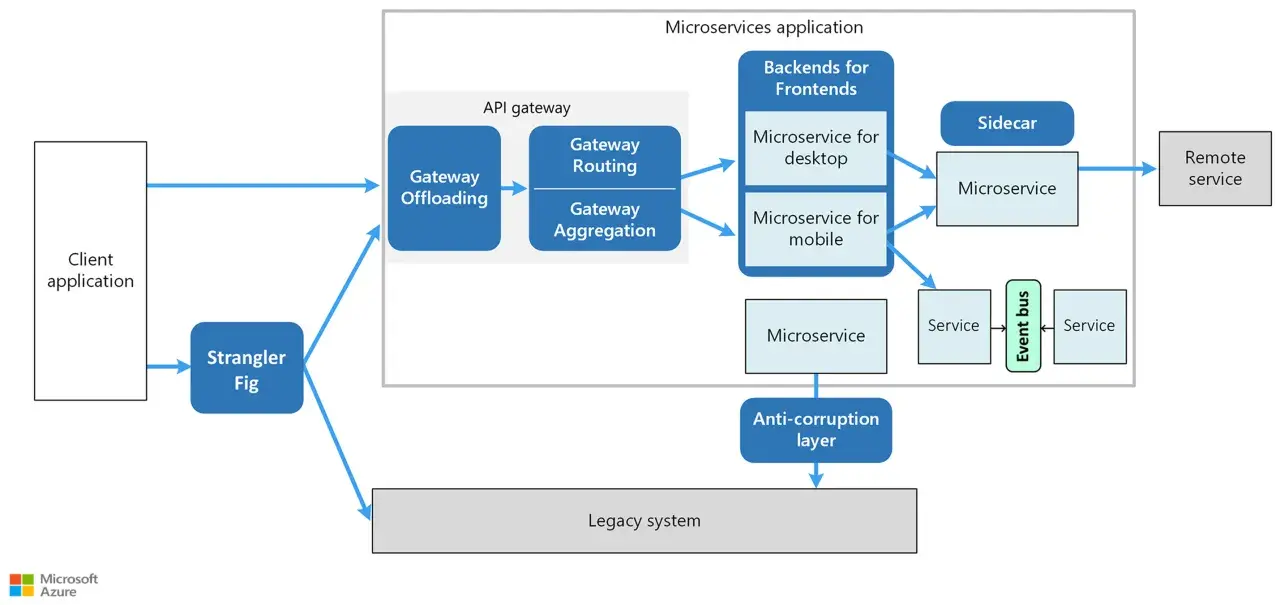
| Monolit z trudnym modułem do zmiany | Strangler Fig | Stopniowa migracja bez przepisywania całości |
Nie zaczynałbym też od dzielenia wspólnego modelu klas między wszystkie usługi. Wspólna biblioteka DTO może szybko stać się ukrytą zależnością, która blokuje niezależne wersjonowanie. Lepiej współdzielić kontrakty tylko wtedy, gdy jest to świadoma decyzja, a nie wygodny skrót.
Najbezpieczniejsza ścieżka migracji prowadzi przez modularny monolit, pomiary i jedno kontrolowane wydzielenie. Najpierw można oddzielić moduł, który ma wyraźne granice i realny problem ze skalowaniem lub tempem zmian. Dopiero dane z produkcji pokażą, czy kolejne usługi przyniosą korzyść.
Od czego zacząć pierwszy projekt mikroserwisowy
Wybrałbym niewielki, ale kompletny przepływ biznesowy, na przykład utworzenie zamówienia. Powinien obejmować API, walidację, zapis danych, komunikat domenowy, obsługę błędu i podstawowe metryki. Taki zakres uczy więcej niż pięć atrap usług, które tylko zwracają dane z pamięci.
Przed wdrożeniem sprawdziłbym cztery rzeczy. Czy każda usługa może działać bez dostępu do cudzej bazy? Czy wiadomo, co dzieje się po timeoutach i ponowieniu komunikatu? Czy da się znaleźć jedno żądanie w logach wszystkich komponentów? Czy zespół potrafi wdrożyć zmianę bez ręcznej koordynacji kilku repozytoriów?
Jeśli odpowiedzi są twierdzące, technologia zaczyna pracować na rzecz architektury. Jeśli nie, kolejne biblioteki tylko zamaskują problem. W mikroserwisach największą przewagę daje nie liczba kontenerów, lecz jasna odpowiedzialność, odporna komunikacja i możliwość bezpiecznej zmiany.