Gdy aplikacja ma coraz więcej reguł biznesowych, ten sam model danych zaczyna jednocześnie obsługiwać skomplikowane zapisy i dziesiątki prostych odczytów. Właśnie wtedy rozdzielenie komend od zapytań może uporządkować kod, poprawić wydajność i ułatwić rozwój, ale tylko pod warunkiem, że problem rzeczywiście tego wymaga. Pokażę, jak działa CQRS w aplikacjach .NET, czym różnią się jego warianty, kiedy ma sens oraz jakie koszty pojawiają się po drodze.
Najważniejsze decyzje dotyczące CQRS w jednym miejscu
- Komendy zmieniają stan systemu, a zapytania tylko odczytują dane.
- CQRS nie wymaga od razu dwóch baz danych ani architektury mikroserwisowej.
- Największą korzyść daje przy złożonych regułach biznesowych i dużej różnicy między odczytem a zapisem.
- Oddzielne modele odczytu mogą zwiększyć wydajność, ale często wprowadzają opóźnioną spójność.
- W prostym CRUD rozdzielenie odpowiedzialności zwykle oznacza więcej kodu bez proporcjonalnej korzyści.
Na czym polega rozdzielenie komend i zapytań
Skrót CQRS oznacza Command Query Responsibility Segregation, czyli rozdzielenie odpowiedzialności za operacje zmieniające dane i operacje, które je odczytują. W polskich materiałach spotkasz też angielskie określenie cqrs pattern, ale sama nazwa jest mniej istotna niż praktyczna zasada: odczyt i zapis nie muszą korzystać z tego samego modelu.
Komenda opisuje zamiar wykonania operacji, na przykład „złóż zamówienie”, „anuluj płatność” albo „zmień adres dostawy”. Handler komendy sprawdza reguły biznesowe, modyfikuje agregat i zapisuje wynik. Zapytanie ma znacznie prostszą rolę. Pobiera dane potrzebne konkretnemu ekranowi, raportowi lub endpointowi i nie powinno zmieniać stanu aplikacji.
W tradycyjnym CRUD jeden model encji często obsługuje oba przypadki. Encja Order może być ładowana przez formularz edycji, widok listy, raport administracyjny i proces płatności. Po pewnym czasie zaczyna zawierać pola oraz zależności potrzebne głównie do odczytu, a logika zapisu miesza się z projekcjami danych.
W CQRS model zapisu może pilnować reguł domenowych, a model odczytu może być płaskim DTO przygotowanym dokładnie dla klienta. Nie chodzi więc wyłącznie o fizyczne bazy danych. Najważniejszy jest podział odpowiedzialności w kodzie.
Przeczytaj również: var w JavaScripcie - zakres, hoisting i pułapki starego kodu
Command nie jest zwykłą metodą aktualizacji
Dobrze zaprojektowana komenda opisuje działanie biznesowe, a nie techniczny szczegół SQL. ChangeOrderStatusCommand mówi, co ma się wydarzyć, natomiast handler decyduje, jak sprawdzić uprawnienia, przejścia statusów i warunki transakcji.
public sealed record ConfirmOrderCommand(Guid OrderId);

public sealed class ConfirmOrderHandler
{
    public async Task Handle(
        ConfirmOrderCommand command,
        CancellationToken cancellationToken)
    {
        var order = await repository.Get(command.OrderId, cancellationToken);

        order.Confirm();
        await repository.Save(order, cancellationToken);
    }
}
W praktyce często używa się bibliotek pośredniczących, takich jak MediatR, ale nie są one definicją CQRS. Można zbudować ten styl bez mediatora, korzystając ze zwykłych klas aplikacyjnych. Biblioteka porządkuje przepływ, lecz nie zastąpi dobrego modelu domeny ani sensownego podziału odpowiedzialności.
Jak wygląda przepływ CQRS w aplikacji .NET
Typowy przepływ zaczyna się w kontrolerze ASP.NET Core lub endpointcie Minimal API. Warstwa wejściowa tworzy komendę albo zapytanie i przekazuje je do odpowiedniego handlera. Handler komendy korzysta z modelu domenowego i transakcji, a handler zapytania pobiera gotowy model widoku.
Najprostszy układ można przedstawić tak:
- Endpoint przyjmuje żądanie HTTP i wykonuje podstawową walidację.
- Command handler uruchamia reguły biznesowe i zapisuje zmianę.
- Query handler pobiera dane w formie dopasowanej do klienta.
- Model zapisu chroni spójność oraz reguły domenowe.
- Model odczytu zapewnia szybkie i wygodne projekcje.
Przykładowe zapytanie nie musi ładować całej encji ani uruchamiać mechanizmu śledzenia zmian Entity Framework Core. Dla listy zamówień często lepiej wykonać projekcję do DTO albo użyć Dappera i pobrać dokładnie te kolumny, które są potrzebne.
public sealed record GetCustomerOrdersQuery(Guid CustomerId);

public sealed record OrderListItem(
    Guid Id,
    string Number,
    string Status,
    decimal Total);

public sealed class GetCustomerOrdersHandler
{
    public Task> Handle(
        GetCustomerOrdersQuery query,
        CancellationToken cancellationToken)
    {
        return db.Orders
            .Where(x => x.CustomerId == query.CustomerId)
            .Select(x => new OrderListItem(
                x.Id,
                x.Number,
                x.Status,
                x.Total))
            .ToListAsync(cancellationToken);
    }
}
Takie zapytanie jest odseparowane od modelu domenowego. Nie musi wiedzieć, jak zamówienie zmienia status ani jakie warunki obowiązują przy jego zatwierdzaniu. Dzięki temu kod odczytu jest prostszy, a model domenowy nie zostaje obciążony potrzebami każdego ekranu w systemie.
Nie należy jednak utożsamiać CQRS z endpointami HTTP POST i GET. Sam fakt, że aplikacja używa różnych czasowników HTTP, nie oznacza jeszcze rozdzielenia modeli. CQRS dotyczy przede wszystkim granicy między operacją zmieniającą stan a operacją odczytującą stan.
Trzy warianty rozdzielenia, które warto odróżnić
Najczęstszy błąd polega na założeniu, że CQRS zawsze oznacza dwie aplikacje, dwie bazy danych i komunikację przez broker. To jeden z możliwych wariantów, ale nie punkt wyjścia. W wielu projektach rozsądniej zacząć od rozdzielenia kodu przy zachowaniu wspólnego magazynu danych.
| Wariant | Jak działa | Kiedy ma sens |
|---|---|---|
| Logiczne CQRS | Komendy i zapytania mają osobne klasy, ale korzystają z jednej bazy. | Gdy chcesz uporządkować kod bez kosztownej zmiany infrastruktury. |
| Rozdzielone modele | Model zapisu i odczytu mają różne struktury, lecz mogą działać na tym samym silniku bazy. | Gdy widoki wymagają wielu projekcji, a zapis ma złożone reguły. |
| Pełne CQRS | Odczyt i zapis używają oddzielnych magazynów, często synchronizowanych zdarzeniami. | Gdy potrzebujesz niezależnego skalowania, różnych technologii lub dużej wydajności odczytu. |
W pierwszym wariancie możesz użyć Entity Framework Core po stronie zapisu oraz osobnych zapytań SQL po stronie odczytu. To często najlepszy kompromis dla monolitu. Zespół zyskuje czytelny podział, ale nie musi od razu rozwiązywać problemów replikacji, kolejek i odbudowy projekcji.
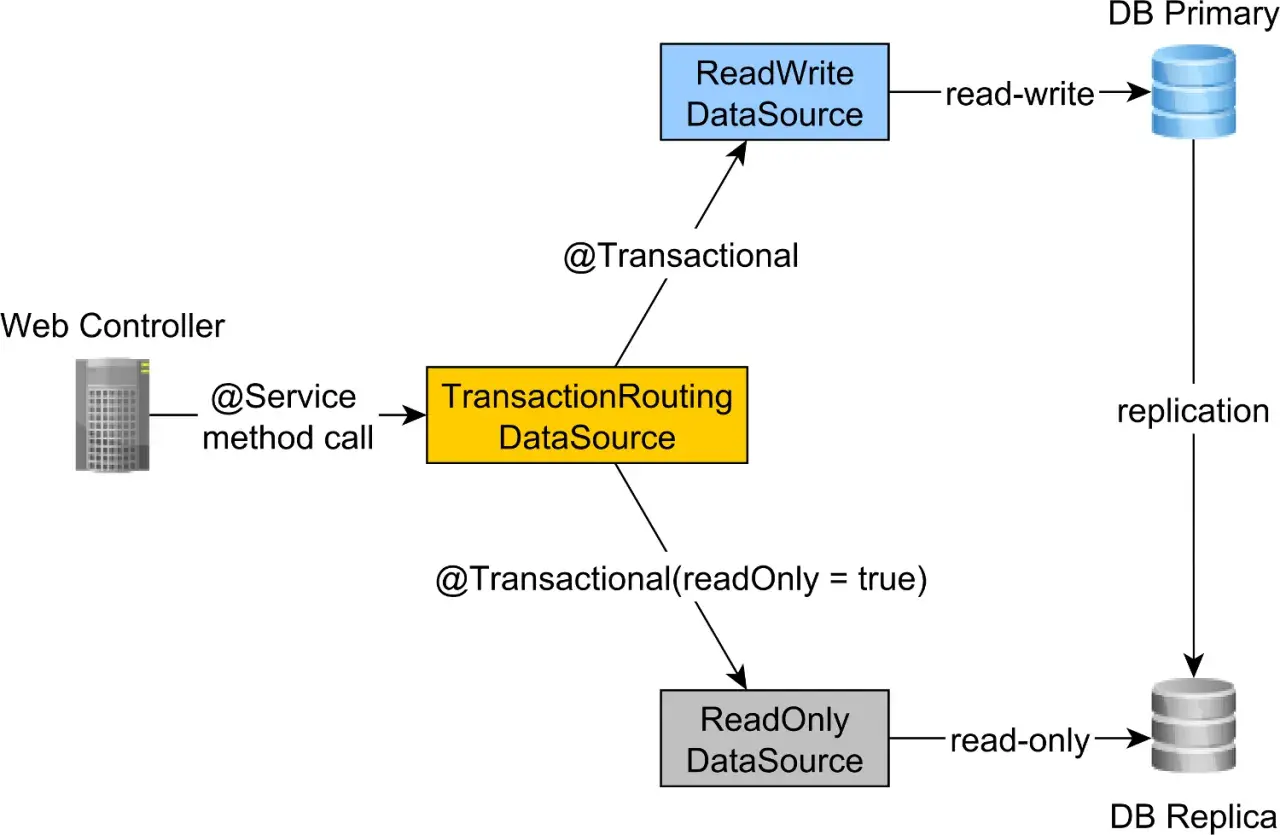
Oddzielne bazy danych przydają się wtedy, gdy charakter ruchu jest naprawdę różny. Przykładowo system może przyjmować niewiele poleceń zmieniających dane, ale obsługiwać tysiące odczytów katalogu lub panelu analitycznego. Wtedy model odczytu można zoptymalizować pod wyszukiwanie, cache albo konkretny typ raportu.
Trzeba zaakceptować konsekwencję takiej architektury. Jeżeli zapis publikuje zdarzenie, a osobny proces aktualizuje projekcję, użytkownik może przez krótki czas zobaczyć stary stan danych. To tak zwana eventual consistency, czyli spójność osiągana z opóźnieniem.
Kiedy CQRS daje realną przewagę
Najlepiej sprawdza się tam, gdzie zapis i odczyt mają wyraźnie inne potrzeby. Dobrym przykładem jest system zamówień. Złożenie zamówienia może wymagać sprawdzenia ceny, dostępności, rabatów, limitów klienta i statusu płatności, podczas gdy ekran historii zamówień potrzebuje tylko kilku gotowych pól.
Podobnie wygląda sytuacja w systemie finansowym, platformie logistycznej albo aplikacji z rozbudowanym procesem akceptacji. Im więcej reguł i wyjątków po stronie zapisu, tym większą wartość daje model, który nie miesza ich z kodem raportowym.
CQRS może być dobrym wyborem, gdy spełnione są przynajmniej niektóre z poniższych warunków:
- odczytów jest znacznie więcej niż operacji zmieniających dane,
- różne ekrany potrzebują zupełnie innych kształtów danych,
- model domenowy zawiera ważne reguły i nie powinien być używany jako DTO,
- konieczne jest niezależne skalowanie zapisu i odczytu,
- raportowanie obciąża bazę transakcyjną,
- zdarzenia biznesowe mają znaczenie dla innych procesów.
Moim zdaniem szczególnie istotny jest ostatni punkt. Jeżeli po zmianie statusu zamówienia trzeba zaktualizować magazyn, wysłać wiadomość i przeliczyć raport, zdarzenie domenowe może uporządkować te reakcje. Nie oznacza to jednak automatycznie konieczności wdrażania Event Sourcingu. CQRS i Event Sourcing to różne wzorce. Pierwszy rozdziela odczyt i zapis, drugi przechowuje historię zmian jako strumień zdarzeń.
Koszty i pułapki, o których łatwo zapomnieć
Rozdzielenie modeli zwiększa liczbę elementów, które trzeba utrzymywać. Pojawiają się osobne komendy, zapytania, handlery, DTO, mapowania, testy i czasem procesy synchronizujące. Przy prostym formularzu administracyjnym taki narzut może być większy niż problem, który próbujesz rozwiązać.
Najpoważniejszym ryzykiem jest pozorna architektura. Zespół tworzy klasy CreateProductCommand i GetProductQuery, ale obie wywołują ten sam serwis CRUD, pracują na tej samej encji i nie dają żadnej niezależności. Samo nazwanie klas komendami nie przynosi korzyści. Podział powinien chronić różne odpowiedzialności, a nie tylko zmieniać nazwy plików.
Przy osobnych modelach odczytu trzeba dodatkowo obsłużyć:
- opóźnienia w propagacji zmian,
- ponowne przetwarzanie zdarzeń bez duplikowania skutków,
- kolejność zdarzeń i konflikty aktualizacji,
- odbudowę projekcji po zmianie jej struktury,
- monitorowanie kolejek, błędów i nieprzetworzonych komunikatów.
W praktyce szczególnie często pomija się idempotencję. Handler idempotentny może bezpiecznie obsłużyć tę samą wiadomość więcej niż raz. Bez tego ponowiona wiadomość może dwukrotnie naliczyć opłatę, wysłać podwójne powiadomienie albo utworzyć dwa identyczne rekordy.
Nie wprowadzałbym pełnego CQRS do prostego katalogu produktów, panelu słowników czy niewielkiej aplikacji z kilkoma tabelami. W takich miejscach klasyczny CRUD z dobrze rozdzielonymi warstwami jest zwykle tańszy, prostszy i wystarczająco skalowalny.
Jak wdrażać CQRS bez przebudowy całego systemu
Najbezpieczniej zacząć od jednego fragmentu domeny, w którym problem jest widoczny. Nie przenosiłbym całej aplikacji do CQRS tylko dlatego, że wzorzec dobrze wygląda na diagramie. Wybierz proces z trudnymi regułami zapisu albo odczytem, który wymaga kosztownych zapytań i wielu wyjątków.
- Oddziel operacje zapisu od odczytu na poziomie klas i interfejsów.
- Zdefiniuj komendy językiem biznesowym, zamiast kopiować nazwy tabel.
- Przenieś reguły zmian do agregatu lub serwisu domenowego.
- Utwórz osobne DTO dla najważniejszych widoków.
- Zoptymalizuj zapytania niezależnie od modelu zapisu.
- Dopiero później oceń, czy potrzebujesz osobnej bazy lub komunikacji asynchronicznej.
Przy takim podejściu możesz zachować jedną transakcję i jeden magazyn danych, a mimo to uzyskać większość korzyści organizacyjnych. Dopiero pomiary pokażą, czy problemem jest baza transakcyjna, koszt projekcji, czas odpowiedzi, czy może źle zaprojektowana logika biznesowa.
W systemie .NET zacząłbym od prostego podziału katalogów, na przykład Features/Orders/Commands oraz Features/Orders/Queries. Taki układ jest czytelniejszy niż globalne foldery Services i Repositories, w których po kilku miesiącach trudno znaleźć kod odpowiedzialny za konkretny przypadek użycia.
Dobrze jest też mierzyć osobno czas obsługi komend i zapytań, liczbę błędów oraz opóźnienie synchronizacji projekcji. Bez tych danych łatwo uznać, że CQRS poprawił system, choć w rzeczywistości tylko zwiększył liczbę abstrakcji.
Najrozsądniejszy punkt startu dla projektu .NET
Jeżeli aplikacja ma prostą domenę i głównie wykonuje operacje CRUD, zacznij od czytelnego kodu i dobrych zapytań. CQRS wprowadź dopiero tam, gdzie różnica między zapisem a odczytem jest praktycznym problemem, a nie jedynie ciekawą koncepcją architektoniczną.
W większości zespołów najlepszą pierwszą wersją będzie lekki wariant z jednym magazynem danych, osobnymi command handlerami, query handlerami i DTO. Pozwala on sprawdzić, czy rozdzielenie faktycznie pomaga, bez dokładania od razu brokerów, replikacji i obsługi opóźnionej spójności.
Najważniejsza decyzja nie brzmi więc „czy użyć CQRS w całej aplikacji”, lecz „w którym fragmencie systemu osobne modele rozwiążą konkretny problem”. Takie podejście ogranicza ryzyko, ułatwia pomiary i zostawia drogę do późniejszego skalowania bez kosztownej rewolucji.