Jedno zapytanie do bazy trwa 80 ms, ale powtarzane kilka tysięcy razy na minutę potrafi zdominować cały budżet opóźnień aplikacji. Pamięć podręczna in-memory, określana też angielskim terminem in memory cache, pozwala przechowywać często używane dane w RAM i zwracać je znacznie szybciej niż z bazy lub zewnętrznego API. Pokażę, jak działa ten mechanizm, jak wdrożyć go w .NET, kiedy wybrać Redis oraz jak uniknąć niespójności i lawiny żądań po wygaśnięciu wpisu.
Najważniejsze decyzje przy projektowaniu cache
- RAM daje bardzo szybki odczyt, ale dane znikają po restarcie procesu.
- Cache-aside sprawdza cache, pobiera brakujące dane ze źródła i zapisuje je na później.
- IMemoryCache pasuje głównie do jednej instancji aplikacji lub danych lokalnych.
- Redis jest lepszy, gdy wiele instancji musi współdzielić te same wpisy.
- TTL i unieważnianie decydują o tym, czy użytkownik zobaczy aktualne dane.
Czym naprawdę jest pamięć podręczna in-memory
Cache to pomocnicza kopia danych przechowywana bliżej kodu, który ich potrzebuje. W wariancie in-memory wartości trafiają do pamięci procesu aplikacji, więc odczyt nie wymaga połączenia z bazą, siecią ani deserializacji odpowiedzi z zewnętrznego systemu. Zysk bywa bardzo duży, ale pod jednym warunkiem: cache nie może być jedynym źródłem prawdy.
Najlepiej przechowywać w nim dane, które są często odczytywane, stosunkowo rzadko zmieniane i kosztowne do wygenerowania. Dobrym przykładem jest konfiguracja funkcjonalna, lista kategorii, uprawnienia obliczane na podstawie kilku tabel, kursy walut albo wynik zapytania do wolnego API.
Trzeba pamiętać, że pamięć procesu jest lokalna. Restart aplikacji, wdrożenie nowej wersji, awaria kontenera lub zakończenie procesu usuwa wszystkie wpisy. Z tego powodu traktuję cache jak akcelerator dostępu do danych, a nie jak bazę danych.
Cache lokalny a cache współdzielony
W jednej instancji aplikacji każdy odczyt trafia do tej samej pamięci. Problem pojawia się po skalowaniu horyzontalnym. Jeśli działają trzy instancje API, każda ma własny cache, własny zestaw wpisów i własny moment wygaśnięcia danych.
| Cecha | Cache lokalny w RAM | Cache rozproszony |
|---|---|---|
| Opóźnienie | Najniższe, bez komunikacji sieciowej | Nieco wyższe, bo potrzebuje sieci |
| Zasięg danych | Jedna instancja procesu | Wspólny dla wielu instancji |
| Restart aplikacji | Usuwa wpisy | Nie musi usuwać wpisów |
| Skalowanie | Dobre dla pojedynczego serwera | Lepsze dla farmy aplikacji |
| Koszt operacyjny | Minimalny | Wymaga dodatkowej usługi |
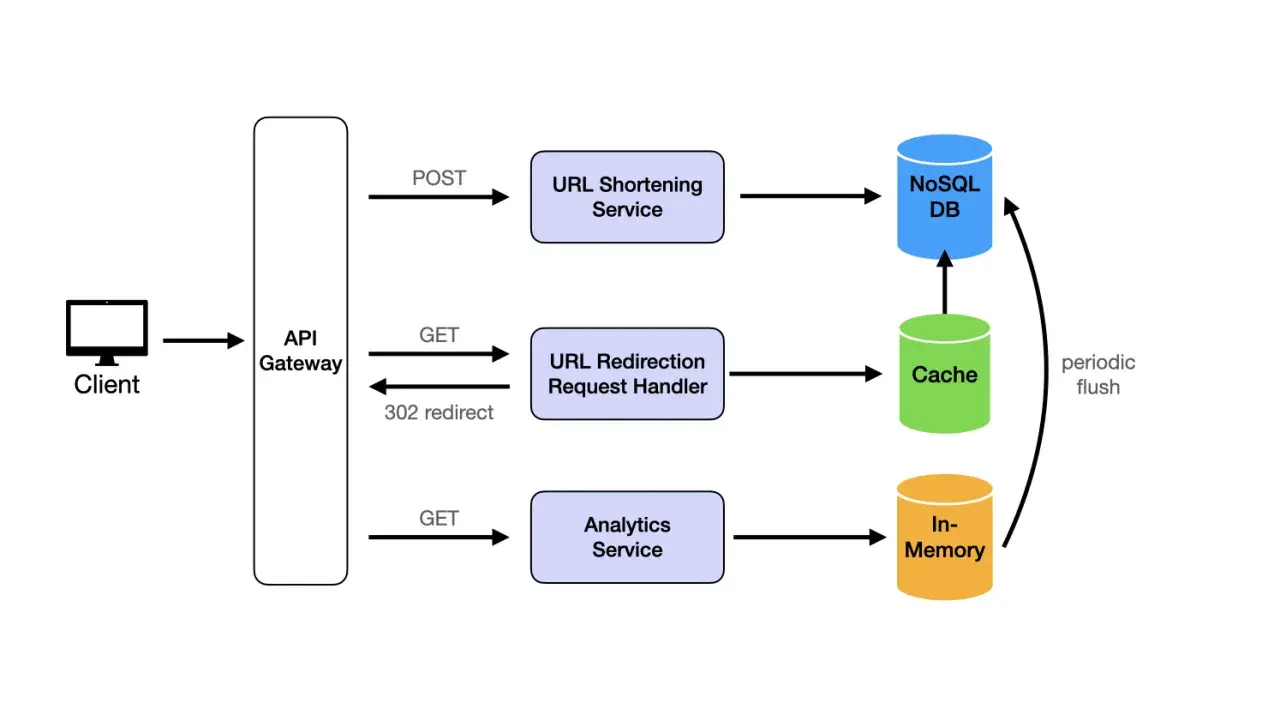
W praktyce często sprawdza się układ dwupoziomowy. Najczęściej używane dane trafiają do szybkiego cache lokalnego, a wspólna kopia znajduje się w Redisie. Taka architektura ogranicza liczbę połączeń sieciowych, ale wymaga świadomego zarządzania niespójnością między poziomami.
Jak działa wzorzec cache-aside
Najbardziej uniwersalnym sposobem korzystania z cache jest wzorzec cache-aside. Kod aplikacji sam sprawdza, czy dane istnieją w pamięci. Jeśli nie, pobiera je ze źródła, zapisuje w cache i zwraca wynik.
- Aplikacja buduje stabilny klucz cache.
- Próbuje odczytać wartość z pamięci.
- Przy trafieniu, czyli cache hit, zwraca dane bez kontaktu z bazą.
- Przy braku, czyli cache miss, pobiera dane ze źródła.
- Zapisuje wynik z określonym czasem życia.
W prostym przypadku przepływ może wyglądać tak:
var key = $"product:{productId}";

if (!_cache.TryGetValue(key, out ProductDto? product))
{
    product = await _repository.GetAsync(productId);

    if (product is not null)
    {
        _cache.Set(key, product, TimeSpan.FromMinutes(5));
    }
}

return product;
Sam wzorzec jest prosty, ale najwięcej decyzji kryje się w szczegółach. Klucz powinien zawierać typ danych, identyfikator oraz elementy wpływające na wynik, na przykład język, wersję konfiguracji lub identyfikator użytkownika. Klucz product:42:pl jest bezpieczniejszy niż samo 42, bo nie pomyli produktu z zamówieniem lub profilem.
Co zrobić po zmianie danych
Po aktualizacji rekordu trzeba usunąć albo odświeżyć powiązany wpis. Najprostsza strategia to zapis do bazy, a potem usunięcie klucza z cache. Kolejne żądanie pobierze już świeżą wartość.
Nie zawsze da się unieważnić wszystkie zależności. Jeśli zmiana produktu wpływa na listę bestsellerów, stronę kategorii i rekomendacje, można zastosować krótszy TTL, wersjonowanie kluczy albo publikowanie zdarzeń o zmianie. Im więcej zależności, tym mniej atrakcyjne staje się ręczne kasowanie pojedynczych kluczy.
IMemoryCache w aplikacji .NET
W ASP.NET Core najwygodniejszym punktem startowym jest interfejs IMemoryCache z pakietu Microsoft.Extensions.Caching.Memory. Integruje się z wbudowanym mechanizmem dependency injection i pozwala przechowywać bezpośrednio obiekty .NET, bez ręcznej serializacji.
builder.Services.AddMemoryCache();

public sealed class ProductService
{
    private readonly IMemoryCache _cache;
    private readonly IProductRepository _repository;

    public ProductService(
        IMemoryCache cache,
        IProductRepository repository)
    {
        _cache = cache;
        _repository = repository;
    }

    public async Task GetAsync(
        int productId,
        CancellationToken cancellationToken)
    {
        var key = $"product:{productId}";

        return await _cache.GetOrCreateAsync(
            key,
            async entry =>
            {
                entry.AbsoluteExpirationRelativeToNow =
                    TimeSpan.FromMinutes(10);

                return await _repository.GetAsync(
                    productId,
                    cancellationToken);
            });
    }
}
Wpis powinien mieć co najmniej jeden konkretny mechanizm wygasania. Absolute expiration usuwa dane po określonym czasie niezależnie od częstotliwości odczytu. Sliding expiration przedłuża życie wpisu przy każdym użyciu, więc dobrze obsługuje dane często czytane, ale może utrzymywać nieaktualną wartość znacznie dłużej, niż zakładaliśmy.
Najczęściej łączę oba ustawienia. Przykładowo wpis może wygasać po 5 minutach bez odczytu, ale nigdy nie żyć dłużej niż 30 minut. To ogranicza ryzyko, że popularny element pozostanie w pamięci bez końca.
Rozmiar pamięci i priorytet wpisów
Duży obiekt przechowywany setki razy może zużyć więcej RAM-u niż sama baza, którą miał odciążać. Dlatego cache powinien mieć limit pojemności albo przynajmniej limitować rozmiar pojedynczych wpisów. Warto także ustawić priorytety, aby dane pomocnicze były usuwane przed elementami trudniejszymi do odtworzenia.
Nie zapisuję bez kontroli całych encji z Entity Framework. Częściej tworzę mniejsze DTO zawierające tylko pola potrzebne w danym scenariuszu. Zmniejsza to zużycie pamięci i ogranicza ryzyko przypadkowego przechowania danych, których nie powinno być w warstwie cache.
Lawina żądań po wygaśnięciu
Jeśli popularny wpis wygaśnie, wiele równoległych żądań może jednocześnie uznać go za brakujący i uderzyć do bazy. To zjawisko nazywa się cache stampede. Przy dużym ruchu cache, który zwykle chroni bazę, może nagle stać się źródłem przeciążenia.
W krytycznych miejscach stosuję mechanizm single-flight, czyli blokadę ograniczającą jednoczesne odtwarzanie tego samego klucza do jednego żądania. Pozostałe żądania czekają na wynik zamiast wykonywać identyczne zapytanie. Przy wielu instancjach aplikacji lokalna blokada nie wystarczy, bo każda instancja ma własny proces. Wtedy potrzebny jest mechanizm współdzielony albo biblioteka zapewniająca ochronę przed stampede.
Kiedy IMemoryCache przestaje wystarczać
Lokalny cache jest rozsądnym wyborem, gdy aplikacja działa na jednej instancji albo gdy różnice między kopiami danych są akceptowalne. Dobrze sprawdza się też jako krótkotrwały cache danych specyficznych dla konkretnego procesu, na przykład metadanych używanych przez model AI lub wyników kosztownej transformacji.
Przy wielu instancjach zwykle wybieram Redis jako cache rozproszony. Każdy serwer może wtedy odczytywać te same wpisy, a restart pojedynczej instancji nie powoduje całkowitego opróżnienia warstwy cache. Ceną jest dodatkowa usługa, ruch sieciowy, serializacja oraz konieczność monitorowania połączeń.
W Azure można użyć zarządzanej usługi Redis, która nadaje się także do sesji, blokad i prostych struktur danych. Nie traktowałbym jednak Redis jako automatycznej kopii bazy. Nadal trzeba określić TTL, reakcję na niedostępność usługi oraz zachowanie aplikacji po utracie wpisów.
Pułapką jest nazwa AddDistributedMemoryCache. Mimo słowa „distributed” nie tworzy ona wspólnego cache dla wielu serwerów. Przechowuje dane w pamięci konkretnej instancji, dlatego nadaje się głównie do testów, developmentu albo prostego wdrożenia na jednym serwerze.
Błędy, które najczęściej psują caching
Brak strategii świeżości
Sam czas wygaśnięcia nie odpowiada na pytanie, jak długo dane mogą być nieaktualne. Dla listy kategorii 15 minut może być bez znaczenia, ale dla ceny produktu lub limitu użytkownika taki okres może być zbyt długi. TTL powinien wynikać z tolerancji biznesowej, a nie z przypadkowej wartości skopiowanej z innego projektu.
Przechowywanie danych wrażliwych bez kontroli
Pamięć procesu nie jest magicznie bezpieczna tylko dlatego, że nie widać jej w bazie. Nie umieszczałbym w cache haseł, pełnych tokenów, danych kart ani informacji, których aplikacja nie potrzebuje do obsługi kolejnego żądania. Szczególną ostrożność zachowuję przy kluczach zawierających identyfikatory użytkowników.
Brak obsługi awarii źródła
Cache miss może wystąpić w dowolnym momencie. Jeśli baza lub API jest niedostępne, aplikacja powinna zwrócić kontrolowany błąd, użyć krótkotrwałej wartości awaryjnej albo skorzystać z mechanizmu stale-while-revalidate. Nie wolno zakładać, że obecność wpisu w cache jest gwarantowana.
Przeczytaj również: Projektowanie obiektowe w C# bez nadmiarowej komplikacji
Nieczytelne klucze
Klucze budowane przypadkowo szybko prowadzą do kolizji i trudnego debugowania. Przyjmuję konwencję z nazwą domeny, identyfikatorem oraz wersją schematu, na przykład catalog:v2:product:42:pl. Wersja jest przydatna po zmianie formatu DTO, bo pozwala rozpocząć zapełnianie nowego cache bez ryzyka odczytu starych danych.
Jak sprawdzić, czy cache rzeczywiście pomaga
Wdrożenie cache bez pomiarów często kończy się przechowywaniem danych, które prawie nigdy nie są ponownie odczytywane. Monitorowałbym co najmniej hit rate, czyli odsetek trafień, liczbę cache miss, czas odczytu, rozmiar wpisów oraz liczbę zapytań do źródła.
- Hit rate pokazuje, czy cache odpowiada na realny ruch.
- Miss rate pomaga wykryć zbyt krótki TTL lub złe klucze.
- Rozmiar pamięci ostrzega przed presją na garbage collector.
- Opóźnienie P95 i P99 pokazuje wpływ cache na najwolniejsze żądania.
- Liczba odtworzeń wpisów pozwala wykryć stampede.
Sam wysoki hit rate nie gwarantuje sukcesu. Jeśli cache trafia w 99% przypadków, ale przechowuje ogromne obiekty i powoduje częste kolekcje pamięci, wynik może być gorszy niż bez cache. Patrzę więc równocześnie na czas odpowiedzi, obciążenie źródła i zużycie RAM-u.
Przed wdrożeniem testuję trzy scenariusze: zimny start bez żadnych wpisów, równoległe żądania po wygaśnięciu popularnego klucza oraz restart instancji. Te trzy sytuacje szybko pokazują, czy rozwiązanie jest odporne na rzeczywiste zachowanie produkcji.
Cache powinien przyspieszać system, a nie go zastępować
Najbezpieczniejszy punkt wyjścia to cache-aside, krótki i uzasadniony TTL, stabilne klucze oraz możliwość odtworzenia każdej wartości ze źródła. IMemoryCache wybieram dla danych lokalnych i bardzo szybkich odczytów, a cache rozproszony wtedy, gdy aplikacja działa na wielu instancjach albo potrzebuje wspólnego stanu.
Jeżeli nie potrafię powiedzieć, co stanie się po wygaśnięciu wpisu, restarcie procesu lub awarii Redis, projekt cache nie jest jeszcze gotowy. Dobrze zaprojektowana pamięć podręczna pozostaje niewidoczna dla użytkownika, ale wyraźnie widoczna w metrykach: obniża opóźnienia, zmniejsza obciążenie źródeł i zachowuje przewidywalne zachowanie pod obciążeniem.