Gdy aplikacja w Pythonie zaczyna rosnąć, proste funkcje szybko zamieniają się w trudny do zmiany splot zależności. W tym artykule pokazuję, jak dobierać wzorce projektowe w Pythonie, kiedy lepiej użyć funkcji, protokołu lub dekoratora, a kiedy pełnego obiektu, oraz jak przełożyć te decyzje na architekturę łatwą do testowania i rozwijania.
Najważniejsze decyzje przy stosowaniu wzorców w Pythonie
- Nie kopiuj wzorców z Javy bez uwzględnienia dynamiki i idiomów Pythona.
- Strategia, fabryka, adapter i dekorator rozwiązują większość typowych problemów w aplikacjach.
- Kompozycja zwykle daje prostszy kod niż rozbudowane hierarchie dziedziczenia.
- Dataclasses, Protocol i funkcje wyższego rzędu często zastępują klasy wymagane w innych językach.
- Wzorzec nie jest celem. Ma obniżać koszt zmiany kodu, a nie imponować nazwą.
Po co stosować wzorce projektowe w Pythonie
Wzorzec projektowy to sprawdzony sposób organizowania kodu wokół powtarzalnego problemu. Nie jest gotową biblioteką ani fragmentem do bezmyślnego skopiowania. To raczej nazwany kompromis projektowy, który ułatwia rozmowę o kodzie i pozwala szybciej ocenić konsekwencje konkretnej decyzji.
Python daje tu dużą swobodę. Funkcje są obiektami pierwszej klasy, dekoratory pozwalają owijać zachowanie, a moduły mogą pełnić rolę prostych przestrzeni nazw i fabryk. Z mojego doświadczenia wynika, że najczęstszy błąd polega na przenoszeniu wzorców jeden do jednego z języków, w których trzeba pisać znacznie więcej kodu pomocniczego.
Dobrze dobrany wzorzec pomaga odseparować zmienny fragment aplikacji. Dzięki temu wymiana dostawcy płatności, sposobu logowania czy algorytmu filtrowania nie wymaga przepisywania całego systemu. Źle dobrany wzorzec robi odwrotnie i dodaje warstwę abstrakcji bez realnej korzyści.
Trzy grupy wzorców
| Grupa | Główny problem | Przykłady |
|---|---|---|
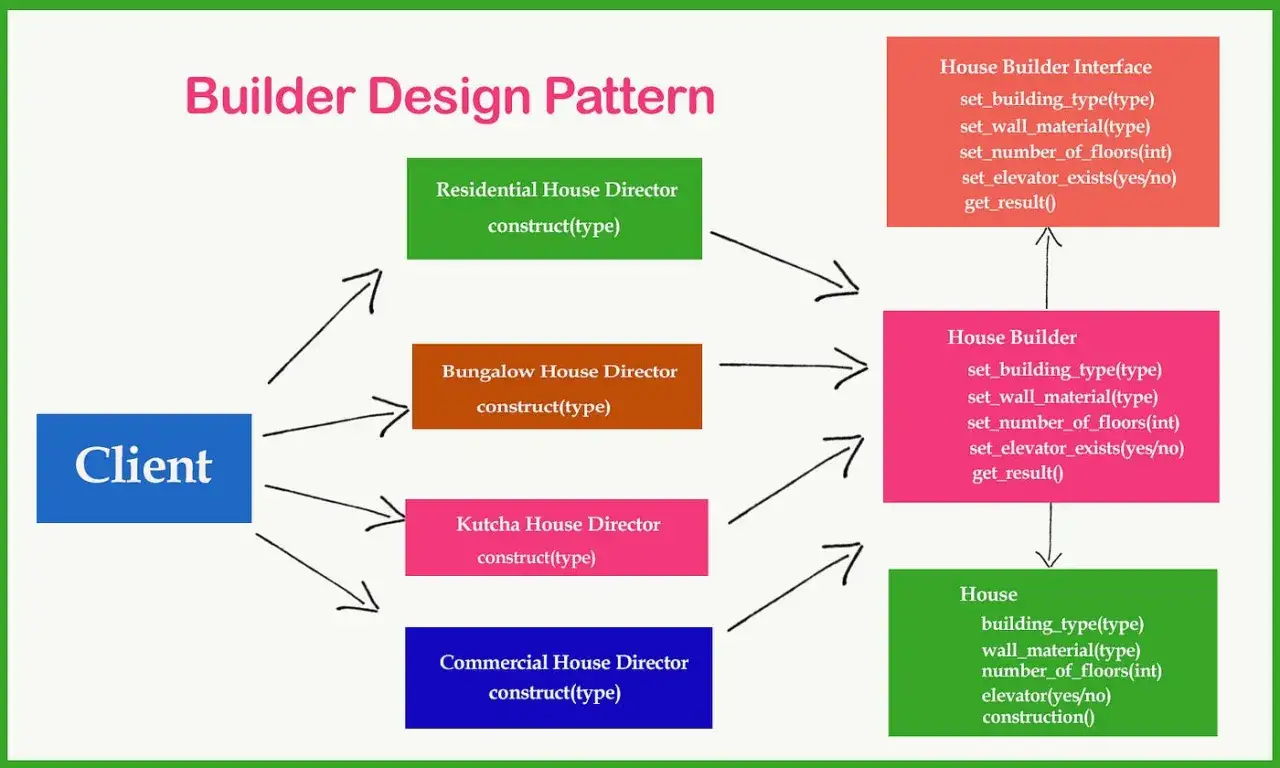
| Kreacyjne | Tworzenie obiektów i zarządzanie ich konfiguracją | Factory Method, Abstract Factory, Builder |
| Strukturalne | Łączenie klas, funkcji i zewnętrznych interfejsów | Adapter, Fasada, Dekorator, Proxy |
| Behawioralne | Organizacja współpracy i przepływu odpowiedzialności | Strategy, Observer, Command, State |
Osobno trzeba traktować wzorce architektoniczne, takie jak architektura warstwowa, heksagonalna czy oparta na zdarzeniach. One opisują większy podział systemu, a nie tylko relację między kilkoma klasami. W praktycznym projekcie oba poziomy często się uzupełniają.
Pythonic podejście do klasycznych wzorców
W Pythonie warto zacząć od pytania, czy problem naprawdę wymaga klasy. Jeśli potrzebuję podmieniać algorytm, często wystarczy funkcja przekazana jako argument. Jeżeli chcę opisać kontrakt dla kilku implementacji, użyję typing.Protocol, ponieważ pozwala sprawdzać zgodność interfejsu bez wymuszania dziedziczenia.
from collections.abc import Callable

def nalicz_cene(kwota: float, rabat: Callable[[float], float]) -> float:
    return rabat(kwota)

def rabat_staly(kwota: float) -> float:
    return kwota * 0.9

def rabat_dla_firm(kwota: float) -> float:
    return kwota * 0.8

cena = nalicz_cene(100.0, rabat_dla_firm)
To jest praktyczna wersja wzorca Strategia. Zamiast budować abstrakcyjną klasę bazową i kilka klas potomnych, przekazujemy zachowanie wprost. Taki kod jest krótszy, łatwy do testowania i naturalny dla Pythona, szczególnie gdy strategie nie przechowują własnego stanu.
Klasa nadal ma sens, gdy strategia ma konfigurację, zależności albo kilka powiązanych metod. Nie traktuję więc funkcji jako dogmatu. Granicą jest czytelność: jeśli anonimowe funkcje zaczynają tworzyć skomplikowane zamknięcia, nazwana klasa może okazać się prostszym miejscem na reguły biznesowe.
Dataclass jako prosty obiekt danych
Do obiektów przechowujących konfigurację lub wynik operacji dobrze pasuje dekorator @dataclass. Ogranicza liczbę metod technicznych, takich jak konstruktor czy reprezentacja tekstowa, ale nie odbiera możliwości dodania własnego zachowania.
from dataclasses import dataclass

@dataclass(frozen=True)
class KonfiguracjaRaportu:
    format: str
    jezyk: str
    wyslij_email: bool = False

konfiguracja = KonfiguracjaRaportu(
    format="pdf",
    jezyk="pl",
    wyslij_email=True,
)
Parametr frozen=True sprawia, że obiekt jest niemutowalny po utworzeniu. W konfiguracji i komunikatach domenowych zmniejsza to ryzyko przypadkowej zmiany wartości w trakcie działania programu.
Strategia i fabryka w codziennym kodzie
Strategia przydaje się wtedy, gdy jeden proces może działać na kilka sposobów. Typowe przykłady to formatowanie raportu, naliczanie prowizji, wybór dostawcy AI, walidacja danych lub komunikacja z różnymi systemami. Najważniejsza korzyść polega na tym, że kod wykonujący proces nie zna szczegółów algorytmu.
from typing import Protocol

class Eksporter(Protocol):
    def eksportuj(self, dane: list[dict]) -> bytes:
        ...

class EksporterCsv:
    def eksportuj(self, dane: list[dict]) -> bytes:
        naglowek = ",".join(dane[0].keys())
        wiersze = [",".join(str(wartosc) for wartosc in rekord.values())
                   for rekord in dane]
        return ("\n".join([naglowek, *wiersze])).encode()

def zapisz_raport(dane: list[dict], eksporter: Eksporter) -> None:
    plik = eksporter.eksportuj(dane)
    with open("raport.bin", "wb") as uchwyt:
        uchwyt.write(plik)
Protocol opisuje wymagane zachowanie, ale klasa nie musi po nim dziedziczyć. To strukturalne typowanie, czyli podejście, w którym liczy się obecność odpowiednich metod, a nie formalne pochodzenie obiektu.
Fabryka rozwiązuje inny problem. Ukrywa sposób tworzenia konkretnej implementacji, na przykład wybór eksportera na podstawie konfiguracji. W prostym projekcie wystarczy słownik funkcji lub klas.
EKSPORTERY = {
    "csv": EksporterCsv,
    # "json": EksporterJson,
    # "pdf": EksporterPdf,
}

def utworz_eksporter(format_pliku: str) -> Eksporter:
    try:
        return EKSPORTERY[format_pliku]()
    except KeyError as blad:
        raise ValueError(f"Nieznany format: {format_pliku}") from blad
Nie budowałbym osobnej hierarchii fabryk dla dwóch formatów. To jeden z przypadków, w których rejestr klas lub funkcji jest wystarczający. Bardziej rozbudowana fabryka ma sens dopiero wtedy, gdy tworzenie obiektu wymaga walidacji, kilku zależności albo różnych zestawów konfiguracji.
Adapter, fasada i dekorator upraszczają integracje
Integracje z zewnętrznymi usługami często mają niewygodne nazwy metod, nietypowe formaty danych albo błędy specyficzne dla dostawcy. Adapter tłumaczy taki interfejs na formę, której oczekuje reszta aplikacji. Dzięki temu zmiana biblioteki lub dostawcy nie rozlewa się po całym kodzie.
class BramkarzPlatnosci:
    def obciaz(self, kwota: int, waluta: str) -> str:
        raise NotImplementedError

class ZewnetrznyOperator:
    def charge_customer(self, amount_in_grosze: int, currency_code: str) -> dict:
        return {"transaction_id": "tx-123"}

class AdapterOperatora(BramkarzPlatnosci):
    def __init__(self, operator: ZewnetrznyOperator) -> None:
        self.operator = operator

    def obciaz(self, kwota: int, waluta: str) -> str:
        wynik = self.operator.charge_customer(kwota, waluta)
        return wynik["transaction_id"]
Fasada jest podobna, ale jej cel jest szerszy. Udostępnia jeden prosty punkt wejścia do złożonego podsystemu, na przykład procesu składania zamówienia obejmującego magazyn, płatności i wysyłkę. Adapter tłumaczy jeden interfejs na drugi, a fasada porządkuje kilka operacji w wygodny scenariusz.
Dekorator pozwala dołożyć zachowanie bez modyfikowania funkcji bazowej. W Pythonie najczęściej występuje jako funkcja opatrzona dekoratorem z functools.wraps. Sprawdza się przy logowaniu, pomiarze czasu, cache, autoryzacji i ponawianiu prób.
from functools import wraps
from time import perf_counter
from collections.abc import Callable
from typing import Any

def mierz_czas(funkcja: Callable[..., Any]) -> Callable[..., Any]:
    @wraps(funkcja)
    def opakowana(*args: Any, **kwargs: Any) -> Any:
        start = perf_counter()
        wynik = funkcja(*args, **kwargs)
        czas = perf_counter() - start
        print(f"{funkcja.__name__}: {czas:.3f}s")
        return wynik

    return opakowana

@mierz_czas
def pobierz_dane() -> list[dict]:
    return []
W praktyce dekorator może łatwo ukryć istotne zachowanie. Nie owijałbym nim każdej funkcji tylko dlatego, że technicznie się da. Jeśli logika autoryzacji lub retry decyduje o wyniku biznesowym, jawna usługa bywa łatwiejsza do debugowania niż kilka warstw dekoratorów.
Wzorce behawioralne w architekturze aplikacji
Wzorce behawioralne pomagają ustalić, kto podejmuje decyzję i jak obiekty wymieniają informacje. W większych aplikacjach problemem rzadko jest samo utworzenie obiektu. Znacznie częściej trudność sprawia nadmiar zależności między elementami.
Command oddziela żądanie od wykonania
Command reprezentuje operację jako obiekt lub funkcję. Jest użyteczny, gdy działanie ma być kolejkowane, logowane, cofane albo wykonywane później. W systemie obsługującym zamówienia komenda może zawierać identyfikator klienta, pozycje i metadane, a osobny handler zajmie się wykonaniem.
from dataclasses import dataclass

@dataclass(frozen=True)
class UtworzZamowienie:
    klient_id: int
    produkty: tuple[int, ...]

class HandlerZamowienia:
    def obsluz(self, komenda: UtworzZamowienie) -> int:
        # walidacja, zapis i publikacja zdarzenia
        return 42
Taki podział dobrze współgra z kolejkami i przetwarzaniem asynchronicznym. Trzeba jednak pamiętać o idempotencji, czyli możliwości bezpiecznego powtórzenia tej samej operacji. Sam wzorzec Command nie chroni przed podwójnym utworzeniem zamówienia.
Przeczytaj również: Architektura monolityczna w .NET - kiedy ma sens?
Observer i zdarzenia wymagają umiaru
Observer pozwala powiadamiać wiele odbiorców o zmianie stanu. W Pythonie można go zrealizować przez listę callbacków, sygnały frameworka albo broker wiadomości. Dobrze działa przy powiadomieniach, audycie i integracjach, ale zwiększa pośredniość przepływu.
Jeżeli po zapisaniu użytkownika uruchamia się pięć ukrytych reakcji, szybkie znalezienie źródła problemu staje się trudne. Dlatego w małej aplikacji wolę jawnie wywołać usługę, a zdarzenia stosować tam, gdzie niezależność odbiorców rzeczywiście daje wartość.
Jak połączyć wzorce z architekturą aplikacji
Wzorce klasowe nie zastępują architektury. Mogą jednak pomóc w utrzymaniu granic między domeną, przypadkami użycia i infrastrukturą. W aplikacji warstwowej logika biznesowa nie powinna zależeć bezpośrednio od klienta HTTP, sterownika bazy danych ani konkretnego dostawcy modelu AI.
Praktyczny podział może wyglądać następująco:
- Warstwa domeny zawiera reguły biznesowe i proste obiekty wartości.
- Warstwa aplikacji koordynuje przypadki użycia, transakcje i komendy.
- Warstwa infrastruktury implementuje repozytoria, adaptery API i zapis danych.
- Warstwa wejścia obsługuje HTTP, CLI, zadania cykliczne lub komunikaty z kolejki.
W takim układzie repozytorium może być opisane przez protokół, a jego implementacja może korzystać z PostgreSQL, pliku lub pamięci testowej. To odmiana odwrócenia zależności: kod aplikacji definiuje potrzebne zachowanie, a infrastruktura dostarcza konkretną realizację.
from typing import Protocol

class RepozytoriumUzytkownikow(Protocol):
    def znajdz(self, identyfikator: int) -> dict | None:
        ...

class PobierzProfil:
    def __init__(self, repozytorium: RepozytoriumUzytkownikow) -> None:
        self.repozytorium = repozytorium

    def wykonaj(self, identyfikator: int) -> dict:
        uzytkownik = self.repozytorium.znajdz(identyfikator)
        if uzytkownik is None:
            raise ValueError("Użytkownik nie istnieje")
        return uzytkownik
Takie podejście jest szczególnie przydatne w testach. Test przypadku użycia może otrzymać atrapę repozytorium bez uruchamiania bazy danych. Nie oznacza to jednak, że każdą funkcję trzeba obudować interfejsem. Abstrakcja ma sens wtedy, gdy spodziewamy się wymiany zależności albo potrzebujemy izolacji testów.
W projektach korzystających z Azure, modeli językowych czy zewnętrznych API adapter jest często rozsądniejszy niż wywoływanie SDK w wielu miejscach. Kod domenowy operuje wtedy na własnym modelu danych, a szczegóły limitów, autoryzacji i formatu odpowiedzi zostają na brzegu systemu.
Popularne błędy przy wdrażaniu wzorców
Najbardziej znanym przykładem jest Singleton. W Pythonie moduł już zachowuje się jak współdzielona instancja, więc ręczne blokowanie tworzenia kolejnych obiektów zwykle komplikuje testy. Zamiast Singletona częściej przekazuję jedną instancję przez konstruktor, czyli stosuję jawne wstrzykiwanie zależności.
Drugim problemem jest przedwczesna abstrakcja. Dwie podobne funkcje nie zawsze oznaczają potrzebę wspólnej klasy bazowej. Najpierw sprawdzam, czy zmienność jest realna, a dopiero później wydzielam strategię, fabrykę lub adapter.
Trzeci błąd to nadmierne dziedziczenie. Głęboka hierarchia klas utrudnia zrozumienie, skąd bierze się konkretne zachowanie. W większości przypadków wybieram kompozycję, małe obiekty i przekazywanie zależności, bo taki układ łatwiej modyfikować bez efektów ubocznych.
| Problem | Lepszy pierwszy krok |
|---|---|
| Wiele wariantów algorytmu | Funkcja jako strategia albo mała klasa strategii |
| Różne implementacje tego samego kontraktu | Protocol i wstrzykiwanie zależności |
| Niewygodne zewnętrzne API | Adapter na granicy systemu |
| Złożone tworzenie obiektów | Fabryka lub rejestr konstruktorów |
| Współdzielony stan globalny | Jawnie przekazana usługa lub zależność |
Przed wdrożeniem wzorca zadaję sobie trzy pytania. Co będzie się zmieniać? Która część kodu powinna pozostać niezależna? Czy dodatkowe klasy skrócą przyszłą zmianę, czy tylko zwiększą liczbę miejsc do utrzymania?
Jak wybrać właściwy wzorzec bez komplikowania projektu
Najlepiej zacząć od konkretnej zmiany, którą aplikacja ma obsłużyć. Jeżeli chcesz wymieniać algorytm, rozważ Strategię. Jeżeli tłumaczysz zewnętrzne API, wybierz Adapter. Jeżeli tworzysz obiekty na podstawie konfiguracji, przyjrzyj się Fabryce. Gdy chcesz dodać logowanie lub cache bez zmiany funkcji, naturalnym kandydatem jest Dekorator.
Implementację warto zacząć od najmniejszego działającego wariantu. Najpierw jedna funkcja, jeden protokół albo jeden adapter. Dopiero gdy pojawi się drugi wariant lub rzeczywista potrzeba testowania granicy, rozbudowuj rozwiązanie.
Dobrym testem jakości jest próba usunięcia wzorca po kilku dniach. Jeśli po jego usunięciu kod staje się bardziej zrozumiały i nie tracisz elastyczności, abstrakcja prawdopodobnie była zbędna. Jeśli natomiast każda zmiana wymaga modyfikowania wielu niezależnych miejsc, wzorzec spełnia swoją rolę.
Najlepszy wzorzec to ten, który ułatwia następną zmianę
W Pythonie nie chodzi o odtworzenie całego katalogu klasycznych wzorców. Największą wartość daje połączenie prostych funkcji, kompozycji, protokołów, dataclass i małych adapterów z rozsądnym podziałem architektonicznym.
Na początku projektu wystarczy wybrać jeden problem, który rzeczywiście boli: wymianę dostawcy, testowanie bazy danych albo rosnącą liczbę wariantów algorytmu. Wtedy wzorzec staje się narzędziem, a nie ozdobą. I właśnie po tym poznaję dobrą architekturę: kolejna zmiana jest przewidywalna, lokalna i nie wymaga przebudowy całej aplikacji.