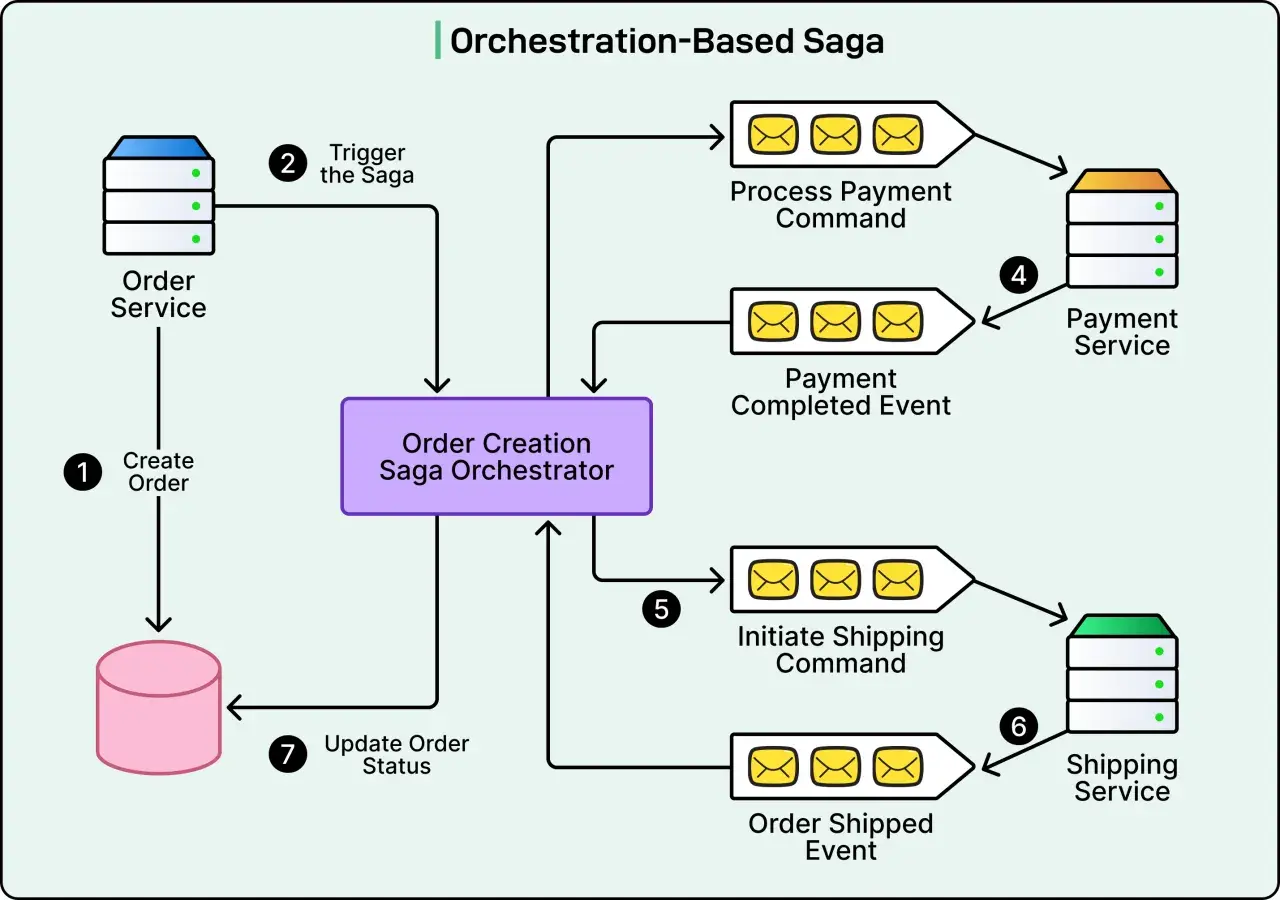
Gdy jedno zamówienie przechodzi przez płatność, magazyn i wysyłkę, klasyczna transakcja bazodanowa przestaje wystarczać. Każdy mikroserwis ma własne dane, a awaria jednego kroku nie może zostawić systemu w stanie, w którym klient zapłacił, ale zamówienie zniknęło. W tym artykule pokazuję, jak działa saga pattern, czym różnią się choreografia i orkiestracja oraz jak projektować kompensację, ponowienia i obserwowalność w aplikacjach .NET.
Spójność danych wymaga zarządzania stanem, a nie pozornego rollbacku
- Saga dzieli długi proces na lokalne transakcje wykonywane przez poszczególne mikroserwisy.
- Kompensacja odwraca skutki zakończonych kroków, ale nie jest technicznym rollbackiem jednej transakcji.
- Choreografia opiera się na zdarzeniach, natomiast orkiestracja korzysta z centralnego koordynatora.
- Idempotencja, outbox i retry decydują o tym, czy rozwiązanie będzie odporne na duplikaty i awarie komunikacji.
- Spójność ostateczna oznacza, że przez pewien czas różne usługi mogą widzieć różne stany tego samego procesu.
Na czym polega saga pattern w mikroserwisach
Saga pattern to sposób zarządzania procesem, który obejmuje kilka mikroserwisów i baz danych. Zamiast próbować objąć wszystkie operacje jedną transakcją rozproszoną, dzielimy workflow na lokalne transakcje. Każda z nich zmienia dane w jednym serwisie i uruchamia kolejny krok przez komunikat albo wywołanie usługi.
Przykładowa saga dla zakupu może składać się z utworzenia zamówienia, rezerwacji produktu, autoryzacji płatności i zlecenia wysyłki. Każda operacja może zakończyć się sukcesem lub błędem. Jeżeli wysyłka nie zostanie utworzona, system może anulować płatność i zwolnić rezerwację towaru.
Najważniejsza różnica względem transakcji ACID polega na tym, że nie ma jednego momentu, w którym wszystkie bazy danych zatwierdzają zmianę razem. System dąży do spójnego stanu końcowego, ale po drodze dopuszcza krótkotrwałą niespójność. To właśnie nazywamy spójnością ostateczną.
Kompensacja nie oznacza też magicznego przywrócenia poprzedniego stanu. Jeżeli płatność została zaksięgowana, jej cofnięcie może oznaczać nową operację finansową, a nie cofnięcie rekordu w bazie. W praktyce trzeba więc projektować osobne akcje kompensujące, takie jak anulowanie płatności, zwrot środków czy zwolnienie rezerwacji.
Jak działa saga na przykładzie zamówienia
Najłatwiej zrozumieć ten wzorzec, rozpisując proces biznesowy na konkretne stany. W systemie e-commerce nie wystarczy przechowywać wartości „zrealizowane” albo „niezrealizowane”. Potrzebne są stany pośrednie, które pokazują, na jakim etapie znajduje się proces.
-
Zamówienie zostaje utworzone ze statusem
Pending. - Magazyn rezerwuje produkty i potwierdza dostępność.
- Płatności autoryzują obciążenie klienta.
- Wysyłka tworzy zlecenie przekazania paczki kurierowi.
- Po sukcesie wszystkich kroków zamówienie otrzymuje status
Confirmed.
Jeżeli autoryzacja płatności zakończy się błędem, rezerwacja produktów powinna zostać zwolniona. Gdy problem pojawi się przy tworzeniu przesyłki, można anulować płatność i zwolnić towar. Kolejność kompensacji często biegnie w odwrotną stronę niż główny proces, ale nie zawsze jest to prosty mechaniczny rollback.
| Krok | Operacja lokalna | Możliwa kompensacja |
|---|---|---|
| 1 | Utworzenie zamówienia | Anulowanie zamówienia |
| 2 | Rezerwacja towaru | Zwolnienie rezerwacji |
| 3 | Autoryzacja płatności | Anulowanie autoryzacji lub zwrot |
| 4 | Utworzenie przesyłki | Anulowanie zlecenia wysyłki |
Ważne jest rozróżnienie między forward recovery i backward recovery. Pierwsze podejście próbuje ponowić nieudany krok, na przykład ponownie wysłać żądanie do dostawcy płatności. Drugie uruchamia kompensację i prowadzi proces do kontrolowanego stanu anulowania.
Nie każdy błąd powinien od razu uruchamiać kompensację. Chwilowa niedostępność usługi może wymagać kilku ponowień, a dopiero przekroczenie limitu prób powinno oznaczać porażkę sagi. Dlatego w projekcie trzeba rozdzielić błędy przejściowe od błędów biznesowych, takich jak brak produktu albo odrzucona płatność.
Choreografia i orkiestracja rozwiązują różne problemy
Istnieją dwa główne sposoby koordynowania sagi. W choreografii mikroserwisy reagują na zdarzenia publikowane przez inne usługi. W orkiestracji centralny koordynator zna kolejność kroków i mówi uczestnikom, co mają wykonać.
| Kryterium | Choreografia | Orkiestracja |
|---|---|---|
| Sposób sterowania | Usługi reagują na zdarzenia | Koordynator steruje przepływem |
| Sprzężenie | Brak centralnego sterownika, ale rośnie zależność od kontraktów zdarzeń | Uczestnicy są prostsi, lecz zależą od orchestratora |
| Przejrzystość procesu | Trudniejsza przy wielu uczestnikach | Łatwiejsza do śledzenia w jednym miejscu |
| Najlepsze zastosowanie | Krótki proces z kilkoma usługami | Złożony workflow z wieloma krokami |
| Główne ryzyko | Ukryte zależności i trudne debugowanie | Awaria lub przeciążenie koordynatora |
Choreografia oparta na zdarzeniach
W tym wariancie serwis zamówień publikuje zdarzenie OrderPlaced. Magazyn reaguje na nie, rezerwuje towar i publikuje InventoryReserved. Serwis płatności odbiera komunikat, a po powodzeniu emituje zdarzenie dla kolejnego uczestnika.
Choreografia dobrze pasuje do prostych procesów, w których każdy serwis ma wyraźną odpowiedzialność. Problem pojawia się wtedy, gdy liczba uczestników rośnie. Wtedy znajomość całego przebiegu sagi jest rozproszona po wielu handlerach, a zmiana jednego zdarzenia może wpłynąć na kilka pozornie niezależnych usług.
Orkiestracja z centralnym koordynatorem
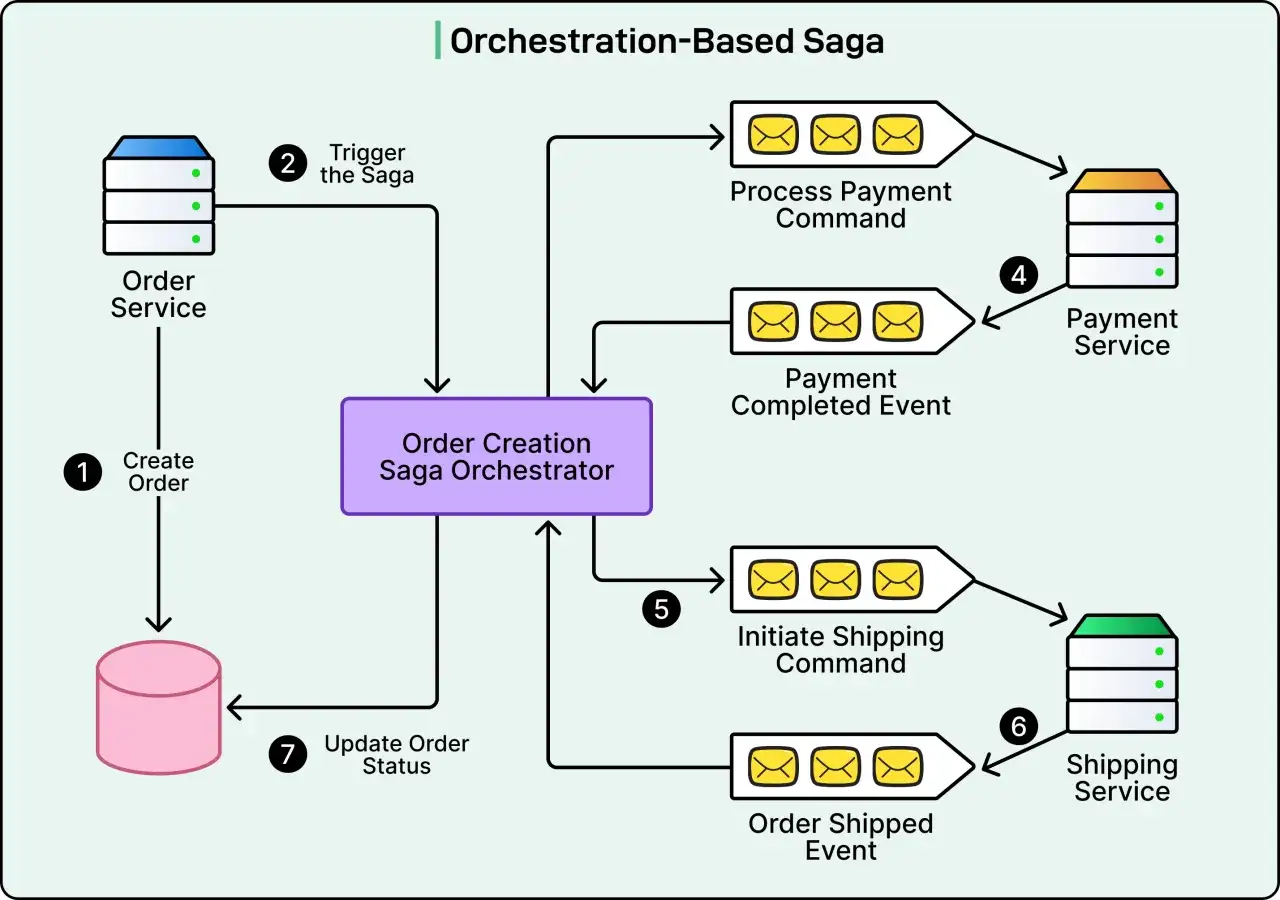
Orchestrator przechowuje stan procesu i wysyła polecenia do kolejnych serwisów. Wie, że po rezerwacji towaru należy autoryzować płatność, a po błędzie płatności trzeba zwolnić rezerwację.
To podejście zwykle wybieram dla dłuższych i ważniejszych procesów biznesowych. Logika pozostaje w jednym miejscu, łatwiej dodać timeout, limit ponowień i obsługę ręcznej interwencji. Trzeba jednak zadbać o wysoką dostępność koordynatora oraz zapisywanie jego stanu, aby awaria instancji nie przerwała workflow.
Co decyduje o niezawodności implementacji
Sama nazwa wzorca nie rozwiązuje problemu. Najwięcej pracy wymaga dopracowanie zachowania systemu w sytuacjach, które występują rzadko, ale są kosztowne. W implementacji .NET zwróciłbym szczególną uwagę na kilka elementów.
Idempotencja każdego kroku
Idempotentna operacja daje ten sam efekt, gdy ten sam komunikat zostanie obsłużony więcej niż raz. To konieczne, bo broker może dostarczyć wiadomość ponownie po timeoutcie albo awarii procesu.
Serwis płatności nie powinien więc bezwarunkowo obciążać karty przy każdym żądaniu. Powinien rozpoznać unikalny identyfikator operacji i zwrócić poprzedni rezultat, jeżeli żądanie było już wykonane.
Transactional outbox i inbox
Typowy problem polega na tym, że serwis zapisuje zmianę w bazie, ale nie publikuje zdarzenia, ponieważ proces kończy się błędem chwilę później. Transactional outbox zapisuje dane domenowe i komunikat w tej samej lokalnej transakcji, a osobny mechanizm publikuje wiadomości później.
Inbox pomaga z kolei zapamiętać obsłużone komunikaty i odrzucać duplikaty. Te dwa mechanizmy nie zastępują sagi, ale znacząco zmniejszają ryzyko utraty komunikatu albo wielokrotnego wykonania tej samej operacji.
Timeouty, retry i dead-letter queue
Każdy krok powinien mieć określony limit oczekiwania. Bez timeoutu saga może wisieć w stanie „w trakcie” przez wiele godzin, blokując dalszą obsługę zamówienia.
Retry powinien używać opóźnienia narastającego, czyli exponential backoff, oraz limitu prób. Po jego przekroczeniu wiadomość może trafić do kolejki błędów, gdzie zostanie zbadana albo ponownie uruchomiona po usunięciu przyczyny awarii.
Przeczytaj również: Architektura hexagonalna w .NET - porty, adaptery i praktyka
Obserwowalność procesu
Logi każdego mikroserwisu nie wystarczą. Wszystkie komunikaty i wywołania powinny przenosić identyfikator sagi, identyfikator zamówienia oraz numer kroku. Dzięki temu można odtworzyć pełną ścieżkę procesu w logach i śledzeniu rozproszonym.
Monitorowałbym co najmniej liczbę sag zakończonych sukcesem, czas trwania procesu, liczbę kompensacji, liczbę ponowień oraz procesy pozostające zbyt długo w stanie pośrednim. Brak widoczności sprawia, że nawet poprawnie działająca saga staje się trudna w utrzymaniu.
Kiedy warto użyć tego wzorca, a kiedy lepiej go unikać
Saga ma sens, gdy proces trwa długo, obejmuje kilka niezależnych usług i nie można użyć jednej lokalnej transakcji. Dobrze pasuje do zamówień, rezerwacji, procesów kredytowych, rejestracji użytkownika czy obsługi dostawy.
Nie stosowałbym jej automatycznie tylko dlatego, że system nazwano mikroserwisowym. Jeżeli trzy tabele należą do jednego modułu i mogą zostać zmienione w jednej transakcji SQL, lokalna transakcja będzie prostsza i bezpieczniejsza.
| Sytuacja | Rozsądny wybór |
|---|---|
| Zmiana danych w jednej bazie i jednym module | Zwykła transakcja ACID |
| Proces obejmuje kilka usług i może trwać długo | Saga z kompensacją |
| Krótki proces z kilkoma uczestnikami | Choreografia zdarzeń |
| Wiele kroków, timeoutów i wyjątków biznesowych | Orkiestracja |
| Wymagana natychmiastowa, silna spójność między systemami | Zmiana granic transakcji lub architektury |
Największym ograniczeniem jest brak atomowości całego procesu. Klient może przez kilka sekund widzieć zamówienie oczekujące, mimo że płatność została już zaakceptowana. Interfejs użytkownika musi to rozumieć, a model domenowy powinien przewidywać stany takie jak „w trakcie”, „oczekuje na kompensację” i „wymaga ręcznej obsługi”.
Trudna bywa również kompensacja operacji zewnętrznych. Nie zawsze da się cofnąć wysłaną wiadomość e-mail, wydrukowany dokument albo rozpoczęty proces u operatora płatności. W takich przypadkach trzeba zaprojektować akcję naprawczą, a nie udawać, że system wykonał pełny rollback.
Jak podejść do wdrożenia w aplikacji .NET
Zacząłbym od procesu biznesowego, nie od wyboru biblioteki. Najpierw rozpisuję kroki, właściciela danych, możliwy wynik każdego kroku oraz akcję kompensującą. Dopiero później wybieram sposób komunikacji i miejsce przechowywania stanu.
- Wyznacz granicę jednej lokalnej transakcji.
- Zdefiniuj stany procesu i dozwolone przejścia.
- Przygotuj komendy, zdarzenia oraz ich wersjonowanie.
- Dodaj identyfikator korelacji i klucz idempotencji.
- Zaprojektuj retry, timeout i ścieżkę dead-letter.
- Przetestuj awarię po każdym kroku, także podczas kompensacji.
W środowisku Azure komunikacja może być oparta na brokerze wiadomości, a koordynacja na osobnym komponencie obsługującym długotrwały workflow. Niezależnie od technologii nie przenosiłbym całej logiki do konfiguracji infrastruktury. Reguły biznesowe, takie jak warunek anulowania płatności, powinny być czytelne w kodzie i testowalne bez uruchamiania całej platformy.
Testy powinny obejmować nie tylko scenariusz sukcesu. Sprawdź timeout, zduplikowany komunikat, niedostępność brokera, restart orchestratora, błąd kompensacji oraz sytuację, w której odpowiedź z usługi przychodzi po przekroczeniu limitu czasu. To właśnie te przypadki pokazują, czy rozwiązanie jest naprawdę odporne.
Najważniejsza decyzja zapada przed napisaniem kodu
Saga nie jest zamiennikiem zwykłej transakcji ani sposobem na ukrycie źle wyznaczonych granic mikroserwisów. Jej siła pojawia się wtedy, gdy proces rzeczywiście musi przejść przez kilka niezależnych usług, a system potrafi świadomie zarządzać stanami pośrednimi.
W praktyce zacząłbym od najprostszego wariantu, który spełnia wymagania. Dla kilku kroków wystarczy choreografia, dla rozbudowanego procesu lepsza będzie orkiestracja. Niezależnie od wyboru największą różnicę robią idempotencja, outbox, dobre kompensacje i pełna obserwowalność, bo to one decydują, czy awaria pozostanie kontrolowanym stanem systemu, czy zamieni się w ręczne śledztwo po kilku bazach danych.