Duży system .NET zaczyna przypominać dobrze zorganizowane miasto dopiero wtedy, gdy wiadomo, kto obsługuje ruch, gdzie przechowywany jest stan i co dzieje się po awarii jednego z elementów. Azure Service Fabric pomaga ułożyć te zasady na poziomie platformy, ale nie zwalnia z decyzji architektonicznych. Pokażę, jak działa jego model aplikacji, kiedy wybrać usługi bezstanowe, jak projektować partycje i repliki oraz które wzorce sprawdzają się w praktycznych rozwiązaniach.
Najważniejsze decyzje dotyczące architektury Service Fabric
- Dwie podstawowe opcje to usługi bezstanowe oraz usługi stanowe z replikowanymi danymi.
- Partycjonowanie decyduje o skalowaniu, a repliki zapewniają dostępność po awarii węzła.
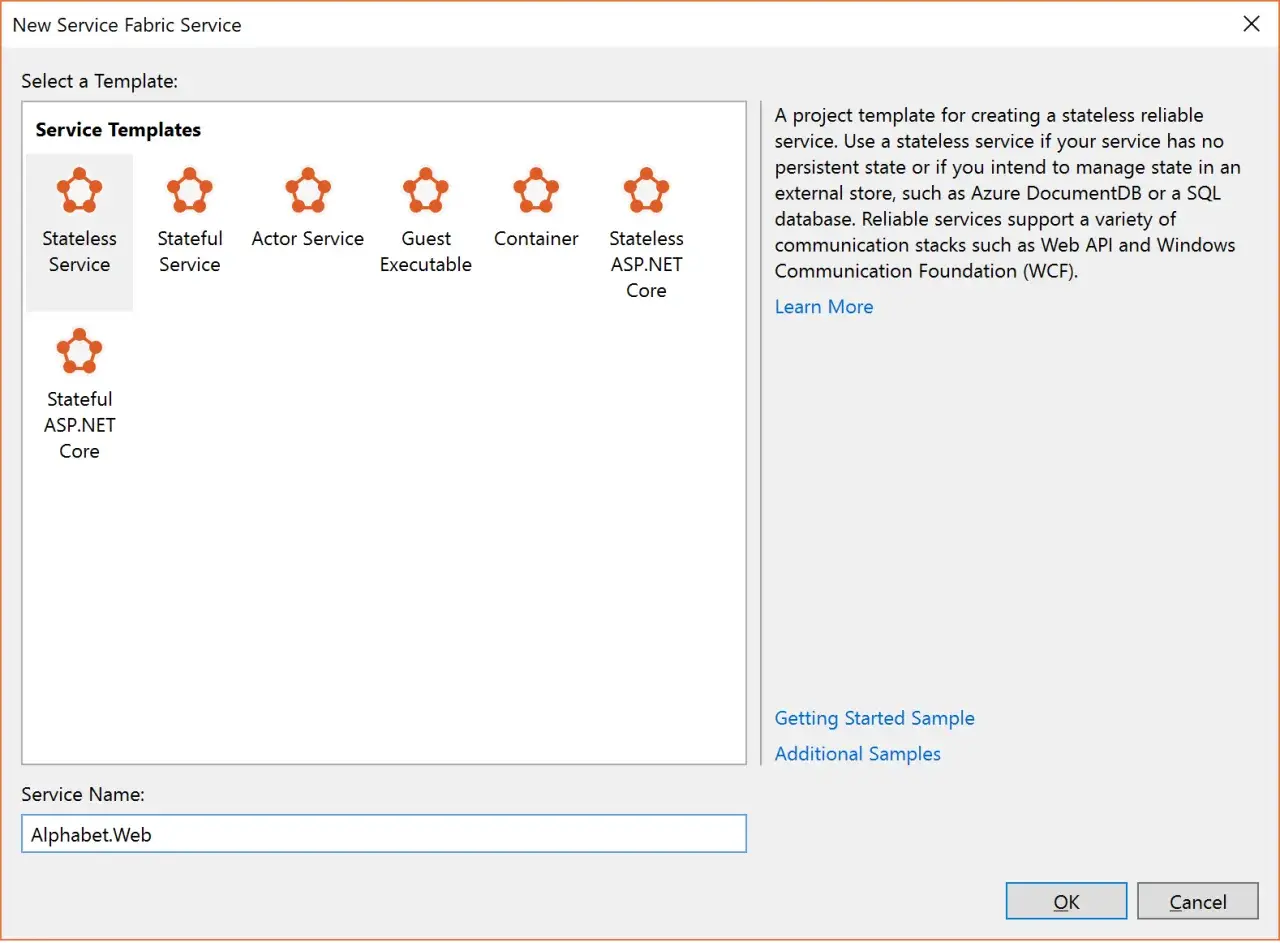
- Najbezpieczniejszy punkt wyjścia stanowi bezstanowe API z danymi w zewnętrznym magazynie.
- Reliable Actors pasują do tysięcy małych, niezależnych obiektów, ale nie do każdego modelu domeny.
- Monitorowane wdrożenia kroczące pozwalają zatrzymać lub wycofać aktualizację, gdy pogorszy się zdrowie aplikacji.
Jak rozumieć architekturę Service Fabric
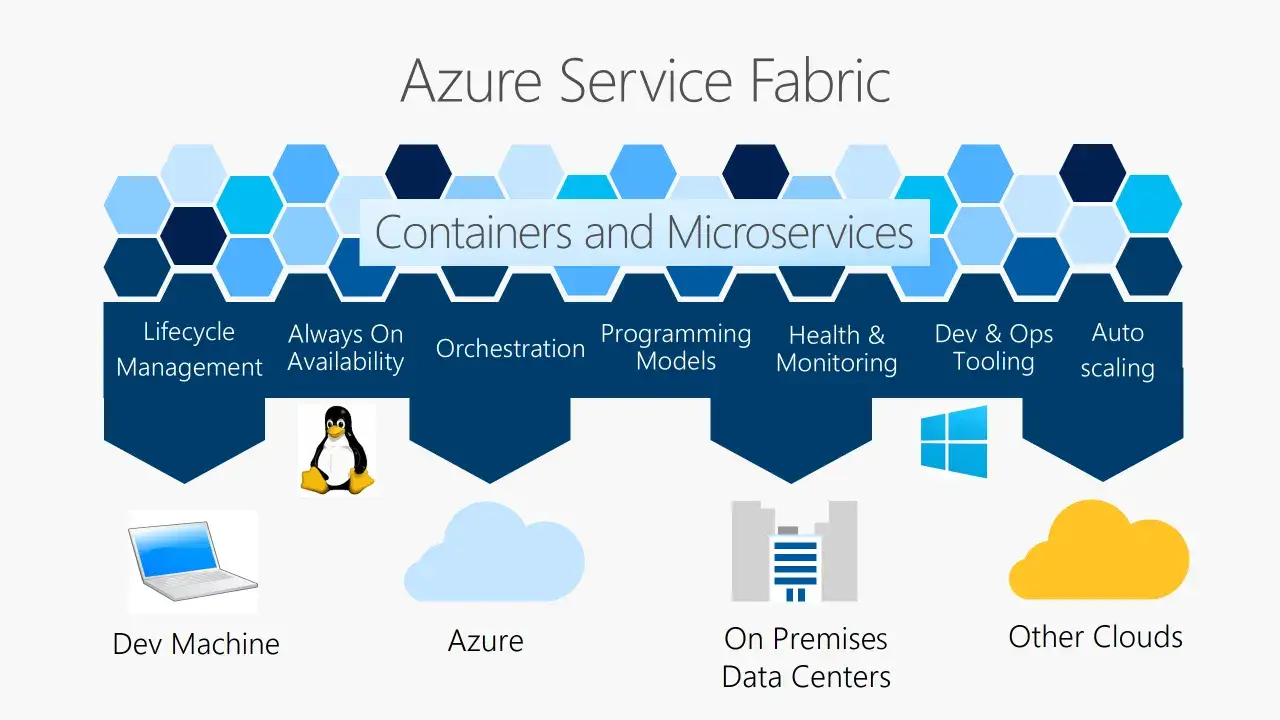
Service Fabric jest platformą do uruchamiania i zarządzania mikroserwisami, ale jego najważniejszą cechą nie jest samo wdrażanie kodu. Platforma przejmuje część pracy związanej z lokowaniem usług, wykrywaniem awarii, replikacją stanu, skalowaniem i aktualizacjami. Dzięki temu aplikacja może składać się z wielu niezależnych usług działających na wspólnym klastrze.
Podstawową jednostką wdrożenia jest aplikacja. Aplikacja zawiera jedną lub więcej nazwanych usług, a każda usługa może mieć własny model skalowania, partycjonowania i komunikacji. W praktyce oznacza to, że moduł zamówień nie musi być wdrażany, skalowany ani aktualizowany razem z modułem katalogu.
Od klastra do repliki
Klaster składa się z węzłów, czyli maszyn wirtualnych lub instancji przeznaczonych do uruchamiania usług. W obrębie klastra występują zwykle różne typy węzłów. Primary node type obsługuje usługi systemowe, a dodatkowe typy węzłów pozwalają odizolować na przykład frontend, usługi stanowe i zadania obliczeniowe.
Na niższym poziomie usługa dzieli się na partycje. Partycja jest fragmentem logicznego zakresu danych albo pojedynczym wystąpieniem usługi. W przypadku usługi stanowej każda partycja ma zestaw replik. Jedna replika jest Primary, a pozostałe pełnią rolę aktywnych kopii zapasowych. Gdy węzeł z repliką główną przestaje działać, platforma może wybrać inną replikę i odtworzyć dostępność usługi.
Ten model jest ważniejszy niż sama nazwa technologii. Projektant nie myśli wyłącznie o tym, jak uruchomić proces, ale również o tym, co dokładnie ma zostać odtworzone po awarii, jak rozłożyć dane i gdzie umieścić granicę między usługami.
Stateless i stateful bez niepotrzebnego komplikowania
Usługa bezstanowa nie przechowuje danych potrzebnych do dalszej obsługi żądania we własnej pamięci ani na lokalnym dysku. Jej instancje są wymienne, więc dobrze nadaje się do obsługi HTTP, walidacji, autoryzacji i orkiestracji wywołań. Stan może znajdować się w Azure SQL, Cosmos DB, Azure Storage albo innym zewnętrznym magazynie.
Usługa stanowa przechowuje stan wewnątrz klastra, najczęściej za pomocą Reliable Collections. Zmiany są replikowane między instancjami, a operacje na kolekcjach mogą być wykonywane w ramach transakcji. Zyskujemy małe opóźnienia i lokalność danych, ale płacimy za to większą złożonością operacyjną.
| Model | Dobre zastosowania | Główne ryzyko |
|---|---|---|
| Usługa bezstanowa | API, frontend, walidacja, integracje, procesory żądań | Stan trzeba poprawnie zapisać poza usługą |
| Usługa stanowa | Sesje, cache, workflow, lokalny stan urządzeń, szybkie agregaty | Trudniejsze kopie zapasowe, partycjonowanie i odtwarzanie |
| Reliable Actor | Tysiące małych niezależnych obiektów z własnym stanem | Nie pasuje do ciężkich operacji I/O i złożonych zapytań przekrojowych |
Moja praktyczna reguła jest prosta. Zacznij od usługi bezstanowej, jeśli nie masz wyraźnego powodu, aby stan znajdował się blisko kodu. Usługa stanowa ma sens wtedy, gdy lokalność danych daje realną korzyść, na przykład znacznie mniejsze opóźnienia albo możliwość wykonania atomowej operacji bez dodatkowej bazy.
Nie traktowałbym Reliable Collections jako automatycznego zamiennika dla systemu raportowego czy hurtowni danych. To przede wszystkim mechanizm przechowywania stanu usługi. Jeżeli dane mają przetrwać utratę całego klastra, trzeba zaplanować backup do zewnętrznego magazynu i procedurę odtworzenia. Sama replikacja w klastrze nie jest strategią disaster recovery.
Jak dobrać partycjonowanie
Service Fabric udostępnia trzy podstawowe schematy partycji. Singleton tworzy jedną partycję i pasuje do małej usługi. Partycjonowanie zakresowe Int64 dzieli klucze według przedziałów, a partycjonowanie nazwane przypisuje dane do określonych nazw. Wybór powinien wynikać z klucza biznesowego, a nie z wygody konfiguracji.
Dobrym kluczem jest taki, który równomiernie rozkłada ruch i pozwala skierować żądanie do jednej partycji. Dla koszyka zakupowego może to być identyfikator klienta, a dla urządzeń IoT identyfikator urządzenia. Złym wyborem będzie klucz, który powoduje, że większość operacji trafia do jednej partycji i tworzy hot partition, czyli przeciążony fragment systemu.
Wzorce komunikacji między mikroserwisami
W typowej aplikacji wejściem jest bezstanowe API. Żądanie trafia do właściwej usługi, ta rozwiązuje lokalizację partycji i komunikuje się z backendem. Ponieważ repliki mogą zmieniać węzły, nie należy zapisywać ich adresów na stałe. Do tego służy mechanizm nazewnictwa i rozwiązywania lokalizacji usług.
Przy komunikacji HTTP można użyć wbudowanego reverse proxy, ale w większych rozwiązaniach często lepszym punktem wejścia jest Azure API Management. Pozwala ono połączyć publikowanie API, autoryzację, limity, dokumentację i kierowanie ruchu do usług Service Fabric. Ważne jest, aby gateway nie stał się miejscem, w którym upchnięto całą logikę biznesową.
Komunikacja synchroniczna i asynchroniczna
Wywołanie synchroniczne sprawdza się, gdy klient potrzebuje odpowiedzi natychmiast, na przykład podczas pobierania szczegółów zamówienia. Trzeba jednak kontrolować timeouty, retry i limity współbieżności. Bez tego chwilowa awaria jednej usługi może wywołać kaskadę kolejnych żądań.
Operacje długie lub podatne na przeciążenia lepiej przekazywać asynchronicznie. Usługa przyjmuje komendę, zapisuje jej identyfikator i publikuje zdarzenie albo umieszcza pracę w kolejce. Handler powinien być idempotentny, czyli ponowne przetworzenie tej samej wiadomości nie może utworzyć drugiego zamówienia ani podwójnej płatności.
W komunikacji między usługami szczególnie istotne są trzy zasady:
- każda operacja ma określony timeout i politykę ponowień,
- retry nie może powielać skutków ubocznych,
- kontrakt wiadomości jest wersjonowany niezależnie od wdrożenia producenta i konsumenta.
Nie próbowałbym budować całej architektury na bezpośrednich wywołaniach między każdą usługą a każdą inną. Przy kilku modułach działa to dobrze, ale przy kilkunastu szybko powstaje trudna do śledzenia sieć zależności. Granice domenowe, zdarzenia i ograniczona liczba punktów wejścia dają zwykle lepszy efekt niż kolejny wspólny helper komunikacyjny.
Gdzie pasuje wzorzec Reliable Actors
Reliable Actors upraszcza model, w którym istnieje bardzo dużo małych obiektów posiadających własny stan i zachowanie. Każdy aktor ma identyfikator, działa w modelu pojedynczego wątku logicznego i może być automatycznie rozmieszczany między partycjami. Przykładami są urządzenia IoT, gracze, konta użytkowników, sesje albo procesy workflow.
Największą zaletą aktora jest to, że kod może przypominać pracę z obiektem domenowym, podczas gdy platforma zajmuje się aktywacją, lokalizacją, replikacją i przenoszeniem po awarii. To dobrze działa, gdy mamy tysiące lub miliony niezależnych jednostek, które rzadko muszą być odczytywane w jednym zbiorczym zapytaniu.
Aktor nie jest jednak magiczną warstwą nad bazą danych. Operacja wykonująca nieprzewidywalne I/O może blokować obsługę danego aktora i pogarszać opóźnienia. Trudne są też zapytania typu „znajdź wszystkie konta spełniające kilka warunków”, ponieważ stan aktorów jest rozproszony po partycjach, a nie przygotowany do swobodnego raportowania.
W mojej ocenie warto wybrać aktorów wtedy, gdy naturalną jednostką domeny jest pojedynczy obiekt reagujący na komunikaty. Jeżeli podstawą systemu są duże agregaty, przekrojowe zapytania i rozbudowane transakcje między wieloma encjami, klasyczne Reliable Services albo zewnętrzna baza będą zwykle prostsze.
Wdrożenia, zdrowie systemu i zachowanie po awarii
Service Fabric ma rozbudowany model aplikacji oparty między innymi na manifestach aplikacji i usług. Każda usługa może mieć własną wersję kodu, konfiguracji i danych. Taki podział pozwala aktualizować tylko te elementy, które faktycznie się zmieniły.
W środowisku produkcyjnym korzystałbym z monitorowanego upgrade. Platforma aktualizuje kolejne domeny aktualizacji, obserwuje stan aplikacji i przechodzi dalej dopiero po spełnieniu zdefiniowanych warunków. Gdy zdrowie systemu spadnie poniżej ustalonego poziomu, wdrożenie może zostać wstrzymane albo wycofane.
Automatyczna ocena zdrowia nie zastępuje monitoringu biznesowego. Service Fabric wie, czy proces działa, replika jest dostępna i czy aplikacja przechodzi politykę zdrowia. Nie wie natomiast, że liczba poprawnie opłaconych zamówień spadła o połowę. Dlatego oprócz metryk klastra trzeba raportować zdrowie zależne od logiki biznesowej i zbierać telemetrię w Azure Monitor lub Application Insights.
Przeczytaj również: Mediator w C# bez chaosu. Handlery, pipeline i dobre praktyki
Minimalne decyzje produkcyjne
Dla klastra produkcyjnego nie zaczynałbym od najmniejszej możliwej konfiguracji. Poziom niezawodności Bronze oznacza trzy węzły usług systemowych, Silver pięć, Gold siedem, a Platinum dziewięć. W praktyce dla obciążeń produkcyjnych najczęściej rozważa się Silver lub wyższy poziom, szczególnie gdy planowane są aktualizacje infrastruktury i utrzymanie dostępności.
- oddziel typy obciążenia przez dodatkowe node types,
- rozłóż krytyczne repliki między domeny awarii i strefy dostępności,
- przetestuj utratę węzła, repliki głównej i całej partycji,
- zdefiniuj backup oraz odtworzenie przed uruchomieniem danych produkcyjnych,
- sprawdź, czy usługi respektują anulowanie w
RunAsynci podczas zmiany roli.
Najczęstszy błąd polega na traktowaniu klastra jak dużej maszyny wirtualnej. W rzeczywistości jest to system rozproszony, więc chwilowa niedostępność, zmiana lokalizacji repliki i ponowienie komunikatu są normalnymi zdarzeniami. Kod powinien być na nie przygotowany, a testy chaosu lub kontrolowane awarie powinny sprawdzać, czy założenia architekta odpowiadają rzeczywistości.
Jak ocenić, czy ten model ma sens
Service Fabric pasuje do zespołów, które potrzebują mikroserwisów stanowych, precyzyjnego zarządzania cyklem życia i kontroli nad klastrem. Jest szczególnie interesujący dla aplikacji .NET, systemów o dużej liczbie niezależnych jednostek oraz rozwiązań, w których stan musi być blisko kodu z powodu opóźnień.
Nie wybrałbym go automatycznie do małej aplikacji CRUD, prostego API czy projektu, który nie ma zespołu gotowego utrzymywać klastra. W takich przypadkach usługa zarządzana, kontenery uruchamiane na prostszej platformie albo zwykłe API z bazą danych mogą ograniczyć koszty operacyjne i liczbę decyzji.
Najrozsądniejsza ścieżka zaczyna się od jednego konkretnego przypadku. Najpierw warto zbudować bezstanowy endpoint, dodać jedną usługę stanową, sprawdzić partycjonowanie i przeprowadzić kontrolowaną awarię. Dopiero gdy te elementy działają przewidywalnie, opłaca się dodawać aktorów, wiele typów węzłów i bardziej złożone przepływy zdarzeniowe.
Najważniejsza zasada projektowania usług w Service Fabric
Dobra architektura nie polega na tym, aby każdą funkcję zamienić w osobny mikroserwis. Największą wartość daje świadome rozdzielenie odpowiedzialności, dobranie klucza partycji do domeny i zaplanowanie zachowania systemu po awarii. Jeśli te trzy decyzje są poprawne, mechanizmy replikacji, skalowania i wdrażania zaczynają pracować na korzyść zespołu, a nie stają się kolejną warstwą problemów.