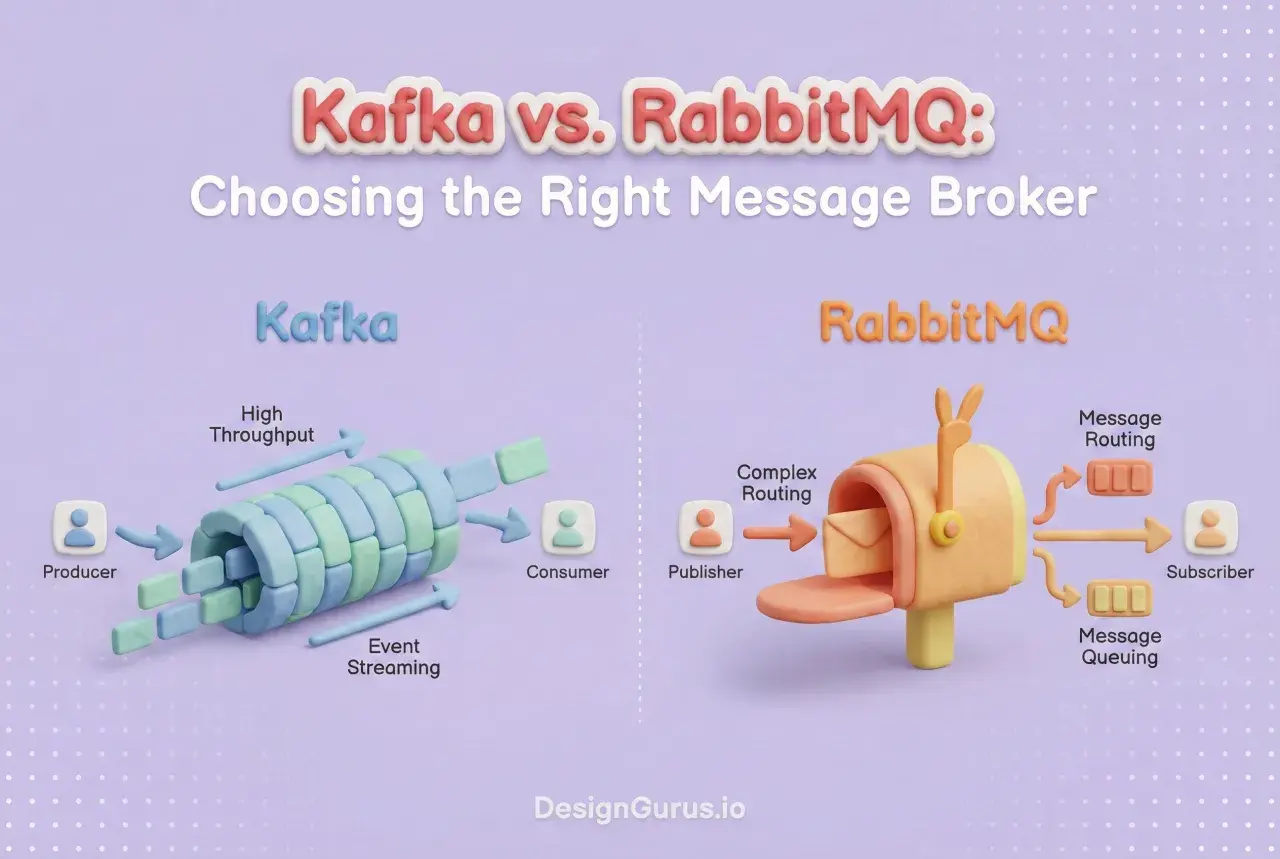
Projekt rośnie, a prosty mechanizm wysyłania komunikatów zaczyna wpływać na opóźnienia, retry i sposób skalowania całego systemu. Porównanie RabbitMQ vs Kafka pokazuje dwie różne filozofie pracy z komunikatami, dlatego omawiam tu architekturę obu narzędzi, najważniejsze wzorce, obsługę błędów oraz praktyczne kryteria wyboru dla aplikacji, także tych tworzonych w .NET.
Najważniejsza różnica wynika z tego, czy obsługujesz zadania, czy historię zdarzeń
- RabbitMQ najlepiej pasuje do kolejek zadań, routingu, retry, dead-letteringu i komunikacji między usługami.
- Kafka sprawdza się przy dużym strumieniu zdarzeń, partycjach, replayu oraz integracji z analityką.
- W RabbitMQ wiadomość jest niezależnym zadaniem, a w Kafka elementem trwałego logu.
- RabbitMQ kieruje komunikaty przez exchange i bindingi, natomiast Kafka opiera się głównie na topicach i partycjach.
- W obu rozwiązaniach trzeba projektować idempotentnych konsumentów, bo gwarancja exactly-once rzadko rozwiązuje problem end-to-end.
RabbitMQ i Kafka zaczynają od innego modelu danych
RabbitMQ jest brokerem komunikatów. Producent wysyła wiadomość do exchange, a broker decyduje, do których kolejek lub strumieni ma ona trafić. Reguły routingu definiują bindingi, klucze routingu i typ exchange. Konsument pobiera wiadomość, wykonuje pracę, a potem potwierdza ją za pomocą acknowledgement.
Ten model dobrze pasuje do sytuacji, w której wiadomość oznacza konkretne zadanie. Przykładowo usługa zamówień publikuje polecenie wygenerowania faktury, a jeden z dostępnych workerów je odbiera. Po poprawnym przetworzeniu komunikat znika z kolejki, a w przypadku błędu może wrócić do obsługi, trafić do retry queue albo dead-letter queue.
Kafka działa przede wszystkim jako rozproszony, trwały log. Producent zapisuje rekord w topicu, który jest podzielony na partycje. Każdy rekord ma offset, czyli pozycję w danej partycji, a konsument może śledzić swoje miejsce i wrócić do wcześniejszych danych.
To zmienia sposób myślenia. Odczyt wiadomości z Kafka nie musi jej usuwać. Ten sam fakt biznesowy może zostać odczytany przez kilka grup konsumentów, a nowa usługa może przetworzyć historię od wybranego momentu. Właśnie dlatego Kafka jest naturalnym wyborem dla event streamingu, analityki i budowania kolejnych projekcji danych.
| Kryterium | RabbitMQ | Kafka |
|---|---|---|
| Podstawowy model | Broker komunikatów i kolejki | Trwały log zdarzeń |
| Routing | Exchange, bindingi i klucze routingu | Topic, partycja i logika producenta |
| Równoległość | Wielu konsumentów kolejki konkuruje o wiadomości | Jedna partycja jest obsługiwana przez jednego konsumenta w grupie |
| Usuwanie danych | Po potwierdzeniu i obsłudze wiadomości | Według retencji, rozmiaru lub polityki przechowywania |
| Powtórne przetwarzanie | Wymaga retry, requeue lub osobnej konfiguracji | Naturalne dzięki offsetom i retencji |
Granica między produktami nie jest już tak ostra jak kilka lat temu. RabbitMQ ma trwałe strumienie, a nowsze możliwości Kafka obejmują również scenariusze bliższe kolejkom. Mimo tego pierwotne założenia architektury nadal wpływają na wygodę użycia, obsługę błędów i sposób modelowania aplikacji.
RabbitMQ wygrywa tam, gdzie komunikat jest konkretną pracą
Kolejka zadań dla workerów
Najbardziej typowy wzorzec RabbitMQ to work queue. API przyjmuje żądanie szybko, publikuje zadanie, a osobny worker wykonuje je poza głównym żądaniem HTTP. Tak można obsłużyć generowanie dokumentów, wysyłkę wiadomości e-mail, przetwarzanie obrazów czy synchronizację z systemem zewnętrznym.
W tym scenariuszu liczy się to, że jedno zadanie trafia do jednego wykonawcy. RabbitMQ daje tu naturalne acknowledgement, kontrolę prefetchu, możliwość ponowienia wiadomości i przekierowanie problematycznych komunikatów do dead-letter queue. Nie trzeba budować tych mechanizmów od podstaw w kodzie aplikacji.
Routing i selektywna dystrybucja
RabbitMQ jest bardzo wygodny, gdy odbiorcy interesują się różnymi fragmentami tego samego strumienia informacji. Exchange typu topic może kierować komunikaty według wzorców, na przykład orders.eu.* albo payments.failed. Nowy konsument może dołączyć przez utworzenie własnej kolejki i bindingu bez zmiany producenta.
To praktyczne w architekturze mikroserwisów. Usługa publikująca zdarzenie „zamówienie opłacone” nie musi znać usług magazynu, powiadomień i raportowania. Każda z nich ma własną kolejkę, własne tempo pracy i własną politykę retry.
Request-response i komunikacja punkt-punkt
RabbitMQ dobrze pasuje także do komunikacji request-response między usługami. Producent wysyła żądanie z correlation ID, a odbiorca odpowiada na wskazany kanał. W aplikacji .NET taki wzorzec może być prostszy do utrzymania niż tworzenie osobnych topiców odpowiedzi i ręczne zarządzanie korelacją rekordów.
Nie oznacza to, że każdą komunikację synchroniczną trzeba zamieniać na wiadomość. Jeżeli odpowiedź musi wrócić w kilkudziesięciu milisekundach, zwykłe HTTP lub gRPC często będzie czytelniejsze. RabbitMQ ma sens wtedy, gdy potrzebujesz buforowania, odporności na chwilową niedostępność i asynchronicznego wykonania.
W praktyce najczęstszy błąd polega na traktowaniu RabbitMQ jak bazy danych. Kolejka powinna mieć jasno określony cel, właściciela i politykę obsługi błędów. Jeżeli komunikaty mają być analizowane ponownie po wielu tygodniach, klasyczna kolejka może być niewygodnym narzędziem.
Kafka ma przewagę, gdy zdarzenia tworzą historię systemu
Strumień zdarzeń biznesowych
Kafka pasuje do architektury, w której system zapisuje fakty, a różne usługi reagują na nie niezależnie. Przykładowy event OrderPlaced może zasilić magazyn, płatności, analitykę, rekomendacje i model uczenia maszynowego. Każda grupa konsumentów czyta ten sam topic według własnego offsetu.
To odwraca popularny sposób projektowania. Nie myślę wtedy o tym, który serwis ma dostać konkretną wiadomość, lecz o tym, jakie zdarzenie powinno zostać zachowane i kto może być zainteresowany jego interpretacją.
Replay i odbudowa projekcji
Największą praktyczną zaletą Kafka jest możliwość ponownego odczytania danych. Jeżeli nowa usługa zaczyna działać dzisiaj, może przetworzyć zdarzenia z wcześniejszego okresu i zbudować własny widok. Jest to szczególnie przydatne przy event sourcingu, audycie oraz tworzeniu nowych modeli raportowych.
RabbitMQ również oferuje strumienie, ale klasyczna kolejka nie została zaprojektowana jako długoterminowy dziennik zdarzeń. Jeżeli historia jest częścią produktu, trzeba świadomie wybrać retencję, format eventów, kompatybilność schematów i sposób migracji. Sam fakt, że komunikat jest trwały, nie oznacza jeszcze, że będzie wygodny do odczytu za rok.
Partycje i kontrola kolejności
Kafka gwarantuje kolejność w obrębie pojedynczej partycji, nie całego topicu. Dlatego klucz partycjonowania ma znaczenie. Jeżeli wszystkie zdarzenia dotyczące jednego zamówienia powinny zachować kolejność, używam identyfikatora zamówienia jako klucza. Dzięki temu trafiają do tej samej partycji.
Trzeba jednak pilnować równowagi. Zły klucz może utworzyć hot partition, czyli partycję przeciążoną znacznie bardziej niż pozostałe. Zwiększenie liczby partycji nie naprawi błędnego modelu danych, a dodatkowo może skomplikować skalowanie i zarządzanie offsetami.
Kafka jest więc mocnym wyborem dla telemetrii, śledzenia aktywności użytkowników, integracji danych i dużych potoków zdarzeń. Nie wybierałbym go tylko dlatego, że brzmi bardziej „enterprise”. Jeśli aplikacja potrzebuje głównie zadań z retry i dead-letteringiem, jego logowy model może dodać niepotrzebnej złożoności.
Największe różnice pojawiają się przy błędach, skalowaniu i operacjach
Retry i dead-lettering
RabbitMQ traktuje nieudaną obsługę jako problem konkretnej wiadomości. Można ją ponowić po opóźnieniu, przekierować do innej kolejki albo zatrzymać po określonej liczbie prób. To dobrze pasuje do zadań, których nie wolno zgubić, ale których nie należy też bez końca wykonywać ponownie.
W Kafka błąd konsumenta często wiąże się z offsetem partycji. Jeżeli konsument nie może przejść dalej, trzeba zdecydować, czy zatrzymać partycję, pominąć rekord, zapisać go do osobnego topicu czy obsłużyć retry w aplikacji. Da się zbudować solidny mechanizm, lecz więcej odpowiedzialności spada na zespół.
Gwarancje dostarczenia
Oba systemy mogą działać w modelu at-least-once, czyli wiadomość zostanie dostarczona co najmniej raz, ale w razie awarii może pojawić się ponownie. Z tego powodu kod konsumenta powinien być idempotentny. Operacja idempotentna daje ten sam efekt po jednym i po kilku identycznych wywołaniach.
Przy płatności nie powinienem więc bezpośrednio tworzyć nowej transakcji za każdym razem, gdy pojawi się komunikat. Lepszym rozwiązaniem jest zapisanie unikalnego identyfikatora operacji i sprawdzenie przed wykonaniem, czy dana operacja nie została już zakończona. To zwykle daje więcej bezpieczeństwa niż poleganie na hasłach typu exactly-once.
Skalowanie konsumentów
W RabbitMQ zwiększam liczbę workerów, gdy rośnie liczba zadań. Broker rozdziela wiadomości między dostępne instancje, a mechanizmy acknowledgement i prefetch pomagają kontrolować obciążenie. Ograniczeniem może być liczba kolejek, rozmiar komunikatów, sposób replikacji i obciążenie routingu.
W Kafka skalowanie konsumentów jest związane z liczbą partycji. W tradycyjnej grupie konsumentów jedna partycja jest obsługiwana przez jednego aktywnego konsumenta. Jeśli topic ma cztery partycje, uruchomienie dwudziestu instancji nie da dwudziestokrotnego wzrostu równoległości.
Przeczytaj również: Data fabric w praktyce - warstwy, wzorce i wdrożenie w Azure
Koszt operacyjny
Nie ma jednej uniwersalnej odpowiedzi na pytanie, który system jest tańszy. Koszt zależy od wolumenu danych, retencji, replikacji, chmury, monitoringu i kompetencji zespołu. Kafka często wymaga bardziej świadomego planowania partycji, retencji i przepustowości dysków, natomiast RabbitMQ może skomplikować się przy bardzo dużej liczbie niezależnych przepływów.
W projektach .NET patrzę też na biblioteki i sposób pracy zespołu. MassTransit, RawRabbit czy bezpośredni klient AMQP mogą uprościć komunikację z RabbitMQ, a dla Kafka popularny jest klient oparty na librdkafka. Najważniejsze jest jednak nie to, który pakiet ma wygodniejsze API, tylko czy abstrakcja nie ukrywa kluczowych decyzji o retry, offsetach i idempotencji.
Jak wybrać rozwiązanie do konkretnego systemu
| Sytuacja | Lepszy pierwszy wybór | Dlaczego |
|---|---|---|
| Asynchroniczne zadania dla workerów | RabbitMQ | Naturalne potwierdzenia, retry, dead-lettering i konkurujący konsumenci. |
| Request-response między usługami | RabbitMQ | Prosty routing, correlation ID i kontrola dostarczenia pojedynczej wiadomości. |
| Wiele odbiorców zainteresowanych różnymi zdarzeniami | RabbitMQ lub Kafka | RabbitMQ daje routing po stronie brokera, Kafka niezależne grupy i retencję. |
| Duży strumień zdarzeń i telemetrii | Kafka | Partycje, batching, wysoka przepustowość i trwały log. |
| Replay danych po wdrożeniu nowej usługi | Kafka | Konsument może rozpocząć od wybranego offsetu. |
| Priorytety, opóźnienia i wygaszanie komunikatów | RabbitMQ | Model kolejki lepiej odwzorowuje niezależne zadania i ich cykl życia. |
Ja zaczynam od czterech pytań. Czy komunikat jest zadaniem do wykonania, czy faktem do zachowania? Czy nowy konsument powinien móc odczytać starą historię? Czy potrzebuję routingu po nagłówkach i wzorcach? Czy kolejność ma obowiązywać dla pojedynczego klucza, czy dla całego przepływu?
Jeżeli odpowiedzi wskazują na zadania, opóźnienia, retry i komunikację punkt-punkt, wybieram RabbitMQ. Jeżeli najważniejsze są retencja, replay, wiele niezależnych grup oraz przetwarzanie strumieniowe, skłaniam się ku Kafka.
Możliwe jest także użycie obu narzędzi. Przykładowo Kafka może przechowywać zdarzenia domenowe i zasilać analitykę, a RabbitMQ może obsługiwać krótkotrwałe zadania operacyjne. Taki układ ma sens tylko wtedy, gdy granica odpowiedzialności jest jasna. Dwa brokery bez konkretnego powodu oznaczają podwójny monitoring, więcej procedur awaryjnych i większy koszt utrzymania.
Najlepszy broker to ten, którego model pasuje do cyklu życia wiadomości
RabbitMQ wybrałbym wtedy, gdy wiadomość ma zostać dostarczona, przetworzona i ewentualnie ponowiona po błędzie. Kafka wybrałbym wtedy, gdy zdarzenie ma pozostać częścią historii, a wielu odbiorców powinno niezależnie odczytywać je w swoim tempie.
Najwięcej problemów widzę wtedy, gdy zespół wybiera narzędzie na podstawie samej przepustowości albo popularności. O powodzeniu decydują przede wszystkim semantyka komunikatu, strategia błędów, klucz partycjonowania, retencja i idempotencja, a dopiero później benchmark wykonany w warunkach zbliżonych do produkcji.
Dlatego przed wdrożeniem rozpisałbym jeden rzeczywisty przepływ, włącznie z awarią konsumenta, ponowieniem, duplikatem i odtworzeniem danych. Jeśli ten scenariusz naturalnie pasuje do kolejki, RabbitMQ będzie zwykle prostszą drogą. Jeśli przypomina dziennik zdarzeń, Kafka da zespołowi więcej możliwości na dalszy rozwój.