Gdy dane klientów, zamówień i procesów operacyjnych żyją w osobnych systemach, problemem szybko przestaje być samo ich przechowywanie. Trudniej ustalić, które źródło jest wiarygodne, kto może użyć informacji i jak bezpiecznie dostarczyć ją do raportu, aplikacji albo modelu AI. Data fabric porządkuje ten chaos jako podejście architektoniczne, dlatego pokażę, z jakich warstw się składa, jakie wzorce warto stosować i kiedy wdrożenie ma sens w środowisku .NET oraz Azure.
Spójny dostęp do danych bez wymuszania jednej bazy
- Data fabric to wzorzec architektoniczny, a nie pojedynczy produkt.
- Najważniejszą rolę odgrywają aktywne metadane, katalog danych, integracja i zarządzanie dostępem.
- Architektura może łączyć dane lokalne, chmurowe, relacyjne, dokumentowe i strumieniowe.
- Wirtualizacja ogranicza kopiowanie danych, ale nie zastępuje wszystkich potoków ETL i ELT.
- Najbezpieczniej zaczynać od jednego przypadku biznesowego i mierzyć jakość, czas dostarczenia oraz użycie danych.
Czym naprawdę jest ta architektura
Najprościej mówiąc, jest to warstwa organizująca dostęp, integrację i kontrolę nad rozproszonymi danymi. Nie wymaga przeniesienia wszystkiego do jednego hurtowni ani całkowitego oddania odpowiedzialności zespołom domenowym. Łączy źródła przez wspólne metadane, reguły bezpieczeństwa, interfejsy dostępu i procesy automatyzacji.
W praktyce użytkownik nie musi wiedzieć, czy informacja o kliencie znajduje się w SQL Serverze, systemie CRM, pliku Parquet w jeziorze danych czy w strumieniu zdarzeń. Powinien otrzymać opisany, aktualny i odpowiednio zabezpieczony zasób. Lokalizacja danych nadal ma znaczenie dla wydajności i kosztów, ale przestaje być główną przeszkodą w ich wykorzystaniu.
To ważne rozróżnienie, bo określenie „fabric” bywa używane jak nazwa gotowego rozwiązania. Ja traktuję je raczej jako zestaw zasad projektowych. Konkretne narzędzia mogą się zmieniać, natomiast potrzeba katalogowania, śledzenia pochodzenia, kontroli dostępu i automatycznej integracji pozostaje.
Jakie problemy rozwiązuje
- Silosy danych, czyli informacje zamknięte w systemach, które nie komunikują się ze sobą.
- Brak kontekstu, gdy kolumna ma techniczną nazwę, ale nikt nie wie, co oznacza biznesowo.
- Powielone potoki, w których kilka zespołów niezależnie pobiera i przekształca te same dane.
- Niepewna jakość, gdy raport pokazuje wartości bez informacji o świeżości, właścicielu i regułach walidacji.
- Ryzyko niekontrolowanego dostępu do danych osobowych, finansowych lub objętych tajemnicą przedsiębiorstwa.
Nie oznacza to jednak, że sama architektura naprawi bałagan. Jeżeli źródłowe systemy mają sprzeczne definicje klienta, brakuje właścicieli danych, a uprawnienia są nadawane ręcznie, potrzebne będą również decyzje organizacyjne. Technologia może te zasady egzekwować, ale nie wymyśli ich za firmę.
Z jakich warstw składa się rozwiązanie
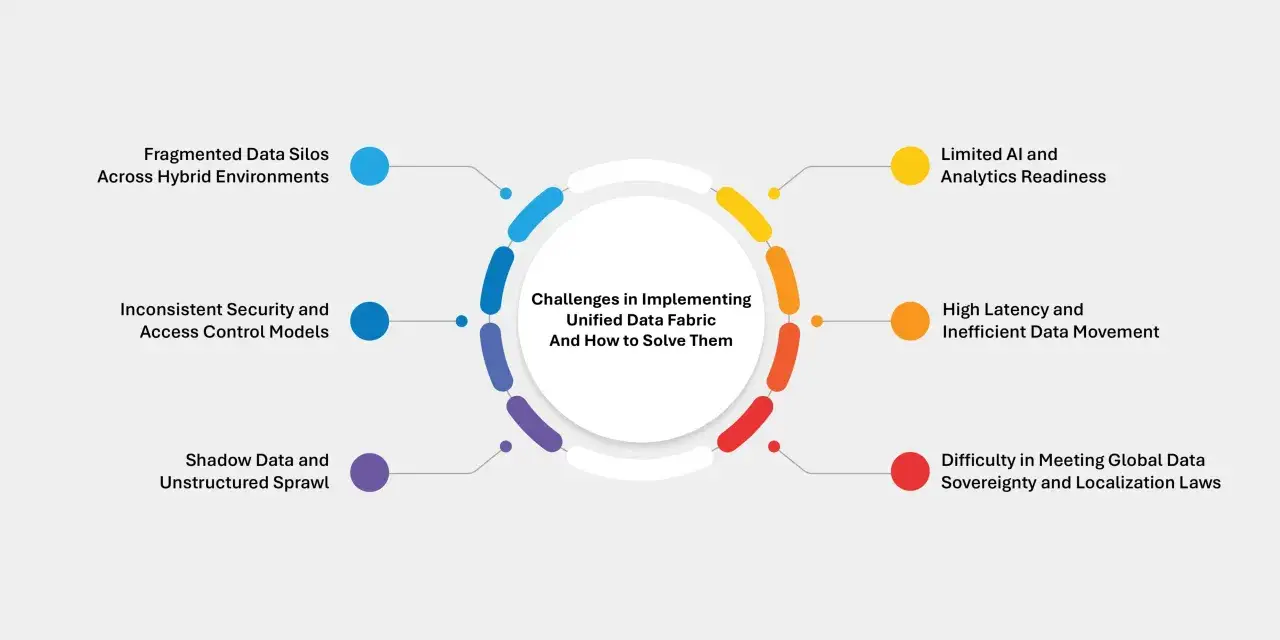
Dobrze zaprojektowana architektura przypomina sieć połączeń, a nie centralny magazyn. Dane pozostają w systemach najlepiej dopasowanych do swoich zastosowań, natomiast wspólne usługi pomagają je odnaleźć, zrozumieć, połączyć i bezpiecznie wykorzystać.
| Warstwa | Rola | Przykładowe elementy |
|---|---|---|
| Źródła danych | Dostarczają informacje operacyjne i analityczne | SQL Server, CRM, API, pliki, IoT, zdarzenia |
| Pozyskiwanie i integracja | Przenosi lub udostępnia dane w wymaganym trybie | ETL, ELT, CDC, streaming, konektory |
| Metadane i katalog | Opisuje zasoby, zależności, właścicieli i jakość | Katalog, słownik pojęć, lineage, graf wiedzy |
| Przetwarzanie | Czyści, wzbogaca i ujednolica dane | SQL, Spark, funkcje serverless, reguły jakości |
| Governance i bezpieczeństwo | Kontroluje dostęp, retencję, prywatność i audyt | RBAC, maskowanie, polityki, klasyfikacja |
| Konsumpcja | Dostarcza dane ludziom, aplikacjom i modelom | API, BI, notebooki, modele ML, agenci AI |
Metadane są ważniejsze niż kolejny konektor
Metadane to informacje o danych. Obejmują między innymi nazwę, typ, właściciela, częstotliwość odświeżania, poziom jakości, pochodzenie oraz relacje z innymi zasobami. W dojrzałym rozwiązaniu nie są tylko dokumentacją zapisaną raz w wiki, ale aktywnym źródłem decyzji dla automatyzacji.
Przykładowo, pipeline może na podstawie metadanych wiedzieć, że tabela zawiera dane osobowe, musi być szyfrowana i nie może trafić do środowiska deweloperskiego. Katalog może też wskazać, że raport sprzedaży korzysta z konkretnego widoku, a jego opóźnienie wynosi obecnie sześć godzin. Taka informacja skraca diagnozę problemu bardziej niż kolejny dashboard monitoringu.
Integracja nie zawsze oznacza kopiowanie
W przypadku danych potrzebnych często, w dużym wolumenie albo do długiej analizy zwykle opłaca się zastosować fizyczne przetwarzanie w jeziorze danych, hurtowni lub lakehouse. Przy prostych zapytaniach i wymaganiu aktualności lepsza może być wirtualizacja danych, czyli udostępnienie zunifikowanego widoku bez tworzenia kolejnej kopii.
Wirtualizacja ma jednak swoją cenę. Zapytanie może zależeć od dostępności kilku systemów źródłowych, a złożone operacje będą wolniejsze niż praca na przygotowanym modelu analitycznym. Dlatego nie traktuję jej jako zamiennika wszystkich potoków, tylko jako jeden z trybów dostarczania danych.
Wzorce, które sprawdzają się w praktyce
Największą wartość daje nie sama lista narzędzi, ale konsekwentne zastosowanie kilku wzorców. Poniższe podejścia można łączyć, dobierając je do wymagań dotyczących świeżości, kosztu, zgodności i odpowiedzialności zespołów.
Architektura oparta na aktywnych metadanych
W tym wzorcu katalog nie tylko opisuje zasoby, ale również reaguje na zmiany. Skanuje schematy, rozpoznaje wrażliwe kolumny, śledzi wykorzystanie tabel i aktualizuje zależności między źródłem a raportem. Reguły mogą uruchamiać alert, odświeżenie indeksu albo dodatkową walidację.
To dobry wybór dla organizacji, w której źródeł jest dużo i szybko się zmieniają. Trzeba jednak pilnować jakości samego katalogu. Nieaktualne metadane tworzą fałszywe poczucie kontroli, dlatego warto mierzyć kompletność opisów, czas synchronizacji oraz liczbę zasobów bez właściciela.
Wzorzec data product
Dane są publikowane jako produkty przeznaczone dla konkretnych odbiorców, na przykład „sprzedaż dzienna”, „profil klienta” albo „status dostawy”. Produkt ma właściciela, kontrakt, dokumentację, reguły jakości i określony sposób dostępu. Zespół konsumenta nie musi znać wszystkich szczegółów systemu źródłowego.
Największa korzyść polega na tym, że odpowiedzialność przestaje być rozmyta. Zespół publikujący dane odpowiada za ich użyteczność, a nie tylko za działanie tabeli. Ten wzorzec dobrze współpracuje z podejściem data mesh, ale sama warstwa integracyjna i governance może pozostać wspólna dla całej organizacji.
CDC i zdarzenia zamiast pełnego ładowania
Change Data Capture, czyli przechwytywanie zmian, przesyła tylko rekordy dodane, zmodyfikowane lub usunięte. W systemie zamówień pozwala ograniczyć obciążenie bazy i skrócić czas dostarczenia danych do analityki. Zdarzenia domenowe, takie jak „zamówienie opłacone”, mogą z kolei zasilać aplikacje niemal w czasie rzeczywistym.
Ten wzorzec wymaga dobrej obsługi kolejności zdarzeń, powtórzeń i błędów. W praktyce projektuję konsumentów jako idempotentnych, czyli takich, którzy mogą bezpiecznie przetworzyć to samo zdarzenie więcej niż raz. Bez tego chwilowa awaria brokera może skończyć się duplikatami w raporcie lub niespójnym stanem aplikacji.
Wspólna warstwa semantyczna
Warstwa semantyczna tłumaczy techniczne struktury na pojęcia biznesowe. Dzięki niej „przychód”, „aktywny klient” i „marża” mają zdefiniowane znaczenie niezależnie od tego, kto buduje raport. Dla rozwiązań AI jest to równie istotne, ponieważ model potrzebuje nie tylko wartości, lecz także kontekstu i ograniczeń.
Najczęstszy błąd polega na tworzeniu tej warstwy wyłącznie przez zespół techniczny. Definicje powinny być uzgadniane z właścicielami procesów, a później testowane na rzeczywistych raportach. Inaczej powstaje poprawny technicznie słownik, którego nikt nie używa.
Data fabric, data mesh i lakehouse nie oznaczają tego samego
Te pojęcia często pojawiają się razem, ale opisują różne poziomy decyzji. Jedno dotyczy sposobu łączenia i zarządzania środowiskiem danych, drugie modelu odpowiedzialności, a trzecie sposobu przechowywania i przetwarzania informacji.
| Podejście | Na czym skupia uwagę | Kiedy jest przydatne |
|---|---|---|
| Data fabric | Integracja, metadane, odkrywanie, governance i dostęp | Gdy dane są rozproszone między wieloma systemami i chmurami |
| Data mesh | Własność danych przez zespoły domenowe | Gdy centralny zespół nie zna dobrze potrzeb wszystkich obszarów |
| Lakehouse | Połączenie cech jeziora danych i hurtowni | Gdy potrzebne są tanie składowanie oraz analityka na wspólnej platformie |
| Hurtownia danych | Ustandaryzowany model analityczny i raportowanie | Gdy najważniejsza jest spójność raportów i przewidywalne zapytania |
W jednej firmie mogą wystąpić wszystkie te podejścia. Przykładowo lakehouse przechowuje dane historyczne, zespoły domenowe publikują produkty danych, a warstwa fabric kataloguje zasoby, pokazuje lineage i egzekwuje reguły dostępu. Nie ma tu sprzeczności, o ile każdy element ma jasno określoną rolę.
Trzeba też odróżnić architekturę od produktu Microsoft Fabric. Microsoft Fabric jest zintegrowaną platformą analityczną z własnymi usługami przechowywania, integracji, inżynierii danych i BI. Można jej użyć do zbudowania części lub całości takiego podejścia, ale nazwa produktu nie definiuje uniwersalnego wzorca architektonicznego.
Jak zaplanować wdrożenie w środowisku Azure
Nie zaczynałbym od budowy centralnego katalogu obejmującego każdy system w firmie. Lepszy rezultat daje wybór jednego procesu, na przykład obsługi zamówień, i opisanie go od źródła do raportu lub aplikacji. Dzięki temu szybko widać, gdzie naprawdę pojawia się problem z jakością, opóźnieniem albo uprawnieniami.
- Wybierz przypadek biznesowy. Określ, kto korzysta z danych, jak często ich potrzebuje i jaka decyzja zależy od wyniku.
- Zmapuj źródła i właścicieli. Spisz systemy, formaty, częstotliwość zmian, dane wrażliwe oraz osoby odpowiedzialne za definicje.
- Ustal kontrakt danych. Zdefiniuj schemat, klucze, dopuszczalne wartości, opóźnienie i zachowanie po zmianie struktury.
- Dobierz sposób integracji. Wybierz batch, CDC, API, streaming albo wirtualizację na podstawie wymagań, a nie mody technologicznej.
- Dodaj katalog i lineage. Użytkownik powinien zobaczyć, skąd pochodzi zasób, kto go utrzymuje i jakie raporty od niego zależą.
- Wprowadź kontrolę dostępu. Połącz role aplikacyjne, klasyfikację danych, maskowanie i audyt z procesem nadawania uprawnień.
- Zmierz efekt. Porównaj czas przygotowania danych, liczbę ręcznych korekt, opóźnienie oraz wykorzystanie opublikowanych zasobów.
W stosie Azure typowy zestaw może obejmować usługi do integracji, magazyn obiektowy, silnik zapytań, katalog i mechanizmy tożsamości. Nie przywiązywałbym się jednak do konkretnej kombinacji bez poznania obciążenia. Najdroższa część rozwiązania często nie leży w storage, lecz w przetwarzaniu, transferach, utrzymaniu konektorów i pracy ludzi odpowiedzialnych za jakość.
Przeczytaj również: MVVM w .NET - jak oddzielić UI od logiki aplikacji?
Jak mierzyć sukces
Sam fakt, że dane można znaleźć w katalogu, nie jest jeszcze wynikiem biznesowym. W projekcie warto ustalić kilka mierników, na przykład czas od pojawienia się danych w źródle do ich udostępnienia, procent zasobów z właścicielem, liczbę błędów jakości oraz odsetek raportów korzystających z zatwierdzonych produktów danych.
Dla systemów analitycznych sensownym celem może być skrócenie przygotowania nowego zbioru z kilku dni do kilku godzin. Dla systemów operacyjnych ważniejsze będą dostępność, opóźnienie i odporność na powtórzenie komunikatu. Nie ma jednej uniwersalnej wartości granicznej, ponieważ metryki trzeba dopasować do procesu i kosztu błędu.
Gdzie ta architektura nie będzie najlepszym wyborem
Mała aplikacja z jedną bazą, kilkoma tabelami i prostym raportem zwykle nie potrzebuje rozbudowanej warstwy katalogowej ani grafu zależności. W takim przypadku dodatkowe usługi mogą zwiększyć koszt, liczbę punktów awarii i wymagania kompetencyjne. Prostszy monolit danych bywa rozsądniejszy, jeśli problem rozproszenia jeszcze nie istnieje.
Ostrożność jest potrzebna również wtedy, gdy organizacja nie ma właścicieli danych. Automatyczne profilowanie wykryje typ kolumny, ale nie rozstrzygnie, czy „status klienta” oznacza stan umowy, aktywność w aplikacji czy zgodę marketingową. Bez decyzji biznesowych katalog stanie się dużym indeksem technicznych nazw.
Nie obiecywałbym też pełnego dostępu w czasie rzeczywistym do wszystkich źródeł. Starsze systemy mogą nie obsługiwać CDC, mieć ograniczone API albo wymagać okien serwisowych. Wtedy rozsądniejszy kompromis to cykliczna synchronizacja, dobrze opisane opóźnienie i jasna informacja dla konsumenta, że dane nie są aktualne co do sekundy.
Wrażliwe dane wymagają dodatkowej kontroli. Maskowanie, szyfrowanie i RBAC nie zastąpią klasyfikacji informacji, retencji, audytu oraz procedur reagowania na incydenty. W projektach obejmujących dane osobowe dopasowałbym rozwiązanie do wymagań RODO i zasad obowiązujących w konkretnej organizacji, zamiast kopiować gotowy schemat z innego środowiska.
Od katalogu danych do architektury, której można zaufać
Najlepszy punkt startowy to nie zakup kolejnej platformy, ale odpowiedź na trzy pytania. Które dane mają największą wartość, gdzie dziś tracimy czas oraz jaka reguła dostępu lub jakości musi być wymuszana automatycznie. Dopiero potem dobierałbym narzędzia, integrację i sposób przechowywania.
Jeżeli dane są rozproszone, ale firma potrafi wyznaczyć właścicieli i zdefiniować podstawowe kontrakty, podejście fabric może znacząco uprościć pracę zespołów .NET, analityków i projektantów rozwiązań AI. Jego siła nie polega na magicznym scaleniu wszystkiego, tylko na tym, że każdy zasób dostaje kontekst, zasady i przewidywalny sposób użycia.
Moja praktyczna rekomendacja jest prosta: zacznij od jednego przepływu danych, wdroż katalog z lineage, zmierz jakość i opóźnienie, a dopiero później rozszerzaj architekturę. Jeśli po kilku miesiącach użytkownicy szybciej znajdują właściwe dane, zespoły rzadziej budują te same potoki, a audyt dostępu nie wymaga ręcznego śledztwa, wtedy wiadomo, że rozwiązanie przynosi realną wartość.