Rozmowa o mikroserwisach szybko wychodzi poza definicję i pytanie o REST. Rekruter chce sprawdzić, czy potrafisz podejmować decyzje przy awariach, opóźnieniach, niespójności danych i rosnącej skali. Listy oznaczane jako microservices interview questions pomagają uporządkować przygotowanie, ale najwięcej zyskasz wtedy, gdy nauczysz się uzasadniać wybór konkretnego wzorca.
Najważniejsze elementy dobrej odpowiedzi o mikroserwisach
- Granice usług powinny wynikać z domeny biznesowej, a nie z liczby klas czy tabel.
- Własność danych oznacza, że każdy serwis sam zarządza swoim modelem i nie udostępnia bezpośrednio bazy innym usługom.
- Odporność wymaga timeoutów, limitów ponowień, circuit breakera i ochrony przed kaskadowymi awariami.
- Spójność danych często jest osiągana przez Sagę, zdarzenia i wzorzec transactional outbox.
- Obserwowalność obejmuje metryki, logi, śledzenie rozproszone i korelację żądań.
Co naprawdę sprawdza rozmowa o mikroserwisach
Najczęściej nie chodzi o recytowanie definicji. Dobra odpowiedź pokazuje, że rozumiesz koszt rozproszenia systemu: komunikacja odbywa się przez sieć, procesy mogą działać niezależnie, a pojedyncza operacja może zakończyć się częściowym sukcesem.
Czym mikroserwisy różnią się od monolitu?
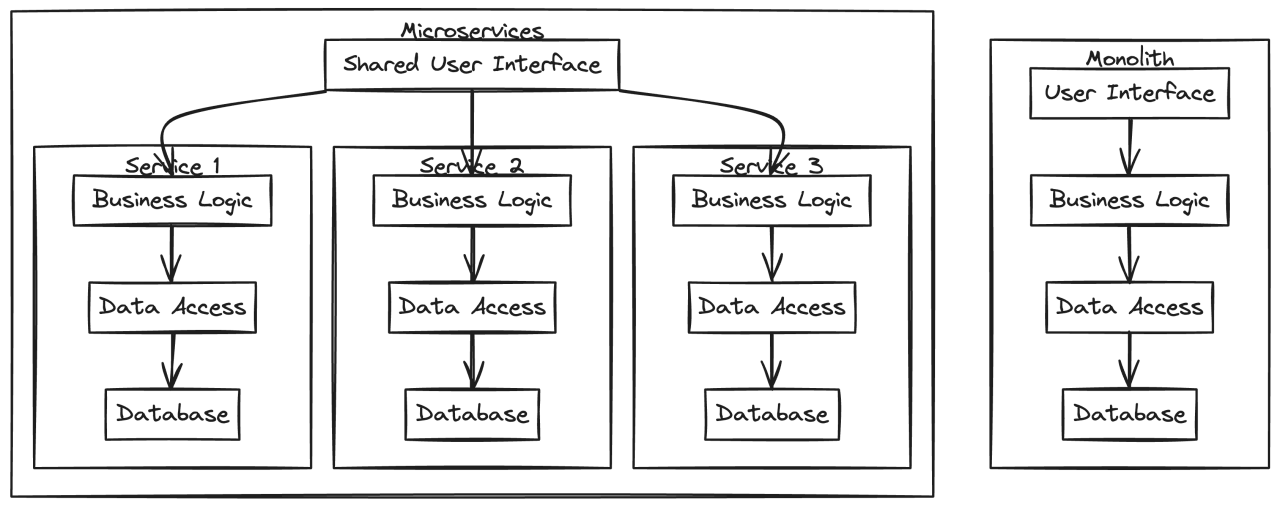
Monolit jest wdrażany jako jedna jednostka, nawet jeśli ma dobrze podzielony kod. Mikroserwisy to zestaw usług, które można rozwijać, wdrażać i skalować niezależnie, zwykle wokół osobnych możliwości biznesowych.
Nie odpowiadam jednak, że mikroserwisy są po prostu „lepsze”. Ich największą zaletą jest autonomia zespołów i niezależne wdrażanie, ale ceną stają się sieć, monitoring, automatyzacja oraz problemy typowe dla systemów rozproszonych.
| Obszar | Monolit | Mikroserwisy |
|---|---|---|
| Wdrożenie | Jedna jednostka wdrożeniowa | Niezależne wdrażanie usług |
| Dane | Często wspólna baza i transakcje lokalne | Osobne dane i spójność między usługami |
| Skalowanie | Zwykle skalowanie całej aplikacji | Skalowanie tylko obciążonych usług |
| Debugowanie | Zwykle prostsze | Wymaga logów, metryk i distributed tracingu |
| Ryzyko | Awaria może objąć całą aplikację | Awaria jednej usługi może rozlać się na inne |
Kiedy mikroserwisy są złym wyborem?
To pytanie często odróżnia osobę, która zna modne hasła, od inżyniera rozumiejącego konsekwencje. Mikroserwisy mogą być złym wyborem dla małego produktu, niewielkiego zespołu i słabo poznanej domeny, gdy niezależne wdrażanie nie daje realnej korzyści.
Jeżeli aplikacja ma kilka funkcji, jeden zespół i prosty model danych, modularny monolit będzie zwykle tańszy w utrzymaniu. Sam zacząłbym od wyraźnych modułów i dopiero później wydzielał usługi, gdy pojawi się konkretny powód, na przykład różne tempo zmian, osobne wymagania skalowania albo niezależne zespoły.
Jak wyznaczyć granice mikroserwisu?
Najlepszą odpowiedzią jest odwołanie do bounded context z Domain-Driven Design. Granica usługi powinna obejmować spójny fragment domeny, własne reguły biznesowe i dane potrzebne do ich realizacji.
Przykładowy system sprzedażowy może mieć usługi Zamówienia, Płatności, Magazynu i Powiadomień. Nie dzieliłbym go jednak automatycznie na usługę klientów, adresów, koszyka i każdej tabeli. Zbyt drobny podział prowadzi do wielu wywołań sieciowych i tak zwanego distributed monolith, czyli systemu rozdzielonego na procesy, ale nadal silnie zależnego.
Po czym poznać distributed monolith?
W takim systemie usługi są formalnie niezależne, lecz muszą być wdrażane razem, korzystają ze wspólnej bazy albo wykonują długie łańcuchy synchronicznych wywołań. Charakterystyczny sygnał to sytuacja, w której zmiana jednego kontraktu wymaga jednoczesnej aktualizacji pięciu usług.
W rozmowie warto powiedzieć, jak ograniczyć ten problem: własność danych, stabilne kontrakty API, zdarzenia domenowe, kompatybilność wsteczna i zespoły odpowiedzialne za pełny cykl życia usługi. Sama liczba kontenerów nie tworzy dobrej architektury.
Najczęstsze pytania o komunikację i dane
Kiedy wybrać REST lub gRPC, a kiedy komunikację asynchroniczną?
Komunikacja synchroniczna pasuje do sytuacji, w której klient potrzebuje odpowiedzi od razu, na przykład podczas pobierania szczegółów zamówienia. REST jest prosty i dobrze współpracuje z przeglądarkami, natomiast gRPC może być wygodny w komunikacji wewnętrznej, gdy liczą się ściśle określone kontrakty i niskie opóźnienia.
Komunikacja asynchroniczna sprawdza się przy zdarzeniach, integracjach i zadaniach, które nie muszą zakończyć się w ramach jednego żądania HTTP. Wiadomość „Zamówienie utworzone” może uruchomić rezerwację towaru, wysłanie e-maila i aktualizację raportów bez blokowania klienta.
Nie używam asynchroniczności automatycznie. Broker wiadomości dodaje problemy z kolejnością, powtórzeniami, opóźnieniami i obsługą komunikatów zatrutych, dlatego wybór powinien wynikać z wymaganej latencji i modelu spójności.
Do czego służy API Gateway?
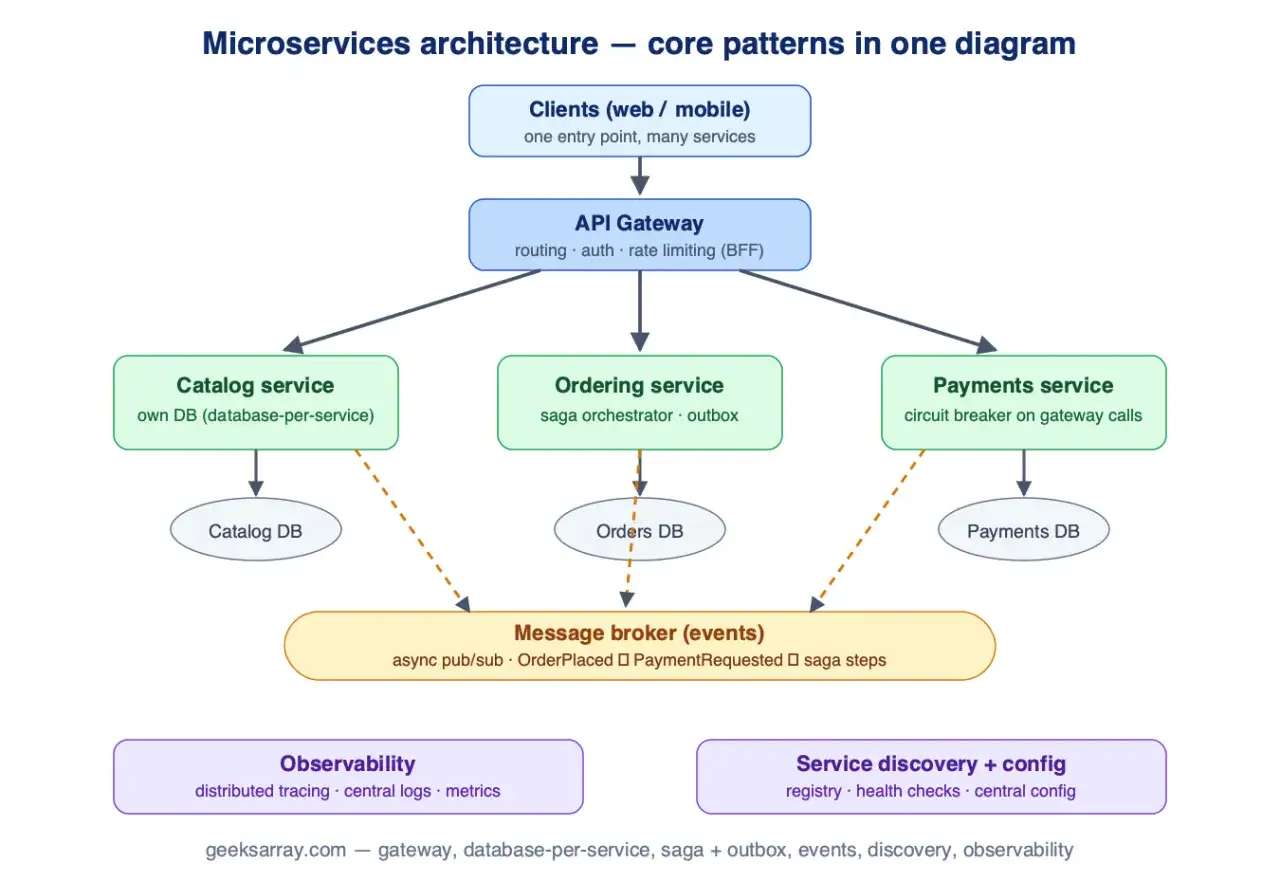
API Gateway jest punktem wejścia dla klientów. Może zajmować się uwierzytelnianiem, limitowaniem ruchu, routingiem, agregowaniem odpowiedzi oraz ukrywaniem wewnętrznej topologii usług.
Nie powinien jednak stać się miejscem całej logiki biznesowej. Jeżeli gateway wykonuje skomplikowane reguły, zaczyna być kolejnym monolitem. W większych systemach przydatny może być także wzorzec Backend for Frontend, w którym osobne API dopasowuje odpowiedź do potrzeb aplikacji webowej i mobilnej.
Co oznacza zasada database per service?
Każdy serwis powinien być właścicielem swoich danych i udostępniać je innym przez kontrakt, a nie przez bezpośredni dostęp do tabel. Nie oznacza to koniecznie osobnego serwera bazy dla każdej usługi. Ważniejsze jest to, aby inne komponenty nie omijały API i nie modyfikowały cudzych tabel.
Taki podział daje autonomię, ale utrudnia raportowanie i zapytania przekrojowe. Rozwiązaniem może być osobny model odczytowy, replikacja zdarzeń, CDC albo świadomie zaprojektowany proces ETL. Wspólna baza bywa wygodnym etapem migracji, lecz jako stała granica między usługami zwykle tworzy silne sprzężenie.
Jak obsłużyć transakcję obejmującą kilka usług?
W mikroserwisach rzadko próbuję odtwarzać jedną globalną transakcję obejmującą wszystkie bazy. Zamiast tego rozbijam proces na lokalne transakcje i definiuję, co ma się stać, gdy jeden krok się nie powiedzie.
Najczęściej pojawia się tutaj wzorzec Saga. Może działać choreograficznie, gdy usługi reagują na zdarzenia, albo orkiestracyjnie, gdy osobny komponent steruje przebiegiem procesu. W obu wariantach potrzebne są akcje kompensujące, na przykład zwrot płatności po nieudanej rezerwacji produktu.
Po co stosuje się transactional outbox?
Problem pojawia się wtedy, gdy usługa zapisze zmianę w bazie, ale ulegnie awarii przed wysłaniem zdarzenia do brokera. Wzorzec transactional outbox zapisuje dane biznesowe i zdarzenie w tej samej lokalnej transakcji, a osobny proces publikuje później komunikat.
Outbox nie zapewnia magicznie dostarczenia dokładnie raz. Konsument powinien być idempotentny, czyli ponowne przetworzenie tego samego komunikatu nie może zmienić wyniku w niepożądany sposób. Przydatny jest identyfikator wiadomości oraz tabela przetworzonych komunikatów.
Jak rozwiązać problem eventual consistency?
Eventual consistency oznacza, że różne modele danych mogą przez pewien czas pokazywać różne wartości, ale po poprawnym przetworzeniu zdarzeń dążą do zgodności. To rozsądny kompromis, gdy ważniejsza jest dostępność i niezależność usług niż natychmiastowa spójność wszystkich odczytów.
Na rozmowie warto podać konkretny przykład. Po opłaceniu zamówienia ekran może przez kilka sekund pokazywać status „przetwarzanie”, a nie „zakończone”. Jeśli domena nie dopuszcza takiego opóźnienia, trzeba zmienić projekt procesu, a nie udawać, że problem rozwiąże kolejna biblioteka.
Jak odpowiadać o odporności, obserwowalności i bezpieczeństwie
Co zrobisz, gdy zależna usługa przestanie odpowiadać?
Pierwsza odpowiedź nie powinna brzmieć „dodam retry”. Ponowienia bez limitu mogą zwiększyć ruch i doprowadzić do kaskadowej awarii. Zacząłbym od timeoutu, limitu czasu całej operacji i jasnego zachowania awaryjnego.
Retry ma sens przy błędach przejściowych i powinien używać limitu oraz narastającego opóźnienia z losowym rozrzutem. Circuit breaker czasowo przerywa wywołania do niedostępnej usługi, a bulkhead izoluje zasoby, aby jedna zależność nie zużyła wszystkich wątków lub połączeń.
Przykładowo usługa rekomendacji może zostać pominięta, gdy nie odpowiada, ale brak potwierdzenia płatności nie powinien być traktowany jako sukces. Fallback musi być zgodny z regułą biznesową, nie tylko technicznie wygodny.
Jak monitorować system złożony z wielu usług?
Potrzebne są trzy grupy sygnałów: metryki, logi i ślady rozproszone. Metryki pokazują między innymi opóźnienie, liczbę błędów, przepustowość i zużycie zasobów. Logi wyjaśniają zdarzenie, a tracing pozwala prześledzić jedno żądanie przez wiele usług.
Każde żądanie powinno mieć correlation ID, przekazywane dalej przez HTTP lub komunikaty. W praktyce bardzo pomaga także mierzenie opóźnień kolejek, wieku najstarszej wiadomości i liczby komunikatów w dead-letter queue. Sam status „proces działa” nie mówi, czy użytkownik faktycznie otrzymuje poprawną odpowiedź.
Jak zabezpieczyć komunikację między usługami?
Odpowiedź powinna obejmować uwierzytelnianie, autoryzację i ochronę sekretów. OAuth 2.0 oraz OpenID Connect są często używane przy dostępie użytkownika, JWT przenosi informacje o tożsamości, a mTLS może potwierdzać tożsamość usług w komunikacji wewnętrznej.
Nie wystarczy powiedzieć, że „każda usługa ma token”. Trzeba wspomnieć o najmniejszych uprawnieniach, rotacji sekretów, szyfrowaniu transmisji, walidacji wejścia i ograniczeniu zaufania między komponentami. W systemie .NET warto też rozdzielić konfigurację od sekretów i nie umieszczać danych dostępowych w repozytorium.
Jak testować architekturę mikroserwisową?
Testy jednostkowe sprawdzają reguły w pojedynczej usłudze, ale nie wykrywają problemów z kontraktem. Do tego służą testy kontraktowe, które weryfikują zgodność producenta i konsumenta API lub zdarzeń.
Testy integracyjne powinny obejmować bazę, broker i zewnętrzne zależności. Testy end-to-end zostawiłbym dla najważniejszych ścieżek, ponieważ są wolniejsze i bardziej kruche. Przy systemach krytycznych warto również testować scenariusze awarii, opóźnień i ponownego dostarczenia komunikatu.
Jak rozwiązać zadanie system design na rozmowie
W zadaniu typu „zaprojektuj system zamówień” nie zaczynam od wymieniania Kafki, Kubernetes czy API Gateway. Najpierw ustalam wymagania: liczbę użytkowników, oczekiwaną latencję, dopuszczalny czas niedostępności, wymagania dotyczące płatności i to, które operacje muszą być natychmiastowe.
Przykładowy tok odpowiedzi
- Wyznacz granice domeny. Oddziel zamówienia, płatności, magazyn i powiadomienia, ale nie twórz usługi dla każdej tabeli.
- Opisz przepływ. Klient wysyła żądanie do API, usługa zamówień zapisuje dane i publikuje zdarzenie.
- Wybierz komunikację. Odczyt statusu może być synchroniczny, a powiadomienia i aktualizacja raportów asynchroniczne.
- Rozwiąż spójność. Proces płatności i rezerwacji obsłuż przez Sagę z jasno zdefiniowanymi kompensacjami.
- Dodaj odporność. Ustal timeouty, retry, circuit breaker, idempotencję oraz zachowanie po awarii brokera.
- Opisz operacje. Wymień metryki, trace’y, alerty, wdrożenia bez przestoju i sposób wycofania błędnej wersji.
Taki schemat pokazuje sposób myślenia, a nie tylko znajomość nazw wzorców. Rekruter może dopytać, co stanie się po podwójnym kliknięciu przycisku płatności. Wtedy warto wskazać klucz idempotencji, unikalny identyfikator operacji i bezpieczne sprawdzenie jej wcześniejszego wyniku.
Jak mówić o skalowaniu?
Najpierw określ wąskie gardło. Usługa katalogu może potrzebować cache i replik odczytowych, natomiast przetwarzanie płatności może wymagać ostrożnego limitowania oraz kolejki. Skalowanie wszystkich komponentów tak samo jest proste, ale zwykle kosztowne.
Ważna jest też ochrona przed przeciążeniem. Kolejka, backpressure i limit liczby równoległych operacji pomagają utrzymać system przy nagłym skoku ruchu. Samo zwiększenie liczby instancji nie rozwiąże problemu, jeśli bottleneckiem jest wspólna baza albo zewnętrzny dostawca.
Przeczytaj również: Logika biznesowa w .NET - jak uporządkować reguły aplikacji
Jak opowiedzieć o wdrażaniu i wersjonowaniu?
Usługi powinny mieć niezależne pipeline’y, automatyczne testy, migracje danych i możliwość szybkiego wycofania wersji. Przy API i zdarzeniach preferuję kompatybilne zmiany: najpierw dodanie nowego pola, później migracja konsumentów, a dopiero na końcu usunięcie starego.
Wdrożenia canary lub blue-green ograniczają ryzyko, ale wymagają poprawnego routingu, monitoringu i planu migracji. Nie ma sensu mówić o wdrożeniu bez przestoju, jeśli zmiana schematu bazy wymaga zatrzymania wszystkich usług.
Błędy, które obniżają ocenę kandydata
Najczęstszy błąd to przedstawianie mikroserwisów jako rozwiązania każdego problemu. Doświadczony kandydat potrafi powiedzieć, że prostsza architektura może być lepszą decyzją, jeśli nie ma potrzeby niezależnego skalowania i wdrażania.
- „Każda usługa musi mieć osobny serwer bazy” - ważniejsza jest własność danych i brak bezpośredniego dostępu innych usług.
- „Retry naprawia awarie sieci” - bez limitów retry może wywołać lawinę kolejnych żądań.
- „Kafka zapewnia dokładnie jednokrotne przetworzenie” - konsument nadal powinien być idempotentny.
- „API Gateway może zawierać całą logikę” - wtedy powstaje centralny punkt sprzężenia i awarii.
- „Eventual consistency oznacza utratę danych” - to model czasowej niespójności, który wymaga jawnych reguł i monitorowania.
- „Kubernetes rozwiązuje problemy architektury” - orkiestrator automatyzuje uruchamianie, ale nie naprawi złych granic usług ani błędnych transakcji.
Unikałbym też odpowiedzi złożonych wyłącznie z nazw narzędzi. Azure Service Bus, Docker, Kubernetes czy ASP.NET Core mogą być elementami rozwiązania, ale najpierw trzeba wyjaśnić jaki problem rozwiązują i jaki koszt wprowadzają.
Dobra odpowiedź kończy się decyzją
Przed rozmową przygotuj dwa konkretne przykłady. W pierwszym pokaż projekt lub funkcję, za którą odpowiadałeś, a w drugim opowiedz o awarii, kompromisie albo decyzji, którą dziś podjąłbyś inaczej.
Najmocniejsza odpowiedź ma prosty rytm: opis problemu, wybrany wzorzec, uzasadnienie, ryzyko i sposób pomiaru efektu. Gdy potrafisz przejść od granic domeny przez komunikację i dane aż do odporności oraz obserwowalności, pokazujesz nie tylko znajomość mikroserwisów, ale przede wszystkim dojrzałość projektową.