Klikasz przycisk „Pokaż produkty”, a aplikacja pobiera dane bez zmieniania ich na serwerze. Właśnie w takich sytuacjach działa metoda GET, czyli podstawowy sposób odczytywania zasobów przez HTTP. Wyjaśnię, jak wygląda takie żądanie, gdzie trafiają parametry, czym różni się ono od POST oraz jak poprawnie obsłużyć je w aplikacji ASP.NET Core.
GET służy do bezpiecznego pobierania danych z aplikacji webowej
- Cel GET odczytuje zasób, na przykład listę produktów, szczegóły zamówienia albo dokument.
-
Parametry najczęściej trafiają do adresu URL jako query string, na przykład
?page=2&sort=price. - Bezpieczeństwo GET nie powinien zmieniać danych ani wykonywać operacji takich jak usuwanie czy zakup.
- Właściwości żądania GET są bezpieczne, idempotentne i mogą być buforowane.
-
Praktyka w ASP.NET Core obsłużysz je między innymi za pomocą atrybutu
[HttpGet].
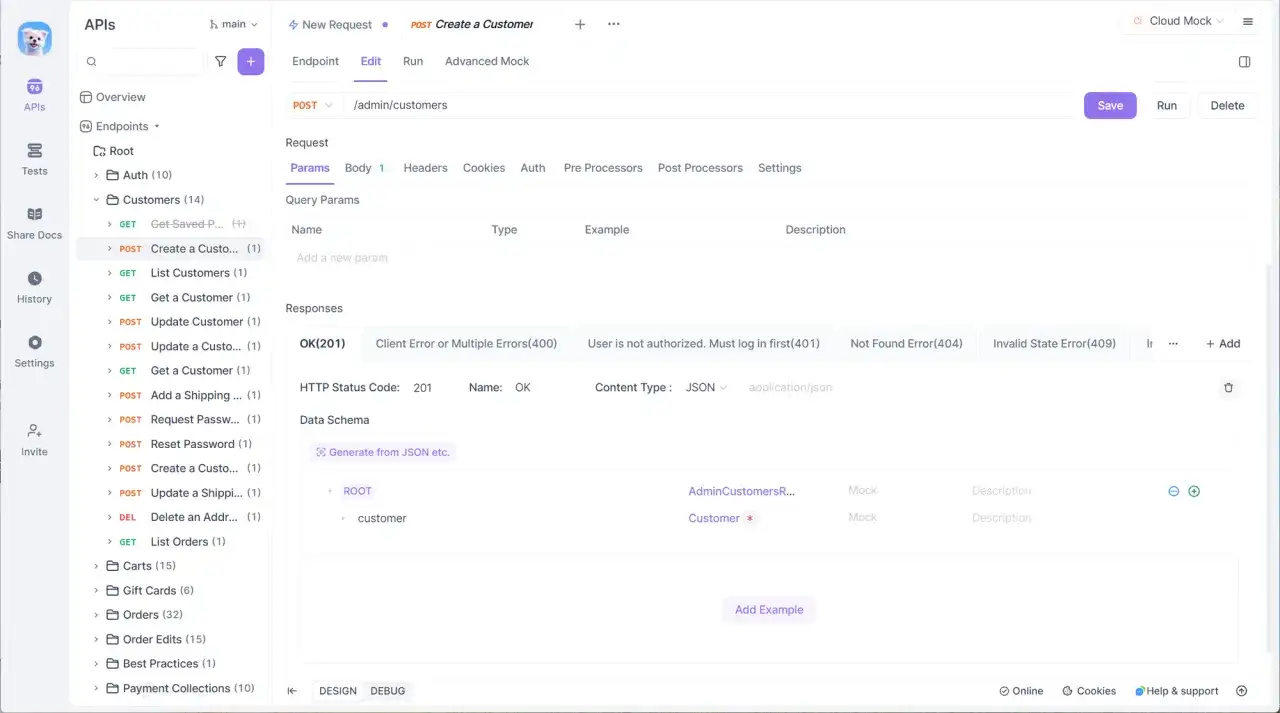
Co dokładnie robi żądanie GET
GET prosi serwer o reprezentację określonego zasobu. Tym zasobem może być strona HTML, rekord klienta, lista artykułów, plik JSON albo obraz. Serwer odbiera żądanie, odczytuje adres i parametry, a potem zwraca odpowiedź z kodem statusu oraz opcjonalną treścią.
Przykładowe żądanie może wyglądać tak:
GET /api/products/42 HTTP/1.1
Host: sklep.example.pl
Accept: application/json
W tym przypadku klient prosi o produkt o identyfikatorze 42. Nagłówek Accept podpowiada serwerowi, że oczekiwanym formatem odpowiedzi jest JSON. Sama odpowiedź może mieć kod 200 OK i zawierać dane produktu.
Najważniejsza zasada jest prosta. GET ma odczytywać stan aplikacji, a nie go zmieniać. Jeżeli otwarcie adresu powoduje usunięcie konta, naliczenie opłaty albo zmianę hasła, projekt narusza sens tego mechanizmu i może sprawiać problemy między innymi przez roboty indeksujące, prefetchnig przeglądarki czy pamięć podręczną.
Bezpieczna i idempotentna nie znaczy całkowicie pozbawiona ryzyka
W dokumentacji HTTP GET określa się jako metodę bezpieczną, ponieważ prawidłowo zaprojektowana operacja nie powinna wywoływać efektów ubocznych. Jest też idempotentna, czyli wielokrotne wykonanie tego samego żądania powinno pozostawić serwer w takim samym stanie jak pojedyncze wykonanie.
Nie oznacza to, że odpowiedź zawsze będzie identyczna. Lista wiadomości może zmienić się między dwoma wywołaniami, bo ktoś otrzymał nową wiadomość. Idempotencja dotyczy przede wszystkim tego, że samo pobranie danych nie wykonuje dodatkowej zmiany po stronie serwera.
Gdzie trafiają parametry żądania
Parametry GET najczęściej umieszcza się w adresie URL. Fragment po znaku zapytania nazywa się query stringiem, a poszczególne wartości łączy się znakiem ampersand.
GET /api/products?category=laptops&page=2&pageSize=20 HTTP/1.1Ten zapis oznacza filtrowanie produktów według kategorii, pobranie drugiej strony wyników i ograniczenie liczby elementów do 20. Parametry są czytelne, można je skopiować, zapisać w zakładce i udostępnić innemu użytkownikowi. To duża zaleta przy wyszukiwarkach, filtrach i paginacji.
| Sposób przekazania danych | Przykład | Typowe zastosowanie |
|---|---|---|
| Parametr ścieżki | /products/42 |
Pobranie konkretnego zasobu |
| Query string | /products?page=2&sort=price |
Filtrowanie, sortowanie i paginacja |
| Nagłówek HTTP |
Authorization, Accept
|
Autoryzacja i określenie formatu odpowiedzi |
Adres URL nie jest dobrym miejscem na dane wrażliwe
Parametry GET mogą trafić do historii przeglądarki, logów serwera, narzędzi analitycznych oraz nagłówka Referer. Dlatego nie umieszczam w nich haseł, tokenów dostępowych, numerów kart ani innych poufnych informacji.
HTTPS szyfruje transmisję między klientem a serwerem, ale nie ukrywa adresu przed każdym elementem infrastruktury po drodze. Jeżeli dane są wrażliwe, właściwszy będzie nagłówek autoryzacyjny albo treść żądania POST. Trzeba też pamiętać o poprawnym kodowaniu znaków, szczególnie przy polskich nazwach i wartościach zawierających spacje.
GET w ASP.NET Core wygląda prościej, niż się wydaje
W aplikacji .NET obsługę żądania można zdefiniować w kontrolerze Web API za pomocą atrybutu [HttpGet]. Framework powiąże parametry adresu z argumentami metody i zwróci wynik w formacie odpowiednim dla API.
[ApiController]
[Route("api/products")]
public class ProductsController : ControllerBase
{
    [HttpGet("{id:int}")]
    public IActionResult GetProduct(int id)
    {
        var product = new
        {
            Id = id,
            Name = "Laptop"
        };

        return Ok(product);
    }
}
Wywołanie adresu /api/products/42 trafi do metody GetProduct, a wartość 42 zostanie przekazana do parametru id. Atrybut {id:int} dodatkowo ogranicza trasę do wartości liczbowych, więc tekstowy identyfikator nie zostanie zaakceptowany przez ten endpoint.
Parametry filtrowania możesz pobrać z query stringu:
[HttpGet]
public IActionResult GetProducts(
    [FromQuery] string? category,
    [FromQuery] int page = 1,
    [FromQuery] int pageSize = 20)
{
    return Ok(new
    {
        Category = category,
        Page = page,
        PageSize = pageSize
    });
}
W praktycznym API nie zwracam bezpośrednio encji bazy danych. Lepiej użyć osobnego modelu odpowiedzi, ograniczyć maksymalną wartość pageSize i sprawdzić, czy użytkownik ma prawo zobaczyć żądane dane. Sam fakt, że operacja jest odczytem, nie wyłącza autoryzacji.
Przeczytaj również: ng command not found? Jak naprawić Angular CLI
Przykład z serwisem i asynchronicznym odczytem
W prawdziwej aplikacji kontroler powinien delegować pracę do serwisu lub warstwy dostępu do danych. Dzięki temu metoda obsługująca HTTP pozostaje krótka, a logikę można testować niezależnie.
[HttpGet]
public async Task>> GetProducts(
    [FromQuery] string? search,
    CancellationToken cancellationToken)
{
    var products = await productService
        .SearchAsync(search, cancellationToken);

    return Ok(products);
}
Parametr CancellationToken pozwala przerwać zapytanie, gdy klient zamknie stronę albo anulowane zostanie żądanie. Przy dużych zbiorach danych większą różnicę niż sam wybór GET robią paginacja, indeksy w bazie i ograniczenie liczby zwracanych pól.
GET a POST i inne metody HTTP
Najczęstszy błąd początkujących polega na traktowaniu GET i POST jako dwóch równorzędnych sposobów wysyłania formularza. Różnica nie sprowadza się jednak tylko do tego, gdzie trafiają parametry. Każda metoda opisuje inny zamiar operacji.
| Metoda | Główne przeznaczenie | Czy zmienia dane | Typowy przykład |
|---|---|---|---|
| GET | Odczyt zasobu | Nie powinna | Pobranie listy produktów |
| POST | Utworzenie zasobu lub wykonanie operacji | Zwykle tak | Dodanie zamówienia |
| PUT | Pełna aktualizacja zasobu | Tak | Zastąpienie danych profilu |
| PATCH | Częściowa aktualizacja zasobu | Tak | Zmiana samego numeru telefonu |
| DELETE | Usunięcie zasobu | Tak | Usunięcie komentarza |
Jeżeli formularz służy do wyszukania produktów, GET jest naturalnym wyborem, bo wynik można odtworzyć z adresu URL. Jeżeli formularz tworzy płatność lub rejestruje konto, potrzebujesz POST. Użycie GET do operacji zmieniającej stan może skończyć się przypadkowym wykonaniem akcji po odświeżeniu strony albo przez automatyczne narzędzie odwiedzające adres.
GET nie powinien też służyć do wysyłania bardzo dużych filtrów. Nie istnieje jeden uniwersalny limit długości URL, ponieważ ograniczenia mogą narzucać przeglądarka, serwer proxy, load balancer lub sam serwer aplikacji. Przy rozbudowanym zapytaniu lepiej rozważyć POST przeznaczony do wyszukiwania, zamiast upychać setki parametrów w adresie.
Buforowanie, statusy i wydajność
GET dobrze współpracuje z pamięcią podręczną, ponieważ wynik odczytu można często ponownie wykorzystać. Przeglądarka, CDN albo serwer pośredni może zachować odpowiedź i nie wysyłać za każdym razem identycznego żądania do aplikacji. To poprawia czas odpowiedzi i zmniejsza obciążenie backendu.
Buforowanie nie dzieje się jednak automatycznie w sposób, który zawsze będzie bezpieczny. Trzeba odpowiednio ustawić nagłówki, między innymi Cache-Control, a dla zmieniających się zasobów można wykorzystać ETag lub Last-Modified. Dane prywatne powinny mieć ostrożnie skonfigurowaną politykę cache, aby odpowiedź jednego użytkownika nie została użyta dla innego.
W API przydają się również czytelne kody odpowiedzi:
- 200 OK oznacza poprawne pobranie danych.
- 204 No Content informuje, że żądanie zakończyło się poprawnie, ale odpowiedź nie zawiera treści.
- 400 Bad Request wskazuje na niepoprawne parametry lub format zapytania.
- 401 Unauthorized oznacza brak poprawnego uwierzytelnienia.
- 403 Forbidden informuje, że użytkownik jest rozpoznany, ale nie ma odpowiednich uprawnień.
- 404 Not Found pojawia się, gdy zasób nie istnieje albo aplikacja nie chce ujawnić jego istnienia.
Wydajne GET nie polega wyłącznie na szybkim kodzie kontrolera. Jeżeli endpoint zwraca 100 tysięcy rekordów, nawet dobrze napisany backend będzie miał problem. Zacząłbym od limitu wyników, paginacji i pomiaru zapytania do bazy, a dopiero później szukałbym bardziej wyszukanych optymalizacji.
Najczęstsze błędy przy projektowaniu endpointów GET
Pierwszy błąd to umieszczanie operacji biznesowych w adresach typu /api/orders/123/delete i obsługiwanie ich przez GET. Taki endpoint wygląda wygodnie, ale miesza semantykę HTTP. Usuwanie powinno korzystać z DELETE, a operacja wymagająca dodatkowych danych najczęściej z POST.
Drugi problem to brak walidacji parametrów. Użytkownik może przesłać ujemny numer strony, ogromny rozmiar wyniku albo niepoprawną datę. W efekcie aplikacja zwróci błąd, wykona kosztowne zapytanie albo narazi bazę danych na niepotrzebne obciążenie.
Trzeci błąd dotyczy bezpieczeństwa. Ukrycie przycisku w interfejsie nie jest autoryzacją. Endpoint GET musi sam sprawdzić, czy dany użytkownik może odczytać konkretny zasób, zwłaszcza gdy identyfikator można łatwo zmienić w adresie URL.
Na końcu sprawdzam jeszcze trzy rzeczy. Czy odpowiedź nie zwraca zbyt wielu pól, czy błędy mają spójny format oraz czy logi nie zapisują przypadkiem poufnych parametrów. Te drobne kontrole często dają więcej niż kolejna warstwa abstrakcji w kodzie.
Jak zaprojektować dobry endpoint GET
-
Opisz zasób w adresie, na przykład
/api/articles/15, zamiast używać czasownika/getArticle. - Użyj query stringu do filtrowania, sortowania i paginacji.
- Nie zmieniaj danych podczas obsługi żądania odczytu.
- Waliduj parametry, w tym zakresy liczb, daty i maksymalną liczbę wyników.
- Chroń dane przez uwierzytelnianie, autoryzację i HTTPS.
- Zwracaj właściwe kody HTTP, aby klient wiedział, co się wydarzyło.
- Uwzględnij cache, ale nie przechowuj publicznie odpowiedzi zawierających dane prywatne.
- Testuj powtarzalność, bo to samo żądanie powinno być bezpieczne przy wielokrotnym wywołaniu.
Dobrze zaprojektowany endpoint GET jest przewidywalny dla przeglądarki, klienta mobilnego, aplikacji .NET i narzędzi testowych. Ta przewidywalność ma realną wartość, bo upraszcza integracje i ogranicza liczbę wyjątków w kodzie.
Jedna praktyczna zasada, która porządkuje całe API
Gdy projektuję API, zadaję sobie jedno pytanie: czy użytkownik lub system może bez obaw powtórzyć to żądanie? Jeżeli odpowiedź brzmi tak, a operacja tylko odczytuje dane, GET prawdopodobnie pasuje. Jeżeli wywołanie tworzy, zmienia albo usuwa coś na serwerze, wybieram inną metodę HTTP i jasno opisuję jej konsekwencje.
Najważniejsze nie jest zapamiętanie samego atrybutu [HttpGet], lecz zrozumienie kontraktu, który za nim stoi. GET pobiera dane, parametry najczęściej niesie w URL, może być buforowany i nie powinien powodować efektów ubocznych. Trzymanie się tych zasad daje aplikację łatwiejszą do testowania, bezpieczniejszą i znacznie prostszą w utrzymaniu.