Gdy dane mają naturalną hierarchię, zwykła lista szybko przestaje być wygodna. Drzewo binarne porządkuje elementy tak, aby każdy węzeł miał najwyżej dwoje dzieci, a odpowiednio zaprojektowana struktura pozwala sprawnie wyszukiwać, dodawać i przeglądać dane. Pokażę, jak działa, czym różni się zwykła wersja od BST oraz jak zaimplementować ją w C# i kiedy lepiej skorzystać z gotowych kolekcji .NET.
Najważniejsze informacje o strukturze i jej zastosowaniach
- Maksymalnie dwoje dzieci odróżnia tę strukturę od drzew o dowolnej liczbie gałęzi.
- BST wykorzystuje regułę porządku, dzięki której wyszukiwanie może działać w czasie O(log n).
- Niezrównoważenie może pogorszyć wydajność do O(n), dlatego kształt drzewa ma duże znaczenie.
- Przejścia preorder, inorder i postorder służą do różnych zadań, od wyświetlania danych po usuwanie całej struktury.
-
SortedSet
w .NET jest gotową, samobalansującą kolekcją opartą na drzewie czerwono-czarnym.
Jak działa struktura z dwoma dziećmi
Podstawowym elementem jest węzeł, który przechowuje wartość oraz odwołania do lewego i prawego dziecka. Pierwszy węzeł to korzeń, a element bez dzieci nazywamy liściem. W przeciwieństwie do tablicy dane nie muszą leżeć obok siebie w pamięci, bo relacje między nimi wynikają z połączeń między węzłami.
Sama zasada jest prosta: jeden węzeł może mieć zero, jedno albo dwa dzieci. Nie oznacza to jednak, że wartości muszą być ułożone rosnąco. Zwykła struktura może przechowywać dowolne zależności, na przykład wyrażenie matematyczne, gdzie operator znajduje się wyżej, a jego argumenty są dziećmi.
| Pojęcie | Znaczenie |
|---|---|
| Korzeń | Początkowy węzeł, od którego zaczyna się cała struktura. |
| Rodzic | Węzeł, który wskazuje na jedno lub dwoje dzieci. |
| Liść | Węzeł bez dzieci. |
| Wysokość | Liczba poziomów lub krawędzi na najdłuższej ścieżce od korzenia do liścia, zależnie od przyjętej definicji. |
| Poddrzewo | Dowolny węzeł wraz z całą strukturą znajdującą się pod nim. |
W praktyce spotykam kilka określeń opisujących kształt drzewa. Drzewo pełne ma węzły posiadające albo dokładnie dwoje dzieci, albo żadnego. Drzewo kompletne wypełnia poziomy od lewej do prawej, a drzewo zrównoważone utrzymuje podobną wysokość po obu stronach. To właśnie wysokość, a nie sama liczba elementów, często decyduje o szybkości operacji.
Dlaczego BST jest czymś więcej niż zwykłym drzewem
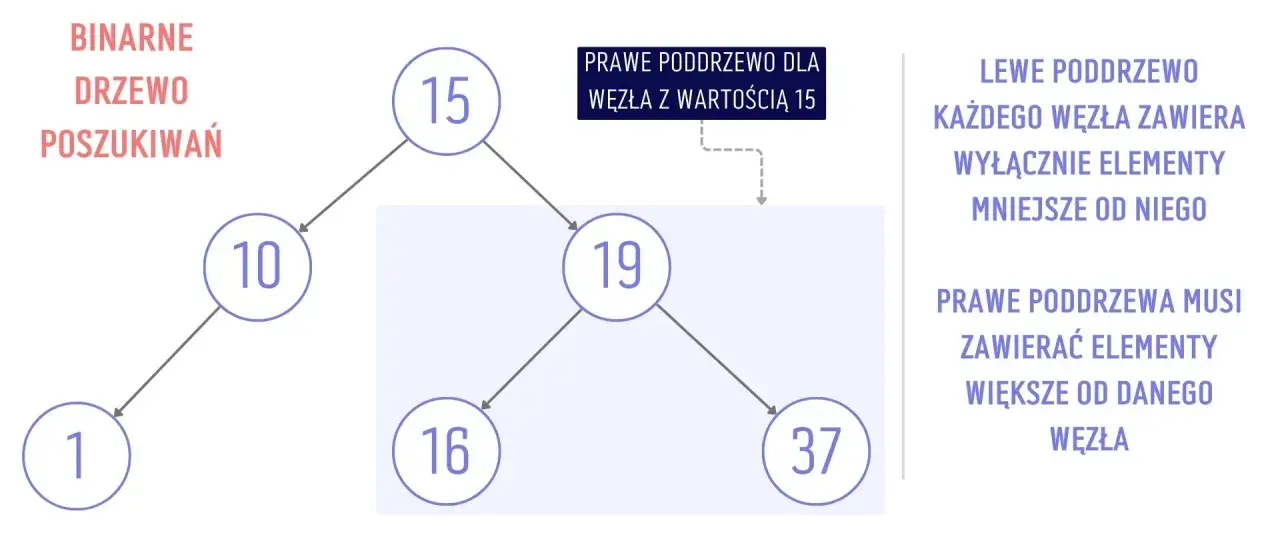
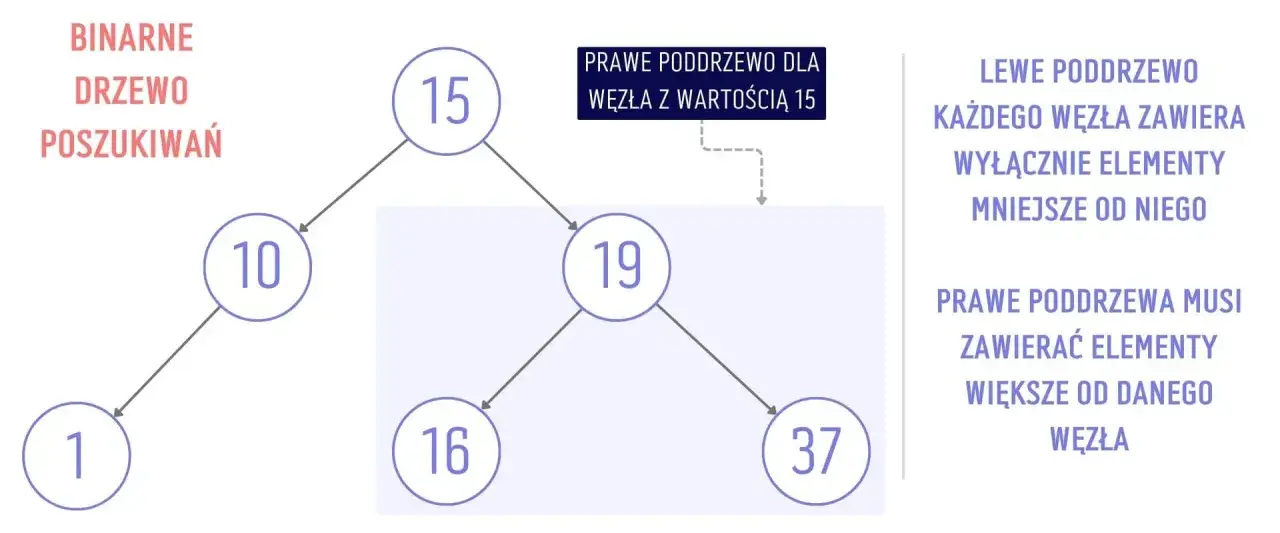
Najczęściej na zajęciach i rozmowach rekrutacyjnych pojawia się drzewo wyszukiwań binarnych, czyli BST. Tutaj każdy element w lewym poddrzewie jest mniejszy od wartości w bieżącym węźle, a elementy po prawej stronie są większe. Dla przykładu po wstawieniu liczb 8, 3, 10, 1 i 6 wyszukanie liczby 6 nie wymaga sprawdzania wszystkich elementów.
Algorytm porównuje szukaną wartość z korzeniem. Gdy jest mniejsza, schodzi w lewo, gdy większa, wybiera prawą gałąź. W idealnie zrównoważonej strukturze po każdym kroku pomijamy mniej więcej połowę pozostałych danych, więc operacja ma koszt O(log n).
Problem pojawia się wtedy, gdy wartości trafiają do drzewa w już posortowanej kolejności. Wstawienie 1, 2, 3, 4 i 5 może utworzyć strukturę przypominającą listę jednokierunkową. Wtedy wyszukiwanie, dodawanie i usuwanie spadają do O(n). Z tego powodu sam fakt użycia dwóch dzieci nie gwarantuje dobrej wydajności.
Najważniejsze warianty
- Niezrównoważone BST jest łatwe do napisania, ale wrażliwe na kolejność danych.
- AVL pilnuje różnicy wysokości poddrzew i często zapewnia bardzo szybkie wyszukiwanie.
- Drzewo czerwono-czarne stosuje słabsze ograniczenia równowagi, ale sprawnie obsługuje częste modyfikacje.
- Kopiec binarny nie służy do ogólnego wyszukiwania, tylko do szybkiego pobierania minimum albo maksimum.
Te warianty nie są wymiennymi nazwami. Kopiec ma inną regułę niż BST, a AVL i drzewa czerwono-czarne wymagają rotacji, czyli kontrolowanych zmian połączeń między węzłami. Sam zaczynam od prostego BST, gdy celem jest nauka, ale w kodzie produkcyjnym nie implementuję balansu bez wyraźnej potrzeby.
Prosta implementacja w C#
Minimalny model można zbudować za pomocą generycznego węzła. Ograniczenie IComparable
public sealed class Node
    where T : IComparable
{
    public T Value { get; }
    public Node? Left { get; set; }
    public Node? Right { get; set; }

    public Node(T value)
    {
        Value = value;
    }
}
Metoda wstawiająca schodzi rekurencyjnie w lewo lub w prawo, aż znajdzie puste miejsce. W tym przykładzie duplikaty są pomijane, ale w realnym projekcie można zamiast tego przechowywać licznik wystąpień albo kierować równe wartości do ustalonej gałęzi.
public static Node Insert(Node? node, T value)
    where T : IComparable
{
    if (node is null)
        return new Node(value);

    int comparison = value.CompareTo(node.Value);

    if (comparison < 0)
        node.Left = Insert(node.Left, value);
    else if (comparison > 0)
        node.Right = Insert(node.Right, value);

    return node;
}
Wyszukiwanie wygląda podobnie, ale nie tworzy nowych węzłów. Zwracam wartość logiczną, ponieważ w aplikacji często nie potrzebuję całego węzła, tylko informacji, czy element istnieje.
public static bool Contains(Node? node, T value)
    where T : IComparable
{
    while (node is not null)
    {
        int comparison = value.CompareTo(node.Value);

        if (comparison == 0)
            return true;

        node = comparison < 0
            ? node.Left
            : node.Right;
    }

    return false;
}
Wersja iteracyjna ma tu praktyczną przewagę. Przy bardzo wysokim, źle zbalansowanym drzewie rekurencja może doprowadzić do przepełnienia stosu, a pętla nie zwiększa głębokości wywołań. To drobny szczegół, który łatwo przeoczyć w przykładzie edukacyjnym.
Przeczytaj również: static w C# - metody, pola i klasy bez typowych pułapek
Usuwanie wymaga obsługi trzech przypadków
Usunięcie liścia jest proste. Gdy węzeł ma jedno dziecko, jego rodzic przejmuje to dziecko. Najtrudniejszy jest węzeł z dwójką dzieci, ponieważ trzeba zastąpić jego wartość najmniejszym elementem z prawego poddrzewa albo największym elementem z lewego poddrzewa, a potem usunąć ten zastępczy węzeł.
To właśnie usuwanie najczęściej ujawnia, czy implementacja naprawdę rozumie strukturę, czy tylko odtwarza schemat z podręcznika. Trzeba uważać na usuwanie korzenia, wartości duplikowane oraz zmianę referencji w rodzicu.
Przechodzenie po węzłach daje różne wyniki
Przejście, czyli traversal, określa kolejność odwiedzania elementów. Dla drzewa z korzeniem 8, lewym poddrzewem 3 i prawym 10 wynik zależy od tego, czy odwiedzimy rodzica przed dziećmi, pomiędzy nimi czy po nich.
| Rodzaj przejścia | Kolejność | Typowe zastosowanie |
|---|---|---|
| Preorder | Węzeł, lewe poddrzewo, prawe poddrzewo | Kopiowanie struktury lub zapis drzewa. |
| Inorder | Lewe poddrzewo, węzeł, prawe poddrzewo | Odczyt wartości BST w kolejności rosnącej. |
| Postorder | Lewe poddrzewo, prawe poddrzewo, węzeł | Usuwanie struktury lub obliczanie wyrażeń. |
| BFS | Poziomami od korzenia | Analiza poziomów i najkrótszych ścieżek w strukturze. |
Najbardziej użyteczne w BST jest przejście inorder, bo dzięki regule porządku zwraca dane rosnąco. Rekurencyjna implementacja jest krótka, ale do dużych struktur można użyć stosu jawnego, aby mieć pełną kontrolę nad pamięcią.
public static void InOrder(Node? node, List result)
    where T : IComparable
{
    if (node is null)
        return;

    InOrder(node.Left, result);
    result.Add(node.Value);
    InOrder(node.Right, result);
}
Do przechodzenia poziomami wykorzystuję kolejkę. Każdy zdjęty z kolejki węzeł dodaje swoje dzieci, więc struktura odwiedzana jest warstwami, a nie w głąb.
public static IEnumerable BreadthFirst(Node root)
    where T : IComparable
{
    var queue = new Queue>();
    queue.Enqueue(root);

    while (queue.Count > 0)
    {
        var node = queue.Dequeue();
        yield return node.Value;

        if (node.Left is not null)
            queue.Enqueue(node.Left);

        if (node.Right is not null)
            queue.Enqueue(node.Right);
    }
}
Złożoność operacji i wybór kolekcji w .NET
Dla zrównoważonej struktury wyszukiwanie, wstawianie i usuwanie mają koszt O(log n). Przejście po wszystkich elementach zawsze wymaga O(n), bo każdy węzeł musi zostać odwiedzony. Pamięć potrzebna na same węzły wynosi O(n), a dodatkowa pamięć zależy od rekurencji lub użytego stosu i kolejki.
| Operacja | Drzewo zrównoważone | Najgorszy przypadek |
|---|---|---|
| Wyszukiwanie | O(log n) | O(n) |
| Wstawianie | O(log n) | O(n) |
| Usuwanie | O(log n) | O(n) |
| Przejście po wszystkich elementach | O(n) | O(n) |
W aplikacji .NET rzadko potrzebuję pisać własny balansujący wariant. SortedSet
Nie wybieram jednak kolekcji sortowanej automatycznie. Jeśli liczy się wyłącznie szybkie sprawdzanie obecności elementu i kolejność nie ma znaczenia, HashSet
Typowe błędy podczas pracy z tą strukturą
Początkujący często zakładają, że każde drzewo z dwoma dziećmi automatycznie umożliwia szybkie wyszukiwanie. To nieprawda. Reguła porządku BST musi być zachowana dla całych poddrzew, nie tylko dla bezpośrednich dzieci.
Drugim błędem jest pomijanie wartości null. Puste lewe lub prawe dziecko jest normalnym stanem, a kod powinien jasno go obsługiwać. W C# nullable reference types pomagają oznaczyć ten fakt typem Node
- Nie zakładaj, że dane wejściowe będą losowe i dobrze zbalansują strukturę.
- Ustal z góry, co zrobić z duplikatami.
- Nie mieszaj zasad BST z zasadami kopca binarnego.
- Przy dużych danych rozważ wersję iteracyjną albo gotową kolekcję.
- Testuj osobno pustą strukturę, jeden element, usuwanie korzenia i wartości powtarzające się.
W testach warto sprawdzać nie tylko wynik wyszukiwania, lecz także własność uporządkowania. Najprościej wykonać przejście inorder i upewnić się, że otrzymana lista jest rosnąca. Taki test łapie błędy, których pojedyncze wywołanie metody Contains mogłoby nie ujawnić.
Jak podejść do tego tematu w projekcie .NET
Do nauki algorytmów własna implementacja jest bardzo dobrym ćwiczeniem, bo pokazuje działanie referencji, rekurencji, rotacji i złożoności obliczeniowej. W kodzie biznesowym zacząłbym jednak od pytania, czy naprawdę potrzebuję ręcznie zarządzać węzłami.
Jeśli potrzebujesz unikalnych, uporządkowanych wartości, wybierz SortedSet
Najważniejsza lekcja jest prosta: dwa odwołania w węźle to dopiero początek. O wydajności decydują porządek danych, wysokość struktury i sposób obsługi przypadków brzegowych. Kiedy te trzy elementy są świadomie zaprojektowane, drzewa binarne przestają być abstrakcyjnym tematem z algorytmiki i stają się praktycznym narzędziem w C#.