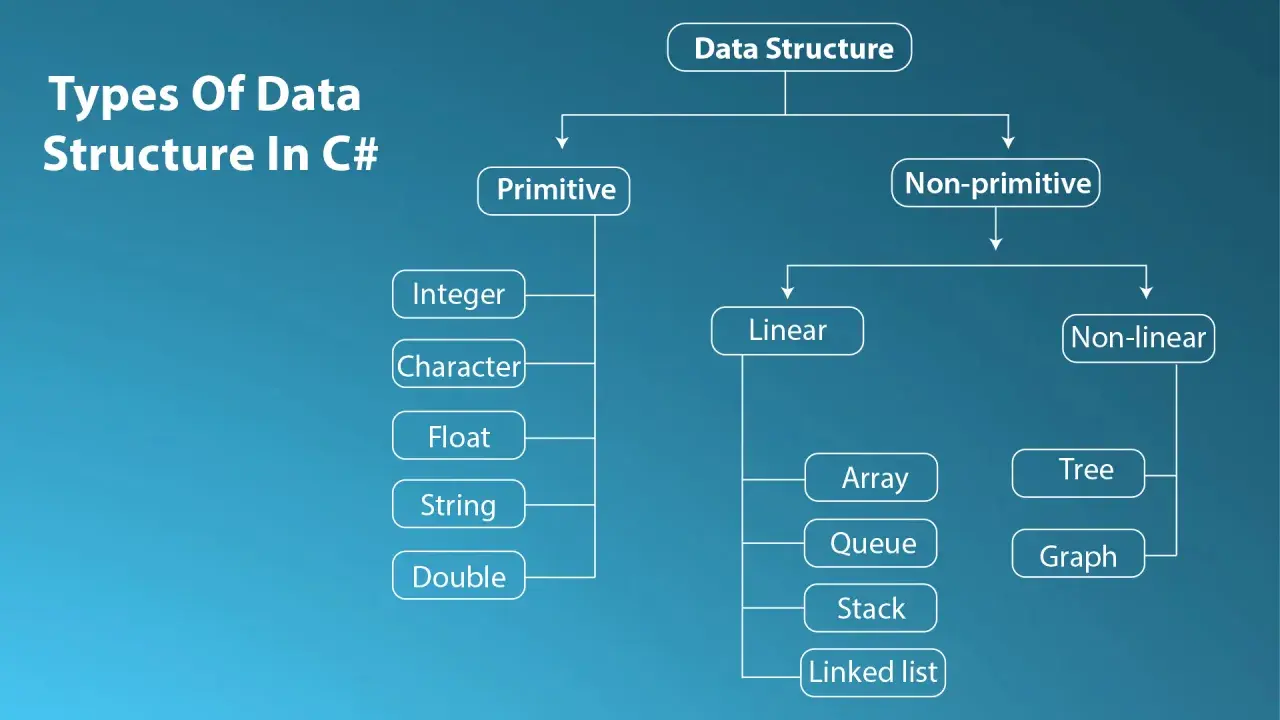
W świecie .NET określenie c# collections obejmuje wszystkie sposoby przechowywania i obsługi grup obiektów. Największy problem zwykle nie polega na znajomości nazw klas, lecz na dobraniu kolekcji do sposobu pracy z danymi: indeksu, klucza, kolejności, unikalności albo współbieżności. Pokażę najważniejsze typy, ich ograniczenia, złożoność operacji i praktyczne reguły wyboru.
Dobra kolekcja wynika z operacji, które wykonujesz najczęściej
-
List
sprawdza się jako domyślna, dynamiczna lista z dostępem przez indeks. -
Dictionary
wybierz wtedy, gdy dane wyszukujesz po kluczu. -
HashSet
służy do unikalnych elementów i szybkiego sprawdzania obecności. -
Queue
obsługuje kolejkę FIFO, a Stack stos LIFO. -
ConcurrentDictionary
i inne kolekcje współbieżne są przeznaczone do dostępu z wielu wątków. - W publicznych API często lepiej zwracać IReadOnlyList
lub IEnumerable niż konkretną implementację.
Najpierw wybierz sposób dostępu do danych
Kolekcja nie jest tylko pojemnikiem na obiekty. Każdy typ narzuca określony model pracy. Zanim napiszę new List, zastanawiam się, czy będę potrzebował elementów w konkretnej kolejności, wyszukiwania po identyfikatorze, usuwania z początku czy może wyłącznie informacji, czy dana wartość już wystąpiła.
Najprostszy podział wygląda tak. Sekwencja przechowuje elementy w kolejności i zwykle daje dostęp przez indeks. Słownik wiąże klucz z wartością. Zbiór pilnuje unikalności, a kolejka i stos definiują kolejność obsługi elementów.
| Potrzeba | Najczęstszy wybór | Dlaczego |
|---|---|---|
| Dostęp przez pozycję | List |
Szybki indeks i dynamiczny rozmiar |
| Stała liczba elementów | T[] |
Prosta, szybka struktura o stałym rozmiarze |
| Wyszukiwanie po kluczu | Dictionary |
Zwykle stałoczasowy dostęp do wartości |
| Unikalne elementy | HashSet |
Nie dopuszcza duplikatów i szybko sprawdza obecność |
| Obsługa FIFO | Queue |
Pierwszy dodany element jest obsługiwany jako pierwszy |
| Obsługa LIFO | Stack |
Ostatni dodany element jest pobierany jako pierwszy |
W praktyce najczęściej zaczynam od List
List, tablica czy LinkedList
List jako domyślna lista robocza
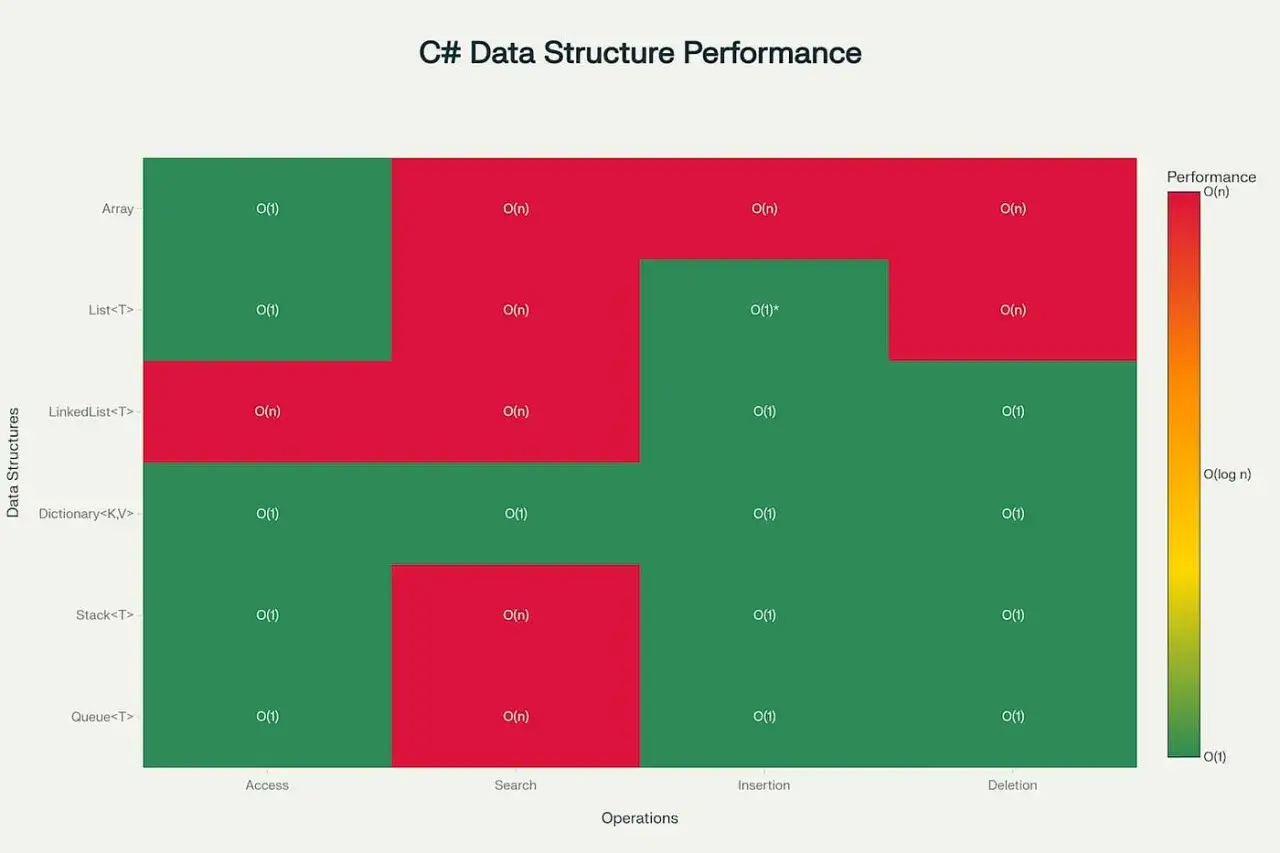
List przechowuje elementy w wewnętrznej tablicy i automatycznie zwiększa jej pojemność. Odczyt przez indeks, na przykład products[10], ma złożoność O(1). Dodawanie na końcu jest średnio bardzo szybkie, ale przy powiększaniu wewnętrznej tablicy może wymagać realokacji i skopiowania elementów.
var tags = new List { "azure", "dotnet" };

tags.Add("csharp");
tags.Remove("azure");

foreach (var tag in tags)
{
    Console.WriteLine(tag);
}
Jeśli znam przybliżoną liczbę elementów, ustawiam pojemność początkową. To drobna decyzja, która przy dużych kolekcjach ogranicza liczbę realokacji.
var events = new List(capacity: 10_000); Największym ograniczeniem listy jest wstawianie i usuwanie w środku. Wszystkie kolejne elementy muszą zostać przesunięte, więc operacja kosztuje zwykle O(n). Lista pasuje zatem do odczytu po indeksie i dopisywania na końcu, ale nie do częstego usuwania z początku.
Kiedy lepsza będzie tablica
Tablica T[] ma stały rozmiar po utworzeniu. Wybieram ją, gdy liczba pozycji jest znana albo gdy przekazuję dane do API, które pracuje właśnie na tablicach. Daje szybki dostęp indeksowany i ma niewielki narzut, ale nie oferuje wygodnej zmiany rozmiaru.
int[] points = [10, 20, 30, 40];

Console.WriteLine(points[2]);
Od C# 12 można używać wyrażeń kolekcji, czyli krótkiej składni z nawiasami kwadratowymi. Ten sam zapis może utworzyć tablicę, listę lub inną obsługiwaną kolekcję zależnie od typu docelowego.
int[] numbers = [1, 2, 3];
List mutableNumbers = [1, 2, 3];

int[] extended = [..numbers, 4, 5];
Dlaczego LinkedList rzadko jest pierwszym wyborem
LinkedList dobrze radzi sobie z dodawaniem i usuwaniem elementu, gdy masz już konkretny węzeł. Nie zapewnia jednak szybkiego dostępu przez indeks, a znalezienie elementu po wartości nadal wymaga przejścia po kolekcji.
W aplikacjach biznesowych częściej wybieram List
Dictionary i HashSet rozwiązują dwa różne problemy
Dictionary do wyszukiwania po kluczu
Słownik przechowuje pary klucz-wartość. Jeżeli mam kolekcję użytkowników i często pobieram użytkownika po identyfikatorze, słownik jest naturalnym wyborem.
var usersById = new Dictionary
{
    [101] = new User("Anna"),
    [102] = new User("Piotr")
};

if (usersById.TryGetValue(101, out var user))
{
    Console.WriteLine(user.Name);
}
Średni koszt dodania i wyszukania elementu to O(1), choć zależy od jakości funkcji haszującej i rozkładu kluczy. Do bezpiecznego odczytu preferuję TryGetValue, ponieważ nie rzuca wyjątku, gdy klucza nie ma.
Trzeba też pamiętać, że klucz musi mieć poprawnie zdefiniowaną równość i funkcję GetHashCode. Dla własnych typów błędna implementacja porównywania może powodować trudne do zauważenia problemy z odnajdywaniem elementów.
HashSet do unikalności i szybkiego Contains
HashSet nie przechowuje par klucz-wartość. Jego zadaniem jest reprezentowanie zbioru unikalnych elementów oraz szybkie sprawdzanie, czy element należy do zbioru.
var enabledFeatures = new HashSet(
    StringComparer.OrdinalIgnoreCase)
{
    "reports",
    "export"
};

if (enabledFeatures.Contains("EXPORT"))
{
    Console.WriteLine("Eksport jest włączony");
}
To dobry wybór przy filtrowaniu duplikatów, sprawdzaniu uprawnień albo porównywaniu dwóch grup wartości. HashSet nie zachowuje kolejności biznesowej, więc nie używam go tam, gdzie kolejność wyświetlania ma znaczenie.
Jeżeli elementy mają być uporządkowane, rozważam SortedSet. Operacje są wtedy zwykle wolniejsze, około O(log n), ale zbiór utrzymuje porządek zgodny z komparatorem.
Klucz może wymagać własnego porównywania
Dla napisów świadomie wybieram sposób porównywania. Domyślne porównanie może być wrażliwe na wielkość liter, a w przypadku identyfikatorów technicznych często chcę zachowania niewrażliwego na wielkość liter.
var settings = new Dictionary(
    StringComparer.OrdinalIgnoreCase);

settings["Theme"] = "dark";

Console.WriteLine(settings["theme"]);
To nie jest kosmetyka. Comparer wpływa na to, czy dwa klucze są uznane za takie same, dlatego powinien wynikać z reguł domeny, a nie z przypadkowego ustawienia.
Queue, Stack i kolekcje do przetwarzania zadań
Queue stosuję wtedy, gdy elementy mają być obsługiwane w kolejności napływu. To klasyczny model FIFO, przydatny przy kolejce poleceń, zadaniach do wykonania albo przetwarzaniu komunikatów.
var jobs = new Queue();

jobs.Enqueue("send-email");
jobs.Enqueue("generate-report");

var nextJob = jobs.Dequeue();
Operacje Enqueue i Dequeue są zwykle wykonywane w czasie O(1). Jeżeli tylko sprawdzam pierwszy element, używam Peek, a nie Dequeue, ponieważ ta druga metoda usuwa element.
Stack działa odwrotnie. Ostatni dodany element jest pobierany jako pierwszy, czyli obowiązuje zasada LIFO. Przydaje się przy historii operacji, cofaniu zmian, analizie wyrażeń i przechodzeniu po strukturach.
var pages = new Stack();

pages.Push("/home");
pages.Push("/orders");

var previousPage = pages.Pop();
Częsty błąd polega na używaniu List jako kolejki przez usuwanie elementu o indeksie zero. Taka operacja przesuwa całą resztę listy i może kosztować O(n). Do FIFO lepiej użyć właściwej abstrakcji.
Gdy wiele wątków korzysta z tej samej kolekcji
List, Dictionary i Queue nie stają się bezpieczne tylko dlatego, że są używane w aplikacji asynchronicznej. Asynchroniczność i współbieżność to różne problemy. Jeżeli wiele wątków jednocześnie modyfikuje kolekcję, potrzebujesz synchronizacji albo typu przeznaczonego do takiego scenariusza.
| Scenariusz | Typ | Praktyczna rola |
|---|---|---|
| Wspólny słownik wielu wątków | ConcurrentDictionary |
Bezpieczne dodawanie i odczyt kluczy |
| Wspólna kolejka producentów i konsumentów | ConcurrentQueue |
Bezpieczna kolejka FIFO |
| Wspólny stos | ConcurrentStack |
Bezpieczna obsługa LIFO |
| Ograniczona kolejka z blokowaniem | BlockingCollection |
Kontrola producentów, konsumentów i pojemności |
Nie dodaję blokady na ślepo. Zewnętrzny lock może być wystarczający przy prostym, lokalnym przypadku, ale przy wielu operacjach i dużej liczbie wątków lepiej zacząć od System.Collections.Concurrent. Synchronizacja ma koszt, więc warto dopasować ją do rzeczywistego obciążenia.
Wydajność to nie tylko liczba elementów
Dwie kolekcje mogą przechowywać te same dane, ale zupełnie inaczej reagować na operacje. Dlatego podczas wyboru patrzę na to, co kod robi najczęściej, a nie tylko na liczbę rekordów.
| Operacja | List |
Dictionary |
HashSet |
Queue/Stack |
|---|---|---|---|---|
| Odczyt po indeksie | O(1) | Nie dotyczy | Nie dotyczy | Nie jest głównym zastosowaniem |
| Wyszukanie elementu | O(n) | Średnio O(1) po kluczu | Średnio O(1) | O(n), jeśli szukasz wewnątrz |
| Dodanie na końcu | Średnio O(1) | Średnio O(1) | Średnio O(1) | O(1) |
| Usunięcie ze środka | O(n) | Średnio O(1) po kluczu | Średnio O(1) | Nie jest głównym zastosowaniem |
Notacja O(n) opisuje wzrost kosztu wraz z liczbą elementów. Nie oznacza automatycznie, że operacja jest wolna dla małej kolekcji. Jeśli lista ma 20 elementów, liniowe wyszukiwanie może być prostsze i wystarczająco szybkie. Problemy pojawiają się wtedy, gdy kod wykonuje taką operację tysiące razy albo dane rosną bez kontroli.
Nie optymalizuję kolekcji wyłącznie na podstawie tabeli złożoności. Liczą się również alokacje pamięci, lokalność danych, koszt sortowania, częstotliwość modyfikacji i czytelność kodu. Profilowanie powinno rozstrzygać spory, gdy różnica ma znaczenie dla działania aplikacji.
Jak projektować API i unikać typowych błędów
Nie wystawiaj modyfikowalnej kolekcji bez potrzeby
Jeżeli metoda tylko zwraca dane, nie zawsze chcę oddawać klientowi List. Odbiorca może wtedy zmodyfikować kolekcję albo zacząć polegać na jej konkretnej implementacji.
public IReadOnlyList GetFeaturedProducts()
{
    return _products;
}
IReadOnlyList komunikuje, że odbiorca może czytać elementy i używać indeksu, ale nie powinien zmieniać kolekcji przez ten interfejs. Gdy potrzebuję wyłącznie sekwencyjnego odczytu, wystarczy IEnumerable. To ma znaczenie także dla opóźnionego wykonania LINQ, dlatego trzeba wiedzieć, czy wynik jest już zmaterializowany.
Nie używaj starego System.Collections bez powodu
Typy takie jak ArrayList i Hashtable przechowują elementy jako object. Wymagają rzutowania i pozwalają wprowadzić do kolekcji wartości różnych typów, co przesuwa błędy z kompilacji na uruchomienie programu.
W nowym kodzie wybieram kolekcje generyczne, takie jak Listobject.
Uważaj na duplikaty, równość i kolejność
Dodanie tego samego obiektu do listy jest dozwolone. W słowniku drugi wpis z tym samym kluczem może zakończyć się wyjątkiem przy użyciu Add albo zastąpieniem wartości przy użyciu indeksatora. Zbiór z kolei odrzuci duplikat zgodnie z regułami równości.
Nie opieram logiki biznesowej na kolejności elementów w słowniku. Jeżeli kolejność jest częścią wymagania, używam listy, sortowanej kolekcji albo jawnie sortuję wynik. Struktura danych powinna odzwierciedlać regułę biznesową, a nie przypadkowe zachowanie aktualnej implementacji.
Przeczytaj również: Jak odwrócić string w C# i nie zepsuć Unicode?
Rozważ niezmienność przy współdzielonym stanie
Kolekcje z przestrzeni System.Collections.Immutable tworzą nowe wersje danych zamiast modyfikować istniejącą kolekcję. To wygodne, gdy wiele części programu ma bezpiecznie czytać ten sam stan albo gdy chcę uniknąć przypadkowych zmian.
var roles = ImmutableHashSet.Create("reader", "editor");
var updatedRoles = roles.Add("admin");

Console.WriteLine(roles.Contains("admin"));        // false
Console.WriteLine(updatedRoles.Contains("admin")); // true
Nie używam ich automatycznie wszędzie. Niezmienność upraszcza współdzielenie danych, ale kolejne wersje mogą mieć większy koszt niż zwykła modyfikacja listy. To świadomy kompromis między bezpieczeństwem stanu a narzutem operacji.
Najprostsza reguła, która zwykle prowadzi do dobrej decyzji
Jeżeli potrzebujesz zwykłej, zmiennej sekwencji, zacznij od List. Gdy odczyt odbywa się po kluczu, wybierz Dictionary, a gdy najważniejsza jest unikalność, użyj HashSet. Do kolejności FIFO i LIFO służą odpowiednio Queue oraz Stack.
Najwięcej problemów pojawia się wtedy, gdy kolekcję dobiera się według przyzwyczajenia. Ja zaczynam od pytania o najczęstszą operację, sprawdzam wymagania dotyczące kolejności i duplikatów, a dopiero potem rozważam współbieżność, niezmienność i optymalizację pamięci. Taka kolejność decyzji prowadzi zwykle do kodu, który jest jednocześnie czytelny, przewidywalny i wystarczająco szybki.