Gdy trzeba odwrócić kolejność znaków w tekście, sam kod jest prosty. Schody zaczynają się dopiero wtedy, gdy trzeba wybrać rozwiązanie odpowiednie dla wydajności, czytelności albo znaków Unicode. Poniżej pokazuję kilka praktycznych metod w C#, ich ograniczenia oraz sytuacje, w których zwykłe odwrócenie znaków może dać błędny rezultat.
Najważniejsze informacje o odwracaniu stringa w C#
-
Najprostsza metoda korzysta z tablicy znaków i
Array.Reverse. - LINQ pozwala zapisać rozwiązanie krótko, ale tworzy dodatkowe obiekty.
- Pętla i StringBuilder dają pełną kontrolę nad działaniem algorytmu.
-
Znaki Unicode mogą zajmować więcej niż jeden element
char. - Text elements są bezpieczniejszym wyborem dla emoji i znaków diakrytycznych.
Najprostszy sposób wykorzystuje tablicę znaków
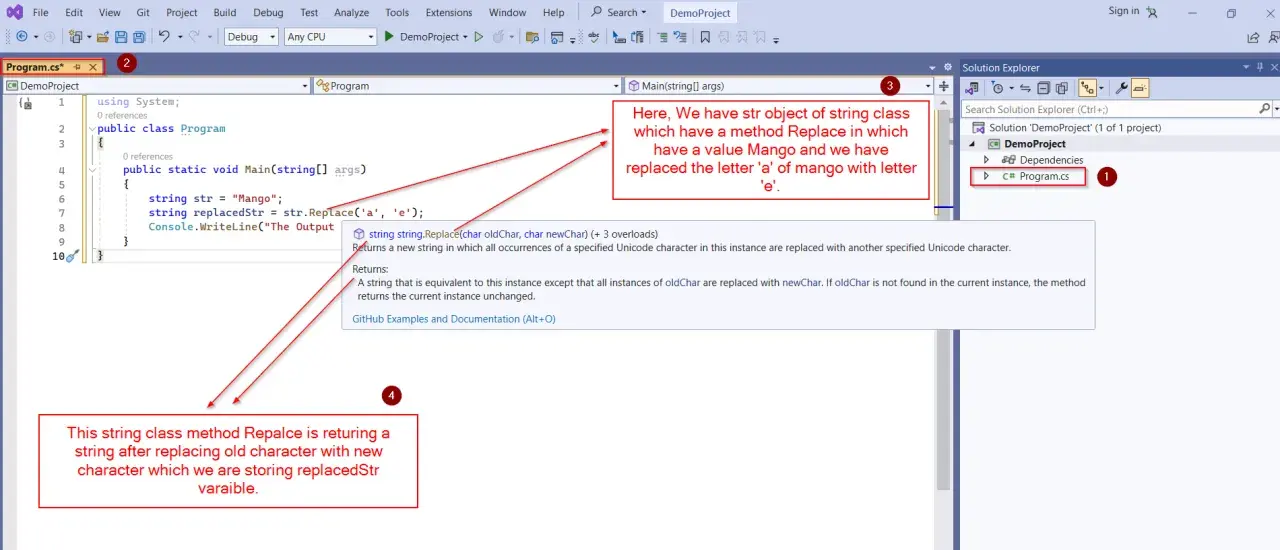
String w C# jest niemodyfikowalny, czyli po utworzeniu nie zmieniamy jego zawartości bez stworzenia nowej wartości. Dlatego najpierw zamieniam tekst na tablicę char, odwracam jej kolejność, a na końcu tworzę nowy string.
static string ReverseString(string value)
{
    if (value is null)
        throw new ArgumentNullException(nameof(value));

    char[] characters = value.ToCharArray();
    Array.Reverse(characters);

    return new string(characters);
}
Dla wejścia "Kursdotnet" metoda zwróci "tendotsruK". To rozwiązanie jest moim domyślnym wyborem w małych narzędziach, zadaniach rekrutacyjnych i kodzie, w którym liczy się przede wszystkim czytelność.
Pusta wartość zadziała bez dodatkowych warunków i zwróci pusty string. Dla null lepiej od razu zgłosić wyjątek, zamiast pozwolić, aby błąd pojawił się przypadkiem w ToCharArray().
Trzy popularne warianty rozwiązania
Odwracanie przez LINQ
Jeżeli projekt już używa LINQ, można zapisać tę operację bardzo krótko. Metoda Reverse() odwraca kolejność elementów sekwencji, a ToArray() materializuje wynik jako tablicę znaków.
using System.Linq;

static string ReverseWithLinq(string value)
{
    if (value is null)
        throw new ArgumentNullException(nameof(value));

    return new string(value.Reverse().ToArray());
}
To dobry zapis do krótkiego fragmentu kodu, ale nie traktowałbym go jako automatycznie najlepszego. LINQ tworzy sekwencję, tablicę i końcowy string, więc przy bardzo częstych wywołaniach może generować więcej alokacji niż prostsza pętla.
Odwracanie za pomocą pętli
Pętla pokazuje algorytm bez żadnej magii. Przechodzimy po tekście od ostatniego znaku do pierwszego i dopisujemy kolejne elementy do StringBuilder.
using System.Text;

static string ReverseWithLoop(string value)
{
    if (value is null)
        throw new ArgumentNullException(nameof(value));

    var result = new StringBuilder(value.Length);

    for (int i = value.Length - 1; i >= 0; i--)
    {
        result.Append(value[i]);
    }

    return result.ToString();
}
Złożoność czasowa wynosi O(n), gdzie n oznacza długość tekstu. StringBuilder ogranicza problem wielokrotnego tworzenia nowych stringów, który pojawiłby się przy naiwnym kodzie w rodzaju result += value[i] wykonywanym w pętli.
Odwracanie tablicy przez Span
W nowszych wersjach .NET można użyć Span, czyli lekkiego widoku na fragment pamięci. W tym przypadku odwracamy tablicę bez korzystania z LINQ.
static string ReverseWithSpan(string value)
{
    if (value is null)
        throw new ArgumentNullException(nameof(value));

    char[] characters = value.ToCharArray();
    characters.AsSpan().Reverse();

    return new string(characters);
}
Ten wariant jest interesujący w kodzie o wysokiej wydajności, ale w zwykłej aplikacji różnica względem Array.Reverse będzie zazwyczaj niewielka. Nie komplikowałbym kodu tylko po to, aby użyć nowocześniejszego API.
Którą metodę wybrać w praktyce
Wszystkie przedstawione warianty mają liniową złożoność czasową. Różnią się głównie czytelnością, liczbą pośrednich obiektów i poziomem kontroli nad implementacją.
| Metoda | Najlepsze zastosowanie | Ograniczenia |
|---|---|---|
Array.Reverse |
Prosty, czytelny kod | Tworzy tablicę znaków |
LINQ Reverse
|
Krótki kod i istniejące użycie LINQ | Więcej pośrednich alokacji |
Pętla z StringBuilder
|
Pełna kontrola i duże teksty | Więcej kodu |
Span |
Kod wrażliwy na wydajność | Nie rozwiązuje problemów Unicode |
Dla większości aplikacji wybrałbym Array.Reverse. Jest łatwe do sprawdzenia podczas code review i nie ukrywa kosztu operacji. LINQ zostawiłbym tam, gdzie zwięzłość faktycznie poprawia czytelność, a nie tylko skraca liczbę linii.
Jeżeli metoda jest wywoływana miliony razy albo działa na bardzo dużych danych, dopiero wtedy warto zmierzyć różnice benchmarkiem. Intuicja dotycząca wydajności często zawodzi, zwłaszcza gdy koszt samego odwracania tekstu jest mały w porównaniu z odczytem danych lub komunikacją sieciową.
Odwracanie znaków Unicode wymaga ostrożności
Największa pułapka polega na tym, że char w .NET nie zawsze reprezentuje cały znak widoczny dla użytkownika. Jest to pojedyncza jednostka kodowania UTF-16, a niekoniecznie pełny punkt kodowy Unicode.
Przykładowo emoji takie jak 😀 zajmuje dwie jednostki char. Odwrócenie tekstu znak po znaku może więc rozdzielić parę zastępczą i uszkodzić wynik. Podobny problem dotyczy znaków złożonych z litery oraz znaku diakrytycznego.
string value = "A😀B";
string reversed = ReverseString(value);
W prostych danych ASCII nie ma to znaczenia. Jeśli jednak aplikacja pracuje z tekstem użytkownika, nazwami międzynarodowymi lub emoji, odwracanie po char może być logicznie niepoprawne, nawet gdy kod działa bez wyjątku.
Przeczytaj również: var w C# bez tajemnic - kiedy używać, a kiedy nie?
Odwracanie elementów tekstu
Bezpieczniejszym podejściem jest odwracanie tak zwanych elementów tekstu. Jeden element może zawierać kilka jednostek UTF-16, które użytkownik odbiera jako pojedynczy znak.
using System.Globalization;
using System.Text;

static string ReverseTextElements(string value)
{
    if (value is null)
        throw new ArgumentNullException(nameof(value));

    int[] indexes = StringInfo.ParseCombiningCharacters(value);
    var result = new StringBuilder(value.Length);

    for (int i = indexes.Length - 1; i >= 0; i--)
    {
        int start = indexes[i];
        int length = i == indexes.Length - 1
            ? value.Length - start
            : indexes[i + 1] - start;

        result.Append(value, start, length);
    }

    return result.ToString();
}
Ta wersja zachowuje razem wiele par zastępczych i sekwencji znaków diakrytycznych. Przy rozbudowanych emoji, na przykład z modyfikatorami lub łącznikami ZWJ, zawsze przetestowałbym konkretne przypadki na docelowej wersji .NET, ponieważ wizualnie pojedynczy symbol może składać się z kilku elementów Unicode.
Typowe błędy przy odwracaniu stringa
Pierwszy błąd to próba modyfikowania stringa bezpośrednio. Nie da się zmienić wartości pod konkretnym indeksem, ponieważ string jest niemodyfikowalny. Trzeba utworzyć tablicę, użyć bufora albo zbudować nowy wynik.
Drugi problem to konkatenacja w pętli. Kod jest krótki, ale przy każdym dodaniu znaku może tworzyć nową wartość stringa. Dla kilku znaków nie ma to znaczenia, jednak dla dużych danych lepszy będzie StringBuilder lub tablica znaków.
Trzeci błąd polega na ignorowaniu null. Warto ustalić kontrakt metody z góry. Jeśli brak tekstu oznacza błąd, zgłoś ArgumentNullException. Jeśli aplikacja traktuje null jak pustą wartość, zapisz to jawnie, zamiast pozostawiać przypadkowe zachowanie.
Nie zakładałbym też, że odwrócenie stringa jest tym samym co odwrócenie kolejności słów. Dla tekstu "Ala ma kota" wynik znakowy to "atok am alA", natomiast odwrócenie słów da "kota ma Ala". To dwie różne operacje i wymagają innych algorytmów.
Dobierz algorytm do rodzaju tekstu
Jeśli pracujesz na zwykłych znakach ASCII, zacznij od Array.Reverse albo pętli ze StringBuilder. Są proste, szybkie i łatwe do utrzymania.
Jeżeli najważniejsza jest krótka forma, LINQ będzie wystarczające. Gdy tekst pochodzi od użytkownika i może zawierać emoji, znaki łączone lub alfabet spoza łaciny, odwracaj elementy tekstu, a nie pojedyncze jednostki char.
W praktyce najwięcej problemów nie wynika z samej pętli, lecz z błędnego założenia, co właściwie oznacza „znak”. Dobrze zdefiniowany przypadek użycia jest ważniejszy niż wybór między trzema niemal równie szybkimi metodami.