Masz osobne kolekcje klientów, zamówień i płatności, ale potrzebujesz jednego spójnego wyniku? Właśnie do takich zadań służy łączenie danych w C# za pomocą LINQ. Pokażę, jak działają operacje Join, GroupJoin i lewy join, kiedy użyć składni zapytaniowej lub metodycznej oraz na jakie pułapki uważać w aplikacjach z EF Core.
Najważniejsze zasady łączenia kolekcji w LINQ
-
Joinzwraca tylko elementy, które mają dopasowany klucz po obu stronach. -
GroupJointworzy grupy powiązanych elementów i zachowuje rekordy z lewej kolekcji bez dopasowania. - Lewy join pozwala pokazać wszystkich klientów, również tych bez zamówień.
- Klucze muszą mieć zgodne typy, a przy kluczach złożonych także zgodne nazwy właściwości.
- W przypadku EF Core znaczenie ma to, czy zapytanie pozostaje typu
IQueryablei może zostać przetłumaczone na SQL.
Jak myśleć o join w LINQ
Operacja join kojarzy elementy z dwóch źródeł na podstawie wspólnej wartości. Najczęściej jest nią identyfikator, na przykład CustomerId w zamówieniu i Id klienta. Dla mnie najważniejsze jest to, aby przed napisaniem zapytania jasno określić, które źródło jest lewe, który klucz łączy dane i czy brak dopasowania ma usuwać rekord.
Standardowy Join wykonuje tak zwany inner join. Oznacza to, że w wyniku znajdą się tylko pary elementów, dla których klucze są równe. Jeśli klient nie ma zamówienia, zwykły join go pominie.
var wynik =
    from customer in customers
    join order in orders
        on customer.Id equals order.CustomerId
    select new
    {
        CustomerName = customer.Name,
        OrderId = order.Id,
        order.Total
    };
W składni zapytaniowej słowo equals rozdziela klucz z lewej i prawej kolekcji. W składni metodycznej te same informacje przekazuję jako dwa selektory klucza, a na końcu definiuję kształt wyniku.
var wynik = customers.Join(
    orders,
    customer => customer.Id,
    order => order.CustomerId,
    (customer, order) => new
    {
        CustomerName = customer.Name,
        OrderId = order.Id,
        order.Total
    });
Obie wersje robią zasadniczo to samo. Ja zwykle wybieram składnię zapytaniową przy kilku joinach, bo przypomina SQL i łatwiej odczytać relacje. Składnia metodyczna lepiej pasuje do krótkich potoków LINQ, zwłaszcza gdy wynik buduję razem z Where, Select i OrderBy.
Inner join na przykładzie klientów i zamówień
Załóżmy, że mamy dwie kolekcje. Klient posiada własne Id, a zamówienie przechowuje identyfikator klienta. To typowy przypadek łączenia danych po relacji, która nie musi być odwzorowana bezpośrednią właściwością na obiekcie.
var customers = new[]
{
    new { Id = 1, Name = "Agnieszka Nowak" },
    new { Id = 2, Name = "Marek Wiśniewski" },
    new { Id = 3, Name = "Joanna Kowalska" }
};

var orders = new[]
{
    new { Id = 1001, CustomerId = 1, Total = 349.00m },
    new { Id = 1002, CustomerId = 1, Total = 89.50m },
    new { Id = 1003, CustomerId = 2, Total = 1299.00m },
    new { Id = 99, CustomerId = 8, Total = 49.99m }
};

var result =
    from customer in customers
    join order in orders
        on customer.Id equals order.CustomerId
    select new
    {
        customer.Name,
        order.Id,
        order.Total
    };
Wynik będzie zawierał trzy rekordy. Agnieszka pojawi się dwa razy, ponieważ ma dwa zamówienia, Marek raz, a Joanna w ogóle nie trafi do wyniku. Zamówienie o numerze 99 również zostanie pominięte, bo klient o identyfikatorze 8 nie istnieje w lewej kolekcji.
| Klient | Liczba dopasowanych zamówień | Wynik inner join |
|---|---|---|
| Agnieszka Nowak | 2 | 2 rekordy |
| Marek Wiśniewski | 1 | 1 rekord |
| Joanna Kowalska | 0 | pominięta |
To powielanie nie jest błędem. Jest naturalnym skutkiem relacji jeden do wielu. Jeśli jedna osoba ma pięć zamówień, po joinie otrzymam pięć wierszy z danymi tej osoby. Problem pojawia się dopiero wtedy, gdy ktoś oczekuje jednego wiersza na klienta, a nie przewidział grupowania lub agregacji.
Jeśli potrzebuję podsumowania zamiast pojedynczych zamówień, mogę połączyć dane i od razu je pogrupować.
var summary =
    from customer in customers
    join order in orders
        on customer.Id equals order.CustomerId
    group order by new { customer.Id, customer.Name } into customerOrders
    select new
    {
        customerOrders.Key.Name,
        OrdersCount = customerOrders.Count(),
        Total = customerOrders.Sum(order => order.Total)
    };
Takie podejście dobrze sprawdza się przy raportach. Najpierw łączę źródła, a dopiero potem liczę sumę lub liczbę elementów. Dzięki temu nie muszę ręcznie wyszukiwać zamówień dla każdego klienta.
GroupJoin i lewy join, gdy brak danych ma znaczenie
Zwykły join odpowiada na pytanie „które elementy mają dopasowanie?”. GroupJoin odpowiada na inne pytanie: „jakie elementy z drugiej kolekcji należą do każdego elementu z pierwszej?”. To ważna różnica, bo każdy element lewej kolekcji pozostaje w wyniku, nawet gdy jego grupa jest pusta.
var grouped =
    from customer in customers
    join order in orders
        on customer.Id equals order.CustomerId
        into customerOrders
    select new
    {
        customer.Name,
        Orders = customerOrders
    };

foreach (var item in grouped)
{
    Console.WriteLine($"{item.Name}: {item.Orders.Count()} zamówień");
}
Dla Joanny właściwość Orders będzie pustą sekwencją, a nie wartością null. To bardzo wygodny model do budowania widoków, raportów i obiektów DTO, w których chcemy pokazać także rekordy bez danych podrzędnych.
Lewy join otrzymuję wtedy, gdy grupę spłaszczę przez DefaultIfEmpty. Brak zamówienia reprezentuje wtedy wartość domyślna, zazwyczaj null.
var leftJoin =
    from customer in customers
    join order in orders
        on customer.Id equals order.CustomerId
        into customerOrders
    from order in customerOrders.DefaultIfEmpty()
    select new
    {
        CustomerName = customer.Name,
        OrderId = order == null ? (int?)null : order.Id,
        Total = order == null ? 0m : order.Total
    };
W tym wyniku Joanna również się pojawi, ale bez numeru zamówienia i z kwotą równą zero. W praktyce lepiej często użyć wartości nullable niż sztucznego zera, ponieważ brak zamówienia i zamówienie o wartości 0 mogą oznaczać coś innego.
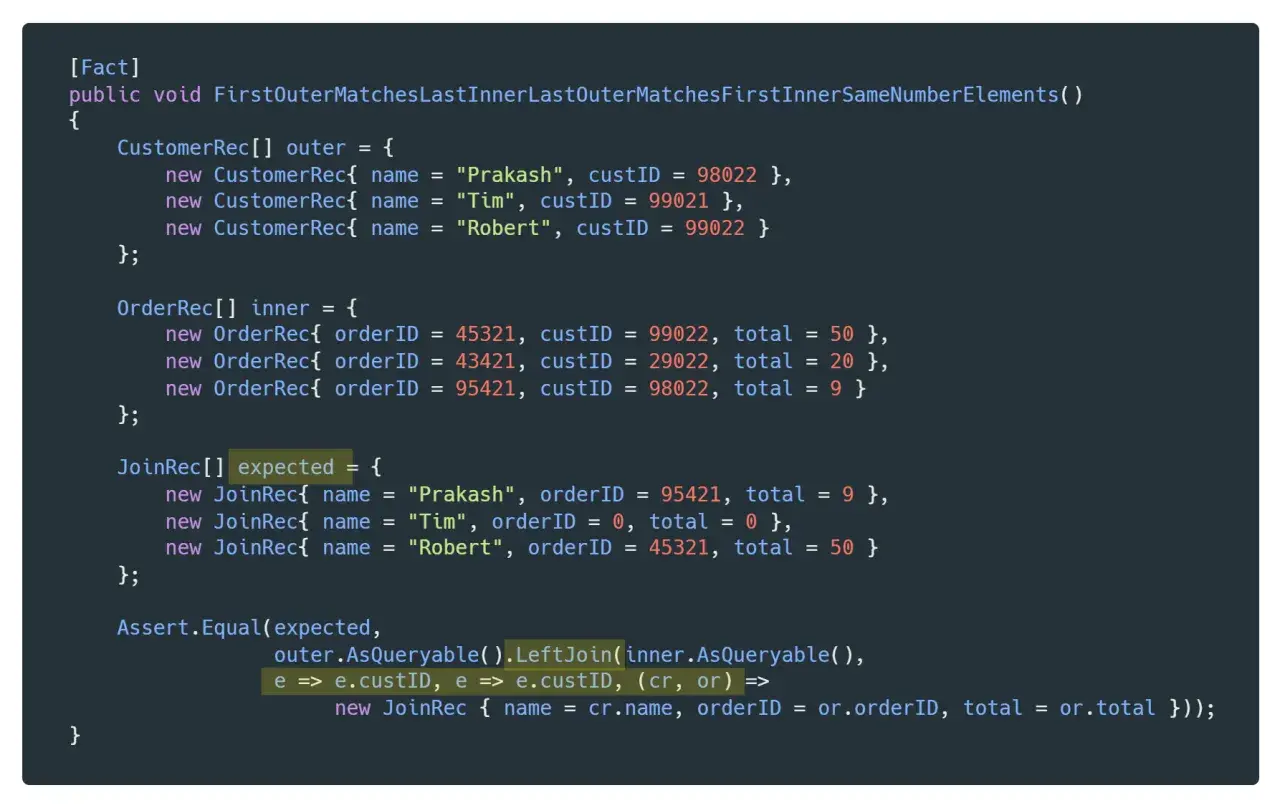
W aktualnym .NET dostępne są także metody LeftJoin i RightJoin. Lewy join można wtedy zapisać krócej.
var leftJoin = customers.LeftJoin(
    orders,
    customer => customer.Id,
    order => order.CustomerId,
    (customer, order) => new
    {
        CustomerName = customer.Name,
        OrderId = order?.Id,
        Total = order?.Total
    });
Jeśli projekt korzysta ze starszej wersji platformy albo operator nie jest dostępny dla używanego dostawcy zapytań, wzorzec z GroupJoin i DefaultIfEmpty nadal jest najbardziej uniwersalnym rozwiązaniem.
Składnia metodyczna, klucze złożone i kilka źródeł
Metodyczny zapis Join
W składni metodycznej najpierw wskazuję kolekcję źródłową, potem kolekcję dołączaną, selektor klucza z każdej strony i funkcję tworzącą wynik. Warto nazywać parametry tak, aby od razu było wiadomo, z którego źródła pochodzą.
var result = customers.Join(
    orders,
    customer => customer.Id,
    order => order.CustomerId,
    (customer, order) => new
    {
        Customer = customer.Name,
        Order = order.Id,
        Value = order.Total
    })
    .Where(item => item.Value > 100m)
    .OrderByDescending(item => item.Value);
Filtr po joinie ogranicza już gotowe pary. Gdy pracuję z bazą danych, często próbuję filtrować wcześniej, aby dostawca musiał przetworzyć mniej rekordów. Nie zawsze zmieni to wygenerowany SQL, ale czytelność i plan zapytania zwykle na tym zyskują.
Łączenie po kilku właściwościach
Gdy jedna właściwość nie wystarcza do jednoznacznego dopasowania, tworzę klucz anonimowy. Wszystkie jego właściwości muszą mieć zgodne typy oraz zgodne nazwy po obu stronach.
var result = invoices.Join(
    payments,
    invoice => new
    {
        invoice.CountryCode,
        Reference = invoice.Number
    },
    payment => new
    {
        payment.CountryCode,
        Reference = payment.InvoiceNumber
    },
    (invoice, payment) => new
    {
        invoice.Number,
        payment.Amount
    });
Najczęstszy błąd w tym miejscu to porównywanie wartości, które wyglądają podobnie, ale mają różne typy, na przykład int i long albo int i int?. Zanim zmienię typ przez rzutowanie, sprawdzam, czy różnica nie sygnalizuje problemu w modelu danych.
Trzy kolekcje w jednym zapytaniu
Join można łączyć w łańcuch. Przykładowo zamówienie może być powiązane z klientem i płatnością.
var result =
    from customer in customers
    join order in orders
        on customer.Id equals order.CustomerId
    join payment in payments
        on order.Id equals payment.OrderId
    select new
    {
        Customer = customer.Name,
        OrderId = order.Id,
        PaymentStatus = payment.Status
    };
W tym przykładzie brak płatności usuwa zamówienie, bo drugi join również jest wewnętrzny. Jeśli płatność jest opcjonalna, trzeba zastosować lewy join dla tego konkretnego etapu. Typ joinu może być inny na każdej relacji, nie muszę wybierać jednej strategii dla całego zapytania.
Przeczytaj również: Ile miejsca zajmuje int w C#? 4 bajty, zakres i wybór typu
Warunki inne niż równość
Operator Join jest przeznaczony do dopasowania kluczy przez równość. Nie użyję go bezpośrednio do warunku „cena mieści się w przedziale” albo „data jest późniejsza”. W takich przypadkach stosuję SelectMany z Where, ale trzeba uważać na rozmiar danych.
var result = products
    .SelectMany(
        product => discountRules,
        (product, rule) => new { product, rule })
    .Where(item =>
        item.product.Price >= item.rule.MinPrice &&
        item.product.Price <= item.rule.MaxPrice)
    .Select(item => new
    {
        item.product.Name,
        Discount = item.rule.Percent
    });
Na małych kolekcjach taki kod jest czytelny. Przy dużych tabelach może jednak przypominać iloczyn kartezjański, czyli sprawdzanie bardzo wielu kombinacji. W aplikacji bazodanowej lepiej upewnić się, czy dostawca potrafi przełożyć taki warunek na wydajne zapytanie.
LINQ to Objects, EF Core i wydajność
To samo wyrażenie LINQ może działać na dwa sposoby. Dla IEnumerable operacja jest wykonywana w pamięci przez .NET. Dla IQueryable, jak w EF Core, zapytanie jest budowane jako drzewo wyrażeń i może zostać przetłumaczone na SQL.
Różnica jest praktyczna. Przy bazie danych nie wywołuję ToList() zbyt wcześnie, bo wtedy pobieram dane do pamięci, a kolejne joiny wykonują się już lokalnie. Staram się filtrować, łączyć i wybierać potrzebne kolumny, zanim nastąpi materializacja.
var result = await dbContext.Customers
    .Where(customer => customer.IsActive)
    .Join(
        dbContext.Orders,
        customer => customer.Id,
        order => order.CustomerId,
        (customer, order) => new
        {
            customer.Name,
            order.Total
        })
    .Where(item => item.Total > 100m)
    .ToListAsync();
W tym przypadku baza ma szansę wykonać filtr i join po swojej stronie. Ostateczna wydajność zależy od dostawcy, indeksów i planu zapytania, ale niepotrzebne ToList() przed joinem jest jednym z najczęstszych powodów niepotrzebnego zużycia pamięci.
Trzeba też pamiętać, że nie każda konstrukcja LINQ ma identyczne wsparcie w każdym providerze. Enumerable może wykonać kod C# bez problemu, podczas gdy EF Core może nie przetłumaczyć konkretnej metody na SQL albo zrobi to w sposób mniej korzystny. Przy ważnych zapytaniach sprawdzam wygenerowany SQL i plan wykonania.
Same klucze również mają znaczenie. W bazie dobrze zindeksowane kolumny używane do joinów potrafią zrobić większą różnicę niż kosmetyczna zmiana składni LINQ. Przy kolekcjach w pamięci zwracam uwagę przede wszystkim na liczbę elementów, powielanie wyników i to, która kolekcja jest wielokrotnie przeszukiwana.
Błędy, które najczęściej psują wynik
| Problem | Skutek | Lepsze podejście |
|---|---|---|
Zwykły Join użyty dla opcjonalnej relacji |
Brakujące rekordy znikają | Użyj GroupJoin z DefaultIfEmpty albo LeftJoin
|
| Łączenie po niewłaściwym kluczu | Brak wyników lub błędne pary | Sprawdź znaczenie obu identyfikatorów, nie tylko ich nazwę |
| Nieoczekiwane duplikaty | Wynik ma więcej wierszy niż źródło | Sprawdź relację jeden do wielu i ewentualnie użyj grupowania |
Filtr po DefaultIfEmpty
|
Lewy join zaczyna działać jak inner join | Uwzględnij przypadek null w warunku |
Wczesne ToList()
|
Dużo danych trafia do pamięci | Materializuj dopiero po zakończeniu zapytania |
Na szczególną uwagę zasługuje filtr po lewym joinie. Taki kod może usunąć rekordy bez dopasowania:
var result =
    from customer in customers
    join order in orders
        on customer.Id equals order.CustomerId
        into customerOrders
    from order in customerOrders.DefaultIfEmpty()
    where order.Total > 100m
    select new { customer.Name, order.Total };
Jeśli order jest równe null, odwołanie do order.Total może zakończyć się wyjątkiem albo zostać przetłumaczone w sposób, który wykluczy brakujące rekordy. Bezpieczniejsza wersja jawnie obsługuje brak zamówienia.
where order == null || order.Total > 100mDrugi częsty problem to porównywanie tekstowych kluczy. W pamięci wielkość liter może mieć znaczenie zależnie od użytego porównania, a w bazie decyduje o tym między innymi sortowanie kolumny. Dla identyfikatorów lepiej używać typów liczbowych lub jednoznacznych kluczy niż przypadkowo porównywanych nazw.
Nie zakładam też, że Distinct() naprawi każdy duplikat. Jeśli wynik jest powielony dlatego, że jedna płatność ma kilka wpisów albo klient ma wiele zamówień, trzeba najpierw zdecydować, jeden rekord czego właściwie chcę otrzymać. Dopiero potem wybieram grupowanie, agregację lub usunięcie duplikatów.
Jak dobrać join do kształtu wyniku
- Wybierz
Join, gdy interesują Cię wyłącznie elementy mające dopasowanie. - Wybierz
GroupJoin, gdy każdy element lewej kolekcji ma otrzymać własną grupę elementów powiązanych. - Wybierz lewy join, gdy rekord z lewej strony ma pozostać widoczny mimo braku danych po prawej stronie.
- Użyj klucza złożonego, gdy dopasowanie zależy od więcej niż jednej właściwości.
- Przy EF Core sprawdź, czy zapytanie pozostaje
IQueryablei czy provider tłumaczy je na oczekiwany SQL.
Najlepszy join nie jest tym, który ma najkrótszy zapis, ale tym, który jasno opisuje oczekiwany wynik. Gdy najpierw określę, co ma stać się z rekordami bez dopasowania i jak ma wyglądać pojedynczy wiersz, wybór między Join, GroupJoin i lewym joinem staje się prosty.