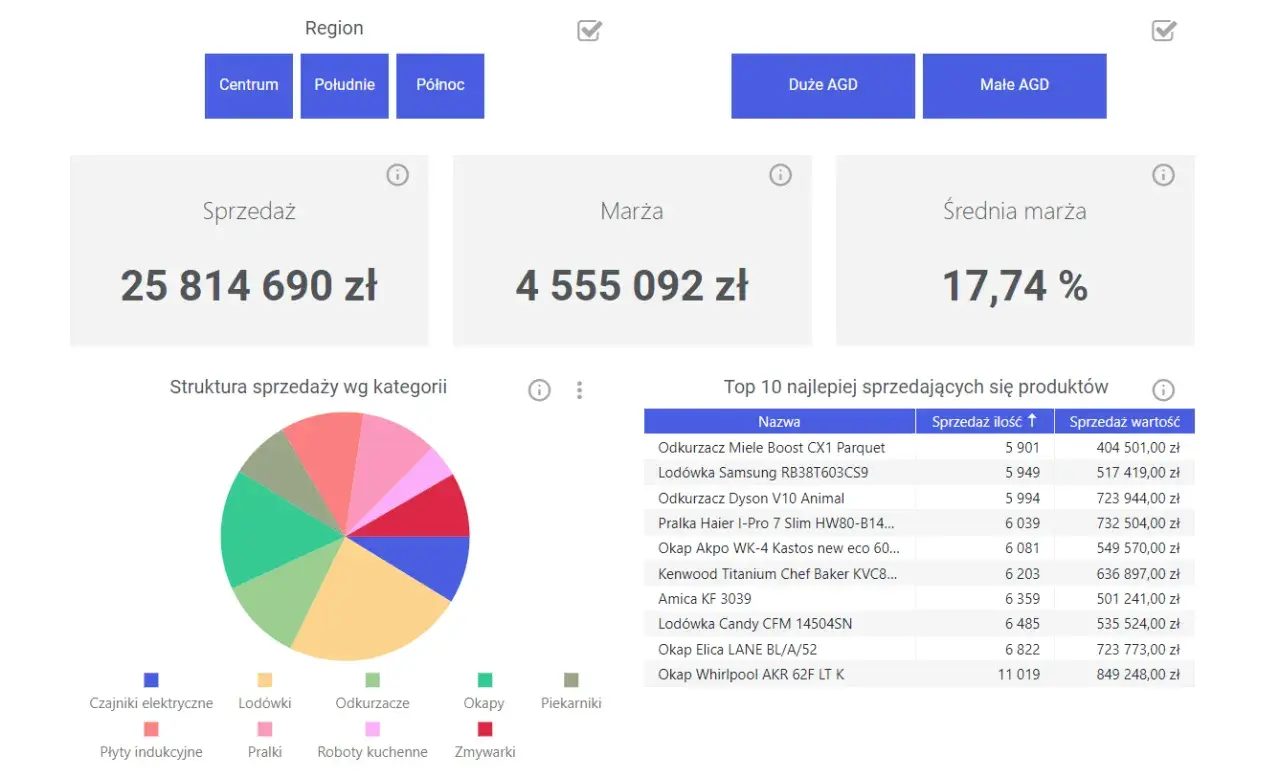
Raport sprzedaży powinien odpowiadać nie tylko na pytanie, ile rekordów znajduje się w tabeli, ale też jak wyniki rozkładają się według klienta, miesiąca czy kategorii. Klauzula GROUP BY pozwala zamienić dużą listę w czytelne zestawienie, a przy okazji współpracuje z funkcjami takimi jak COUNT(), SUM() i AVG(). Pokażę, jak działa, gdzie ją umieszczać, czym różni się od WHERE i HAVING oraz jak unikać typowych błędów w SQL.
Grupowanie porządkuje dane i zamienia je w użyteczne zestawienia
- GROUP BY tworzy grupy wierszy według jednej lub kilku kolumn.
- Funkcje agregujące obliczają wynik dla każdej grupy, na przykład sumę lub średnią.
- Każda kolumna w SELECT musi być pogrupowana albo objęta agregacją.
- WHERE filtruje wiersze przed grupowaniem, a HAVING całe grupy po agregacji.
- Brak klauzuli grupowania przy agregacji oznacza zwykle jedną grupę obejmującą całą tabelę.
Co naprawdę robi GROUP BY w zapytaniu SQL
Najprościej mówiąc, klauzula grupowania łączy wiersze mające taką samą wartość w wybranej kolumnie. Jeżeli tabela zawiera zamówienia z kolumnami CustomerId, Category i Amount, możemy utworzyć osobne grupy dla klientów albo kategorii. Wynik nie pokazuje wtedy każdego zamówienia, lecz jeden wiersz dla każdej grupy.
SELECT Category, SUM(Amount) AS TotalAmount
FROM Orders
GROUP BY Category;
Jeśli w tabeli występują trzy kategorie, zapytanie zwróci najwyżej trzy wiersze. Funkcja SUM() obliczy sumę osobno dla każdej z nich. To właśnie odróżnia agregację od zwykłego sortowania, które zmienia kolejność rekordów, ale nie zmniejsza ich liczby.
W praktyce najczęściej używam grupowania do budowania raportów, statystyk i zestawień dla paneli administracyjnych. Trzeba jednak pamiętać, że po utworzeniu grupy SQL nie może bezpośrednio wybrać przypadkowej wartości z jej wnętrza, ponieważ w jednej grupie może znajdować się wiele różnych rekordów.
Najważniejsze funkcje agregujące
| Funkcja | Zastosowanie | Przykład |
|---|---|---|
COUNT() |
Liczy wiersze lub wartości | Liczba zamówień |
SUM() |
Dodaje wartości liczbowe | Łączna sprzedaż |
AVG() |
Oblicza średnią | Średnia cena |
MIN() |
Znajduje najmniejszą wartość | Najtańszy produkt |
MAX() |
Znajduje największą wartość | Najdroższe zamówienie |
Jak pisać poprawne zapytania z agregacją
Podstawowy schemat jest prosty. Najpierw wskazujemy kolumnę lub wyrażenie grupujące, potem funkcję agregującą, źródło danych i na końcu klauzulę określającą podział na grupy.
SELECT kolumna_grupująca, FUNKCJA_AGREGUJĄCA(kolumna)
FROM tabela
GROUP BY kolumna_grupująca;
Można grupować według kilku kolumn. Wtedy grupa powstaje dla każdej unikalnej kombinacji wartości, a nie dla każdej kolumny osobno.
SELECT CustomerId, Category, COUNT(*) AS OrderCount
FROM Orders
GROUP BY CustomerId, Category;
W tym przykładzie klient z kategorią „Elektronika” tworzy inną grupę niż ten sam klient z kategorią „Książki”. Kolejność kolumn ma znaczenie dla czytelności wyniku, ale nie zmienia samego kryterium dopasowania grup.
Dlaczego pojawia się błąd w SELECT
Częsty błąd wygląda tak:
SELECT Category, ProductName, SUM(Amount)
FROM Orders
GROUP BY Category;
ProductName nie jest ani częścią grupowania, ani argumentem funkcji agregującej. SQL nie wie, którą nazwę produktu zwrócić, gdy jedna kategoria zawiera kilkadziesiąt produktów. Poprawne rozwiązanie zależy od celu: można dodać kolumnę do grupowania, użyć MIN(ProductName) albo zmienić zapytanie tak, aby pobierało konkretny rekord inną metodą.
COUNT(*) a COUNT(kolumna)
COUNT(*) liczy wszystkie wiersze w grupie, także te zawierające wartości NULL. Z kolei COUNT(Discount) pomija wiersze, w których kolumna Discount ma wartość NULL. Ta różnica potrafi zmienić raport, dlatego przed wyborem funkcji sprawdzam, czy liczę rekordy, czy tylko uzupełnione wartości.
WHERE i HAVING filtrują dane w innym momencie
Najbardziej praktyczne rozróżnienie jest takie, że WHERE działa przed grupowaniem, a HAVING po obliczeniu agregatów. Dzięki temu możemy najpierw ograniczyć liczbę analizowanych wierszy, a później odrzucić grupy niespełniające warunku.
SELECT Category, SUM(Amount) AS TotalAmount
FROM Orders
WHERE OrderDate >= '2026-01-01'
GROUP BY Category
HAVING SUM(Amount) > 10000
ORDER BY TotalAmount DESC;
To zapytanie analizuje tylko zamówienia z 2026 roku, grupuje je według kategorii i pokazuje te kategorie, których sprzedaż przekroczyła 10 000. Umieszczenie warunku dotyczącego sumy w WHERE byłoby błędem, ponieważ suma nie istnieje jeszcze na etapie filtrowania pojedynczych rekordów.
| Klauzula | Moment działania | Typowy warunek |
|---|---|---|
WHERE |
Przed grupowaniem | Amount > 100 |
GROUP BY |
Tworzy grupy | Category |
HAVING |
Po agregacji | SUM(Amount) > 10000 |
ORDER BY |
Sortuje wynik końcowy | TotalAmount DESC |
Ten podział ma również znaczenie dla wydajności. Jeżeli warunek może trafić do WHERE, zwykle warto umieścić go właśnie tam, ponieważ baza może odrzucić niepotrzebne wiersze przed kosztowną agregacją.
Praktyczne przykłady grupowania w raportach
Sprzedaż według klienta
SELECT CustomerId,
       COUNT(*) AS OrderCount,
       SUM(Amount) AS TotalAmount,
       AVG(Amount) AS AverageOrder
FROM Orders
GROUP BY CustomerId
ORDER BY TotalAmount DESC;
Jedno zapytanie dostarcza trzech informacji: liczbę zamówień, ich łączną wartość i średnią wartość pojedynczego zamówienia. Dla raportu sprzedażowego to zwykle bardziej użyteczne niż pobieranie wszystkich rekordów i liczenie ich dopiero w kodzie aplikacji.
Grupowanie po miesiącu
Grupowanie po pełnej dacie zazwyczaj utworzy osobną grupę dla każdego dnia i godziny. Aby otrzymać raport miesięczny, trzeba użyć funkcji zależnej od silnika bazy danych, na przykład YEAR() i MONTH() w SQL Server lub MySQL.
SELECT YEAR(OrderDate) AS OrderYear,
       MONTH(OrderDate) AS OrderMonth,
       SUM(Amount) AS TotalAmount
FROM Orders
GROUP BY YEAR(OrderDate), MONTH(OrderDate)
ORDER BY OrderYear, OrderMonth;
W PostgreSQL często stosuje się DATE_TRUNC(), które obcina datę do wybranej jednostki czasu. Sam pomysł pozostaje taki sam, ale składnia funkcji daty może różnić się między SQL Server, PostgreSQL i MySQL. To jeden z tych przypadków, w których nie warto bezmyślnie kopiować zapytania między silnikami.
Przeczytaj również: SQL Server Agent od podstaw - joby, harmonogramy i alerty
Grupowanie wartości NULL
Wartości NULL są traktowane jako jedna grupa. Jeśli kilka zamówień nie ma przypisanej kategorii, trafią do wspólnego wyniku z pustą wartością. Dla raportu biznesowego lepiej często zastąpić ją czytelną etykietą za pomocą COALESCE() lub odpowiednika dostępnego w danym systemie.
SELECT COALESCE(Category, 'Bez kategorii') AS CategoryName,
       COUNT(*) AS OrderCount
FROM Orders
GROUP BY COALESCE(Category, 'Bez kategorii');
Powtórzenie wyrażenia w części grupującej bywa wymagane przez konkretny silnik SQL. W bardziej rozbudowanych zapytaniach można też najpierw przygotować dane w podzapytaniu lub CTE, a dopiero potem agregować gotową kolumnę.
Kiedy lepsze będzie okno analityczne
Grupowanie zmniejsza liczbę wierszy w wyniku. Jeżeli chcę pokazać każdy produkt, ale jednocześnie dodać obok sumę sprzedaży dla jego kategorii, zwykła agregacja nie wystarczy, ponieważ zgubi szczegóły produktów. W takim przypadku lepiej użyć funkcji okna, która liczy wynik dla grupy bez składania wielu wierszy w jeden.
SELECT ProductName,
       Category,
       Amount,
       SUM(Amount) OVER (PARTITION BY Category) AS CategoryTotal
FROM Products;
PARTITION BY działa podobnie do podziału na grupy, ale zachowuje wszystkie rekordy. Ja stosuję tę technikę wtedy, gdy raport ma jednocześnie pokazywać szczegół i jego kontekst, na przykład sprzedaż produktu oraz łączną sprzedaż kategorii.
Nie oznacza to, że funkcje okna zawsze są lepsze. Jeśli potrzebuję tylko jednego wiersza na kategorię, klasyczna agregacja jest prostsza, czytelniejsza i zwykle dokładniej odpowiada intencji zapytania.
Jak sprawdzać zapytanie przed użyciem w aplikacji
Najpierw uruchamiam zapytanie na małym, znanym zbiorze danych i ręcznie sprawdzam przynajmniej jedną grupę. Pozwala to szybko wychwycić pomyłki z datą, wartościami NULL albo podwójnym naliczaniem wynikającym z niepoprawnego połączenia tabel.
- Sprawdź, czy kolumny w
SELECTsą pogrupowane albo zagregowane. - Porównaj COUNT(*) z liczbą oczekiwanych rekordów.
- Ustal, czy filtr dotyczy wierszy, czy już utworzonych grup.
- Przetestuj przypadki z
NULLi pustymi wartościami. - Przy dużych tabelach sprawdź plan wykonania i indeksy używane w filtrach oraz grupowaniu.
Indeks nie gwarantuje automatycznie szybkiej agregacji. Efekt zależy od rozmiaru tabeli, selektywności filtrów, kolejności kolumn i konkretnego silnika bazy. Największą różnicę często robi wcześniejsze ograniczenie danych przez WHERE, a nie samo dodanie kolejnego indeksu.
Od pojedynczej sumy do wiarygodnego raportu
Najważniejsza zasada jest prosta: klauzula grupowania odpowiada za to, według czego dzielisz dane, funkcja agregująca mówi, co liczysz, a HAVING pozwala odsiać gotowe grupy. Gdy zapamiętasz tę kolejność, większość raportów sprzedażowych, statystyk użytkowników i zestawień w aplikacjach .NET zaczyna wyglądać jak składanie kilku jasnych klocków.
Przed optymalizacją zapytania sprawdź najpierw jego znaczenie biznesowe. Raport, który wykonuje się szybko, ale błędnie traktuje daty, wartości NULL albo duplikaty połączeń, nadal pozostaje złym raportem.