Raport ma pokazać sprzedaż każdego klienta, miejsce produktu w rankingu albo zmianę wyniku względem poprzedniego miesiąca, ale nie chcesz tracić szczegółowych wierszy. Właśnie tutaj przydają się funkcje okna w PostgreSQL, opisywane także jako postgres window function. Pokażę składnię, najważniejsze funkcje, praktyczne zapytania, pułapki związane z ramą okna oraz sposób filtrowania wyników.
Funkcje okna pozwalają analizować wiersze bez ich grupowania
- OVER uruchamia funkcję w trybie okna i określa, które wiersze mają być analizowane.
- PARTITION BY dzieli dane na niezależne grupy, a ORDER BY ustala kolejność obliczeń.
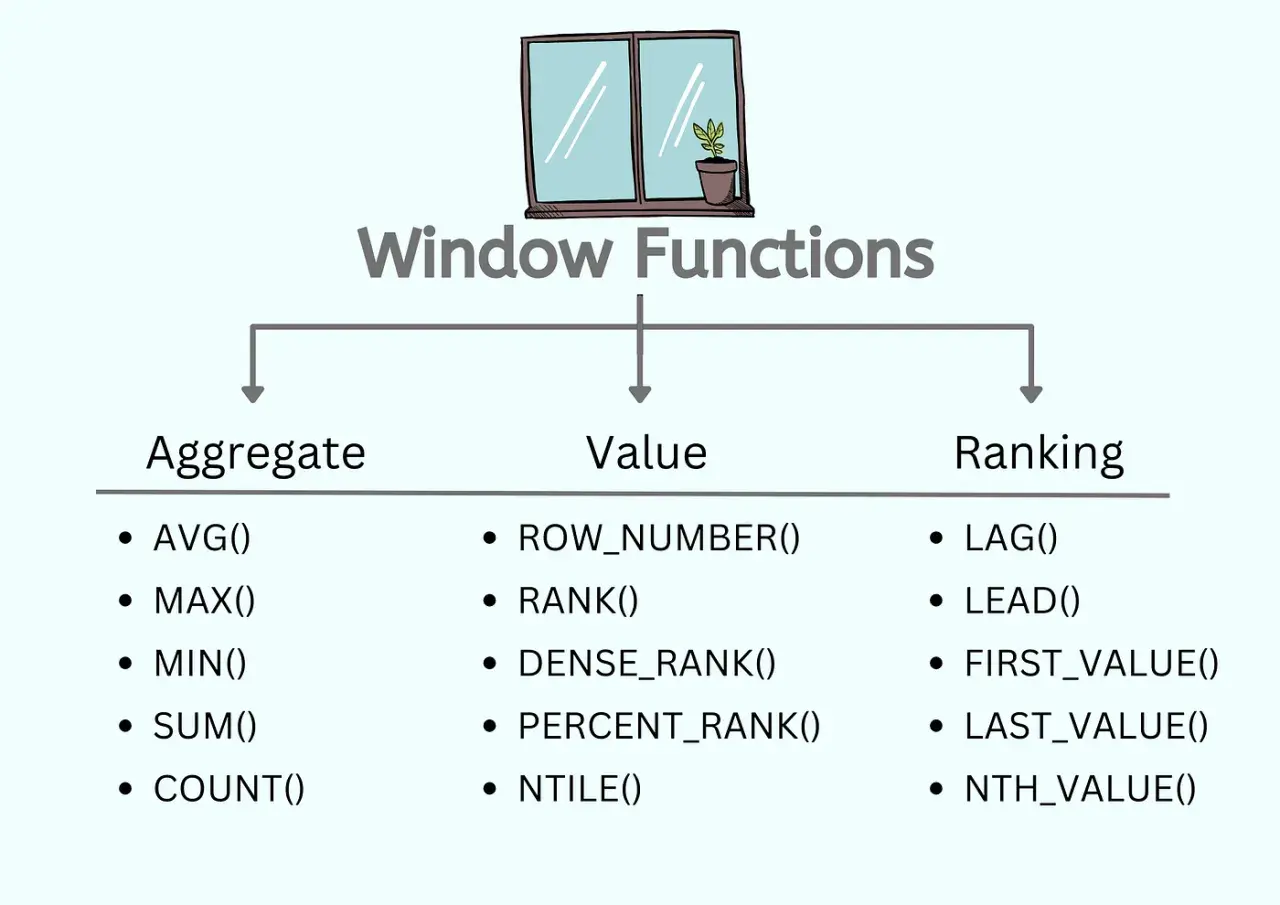
- row_number(), rank() i dense_rank() rozwiązują różne problemy z rankingami i remisami.
- lag() i lead() pozwalają porównywać bieżący wiersz z poprzednim lub następnym.
- Do filtrowania wyniku funkcji okna potrzebujesz podzapytania albo CTE, ponieważ nie można użyć jej bezpośrednio w WHERE.
Na czym polega działanie funkcji okna
Zwykłe GROUP BY zamienia wiele wierszy w jeden wiersz dla każdej grupy. Funkcja okna działa inaczej: wykonuje obliczenie na powiązanym zbiorze rekordów, ale zachowuje każdy wiersz wyniku. Dzięki temu możesz pokazać sprzedaż konkretnego zamówienia i jednocześnie średnią sprzedaż jego klienta.
Najprostszy przykład wygląda tak:
SELECT
    customer_id,
    order_id,
    amount,
    AVG(amount) OVER (PARTITION BY customer_id) AS customer_average
FROM orders;
Dla każdego zamówienia PostgreSQL obliczy średnią z zamówień tego samego klienta. Kolumna amount nadal opisuje pojedyncze zamówienie, a customer_average daje mu szerszy kontekst. To jedna z tych konstrukcji SQL, które początkowo wyglądają jak magia, ale po zrozumieniu zasady szybko stają się codziennym narzędziem.
Trzy elementy klauzuli OVER
Klauzula OVER może zawierać trzy elementy. Nie zawsze potrzebujesz wszystkich, ale każdy odpowiada za inną część analizy.
| Element | Znaczenie | Przykład |
|---|---|---|
PARTITION BY |
Dzieli dane na niezależne grupy | PARTITION BY customer_id |
ORDER BY |
Ustala kolejność w obrębie grupy | ORDER BY sold_at |
| Rama okna | Określa zakres wierszy używany przez obliczenie | ROWS BETWEEN 6 PRECEDING AND CURRENT ROW |
Bez PARTITION BY cała tabela jest traktowana jako jedna grupa. Bez ORDER BY funkcja nadal może policzyć na przykład średnią dla grupy, ale nie ma sensownej kolejności dla numerowania, wartości poprzedniej czy sumy narastającej.
Składnia, od której najlepiej zacząć
Ogólny wzór jest prosty:
funkcja(argument) OVER (
    PARTITION BY kolumna_grupująca
    ORDER BY kolumna_sortująca
);
Przykładowo, numer zamówienia klienta w kolejności od najnowszego może wyglądać tak:
SELECT
    customer_id,
    order_id,
    sold_at,
    ROW_NUMBER() OVER (
        PARTITION BY customer_id
        ORDER BY sold_at DESC, order_id DESC
    ) AS order_number
FROM orders;
Drugie sortowanie po order_id nie jest ozdobnikiem. Gdy dwie daty są identyczne, dodatkowa kolumna zapewnia deterministyczny wynik. Bez niej PostgreSQL może ustawić remisujące wiersze w kolejności, na której nie powinieneś opierać logiki aplikacji.
ORDER BY w oknie a ORDER BY całego zapytania
To częste źródło nieporozumień. ORDER BY wewnątrz OVER steruje obliczeniem funkcji, natomiast końcowe ORDER BY steruje kolejnością zwróconych rekordów.
SELECT
    product_id,
    sold_at,
    amount,
    SUM(amount) OVER (
        PARTITION BY product_id
        ORDER BY sold_at
    ) AS running_total
FROM sales
ORDER BY sold_at DESC;
W tym przykładzie suma narastająca jest liczona chronologicznie, ale wynik może zostać pokazany od najnowszej daty. Te dwa porządki są niezależne i mogą być różne.
Rama okna ma znaczenie
Przy funkcjach takich jak SUM, AVG czy LAST_VALUE sama partycja często nie wystarcza. Rama okna mówi, czy obliczenie obejmuje wszystkie wcześniejsze rekordy, kilka rekordów obok bieżącego wiersza, czy tylko określony zakres wartości.
SELECT
    sold_at,
    amount,
    SUM(amount) OVER (
        ORDER BY sold_at
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS running_total
FROM sales
ORDER BY sold_at;
ROWS odnosi się do fizycznych wierszy. RANGE działa na wartościach sortowania i może obejmować także rekordy z taką samą wartością ORDER BY. Przy powtarzających się datach albo kwotach różnica bywa widoczna, dlatego do klasycznej sumy narastającej najczęściej wybieram ROWS z jednoznacznym sortowaniem.
Rankingi i wybieranie najlepszych rekordów
PostgreSQL ma kilka funkcji rankingowych, które wyglądają podobnie, ale zachowują się inaczej przy remisach. W praktycznych raportach ta różnica ma duże znaczenie.
| Funkcja | Zachowanie przy remisie | Typowe zastosowanie |
|---|---|---|
row_number() |
Każdy wiersz dostaje inny numer | Wybór dokładnie jednego rekordu lub numerowanie |
rank() |
Remisy mają ten sam numer, a po nich powstaje luka | Ranking sportowy lub wynikowy |
dense_rank() |
Remisy mają ten sam numer, ale bez luk | Poziomy, klasy i grupy wyników |
ntile(n) |
Dzieli uporządkowane dane na n grup | Kwartyle, segmentacja klientów |
Załóżmy, że chcesz znaleźć najlepiej zarabiające produkty w każdej kategorii:
SELECT
    category_id,
    product_id,
    revenue,
    RANK() OVER (
        PARTITION BY category_id
        ORDER BY revenue DESC
    ) AS category_rank
FROM product_sales;
RANK() jest dobrym wyborem, gdy dwa produkty z takim samym przychodem powinny zajmować wspólne miejsce. Jeśli potrzebujesz zawsze dokładnie jednego zwycięzcy, użyj ROW_NUMBER() i dodaj stabilny warunek rozstrzygający, na przykład product_id.
Top N w każdej grupie
Nie da się poprawnie napisać takiego warunku bezpośrednio w WHERE, ponieważ funkcje okna są obliczane później niż filtrowanie. Rozwiązaniem jest podzapytanie:
SELECT
    category_id,
    product_id,
    revenue
FROM (
    SELECT
        category_id,
        product_id,
        revenue,
        ROW_NUMBER() OVER (
            PARTITION BY category_id
            ORDER BY revenue DESC, product_id
        ) AS position
    FROM product_sales
) ranked
WHERE position <= 3
ORDER BY category_id, position;
To zapytanie zwraca trzy produkty z każdej kategorii. Jeśli chcesz uwzględnić wszystkie produkty remisujące na trzecim miejscu, zamień ROW_NUMBER() na RANK(). Wynik może wtedy zawierać więcej niż trzy rekordy w jednej kategorii, co jest prawidłowym skutkiem dopuszczenia remisów.
Sumy narastające i porównywanie sąsiednich wierszy
Funkcje okna dobrze sprawdzają się w analizach czasowych. Możesz policzyć sumę narastającą, zmianę względem poprzedniego miesiąca albo średnią z ostatnich siedmiu dni bez wielokrotnego łączenia tabeli z samą sobą.
Suma narastająca
SELECT
    sold_at,
    amount,
    SUM(amount) OVER (
        ORDER BY sold_at, sale_id
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS cumulative_amount
FROM sales
ORDER BY sold_at, sale_id;
Dodanie sale_id do sortowania rozwiązuje problem kilku transakcji z tą samą datą. W praktyce właśnie takie szczegóły odróżniają raport, który można bezpiecznie wykorzystać w aplikacji, od demonstracyjnego przykładu działającego tylko na małej tabeli.
Poprzednia i następna wartość
LAG() pobiera wartość z wcześniejszego wiersza, a LEAD() z późniejszego. Obie funkcje respektują kolejność zdefiniowaną w OVER.
SELECT
    month,
    revenue,
    LAG(revenue) OVER (ORDER BY month) AS previous_revenue,
    revenue - LAG(revenue) OVER (ORDER BY month) AS change
FROM monthly_revenue
ORDER BY month;
Pierwszy wiersz nie ma poprzednika, więc LAG() zwróci NULL. Możesz podać wartość domyślną, ale zwykle wolę zostawić NULL i obsłużyć brak porównania jawnie, zamiast udawać, że zmiana wynosi zero.
Średnia krocząca
SELECT
    measured_at,
    value,
    AVG(value) OVER (
        ORDER BY measured_at
        ROWS BETWEEN 6 PRECEDING AND CURRENT ROW
    ) AS seven_readings_average
FROM measurements
ORDER BY measured_at;
To jest średnia z maksymalnie siedmiu kolejnych pomiarów, a niekoniecznie z siedmiu dni kalendarzowych. Gdy w danych brakuje dni, ROWS liczy rekordy, nie daty. Dla analizy kalendarzowej najpierw trzeba przygotować serię dat i uzupełnić brakujące obserwacje.
Najczęstsze błędy i ograniczenia
Najbardziej zdradliwy błąd polega na użyciu funkcji okna w WHERE, GROUP BY albo HAVING. PostgreSQL nie pozwala na takie wyrażenie, ponieważ funkcja okna działa po tych etapach przetwarzania. Użyj podzapytania lub CTE, a dopiero w zewnętrznym zapytaniu filtruj obliczoną kolumnę.
WITH ranked AS (
    SELECT
        product_id,
        revenue,
        RANK() OVER (ORDER BY revenue DESC) AS position
    FROM product_sales
)
SELECT product_id, revenue
FROM ranked
WHERE position <= 10;
Drugi błąd to pomijanie remisów. ROW_NUMBER() zawsze numeruje wiersze osobno, nawet gdy wartości są identyczne. Jeżeli raport ma znaczenie biznesowe, najpierw ustal, czy remis ma być wspólnym miejscem, czy trzeba wymusić kolejność dodatkową kolumną.
Pułapka z LAST_VALUE
LAST_VALUE() często zwraca wynik inny od oczekiwanego, ponieważ domyślna rama kończy się na bieżącym wierszu. W efekcie funkcja może zwrócić wartość bieżącego rekordu zamiast ostatniej wartości całej partycji.
SELECT
    customer_id,
    sold_at,
    amount,
    LAST_VALUE(amount) OVER (
        PARTITION BY customer_id
        ORDER BY sold_at, sale_id
        ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
    ) AS last_customer_amount
FROM sales;
Jawne określenie ramy sprawia, że PostgreSQL analizuje całą partycję. Przy FIRST_VALUE() problem zwykle nie jest tak widoczny, ale również dobrze rozumieć ramę zamiast polegać na domyślnym zachowaniu.
Przeczytaj również: Pętla do-while w C# - składnia, przykłady i pułapki
Wydajność dużych zapytań
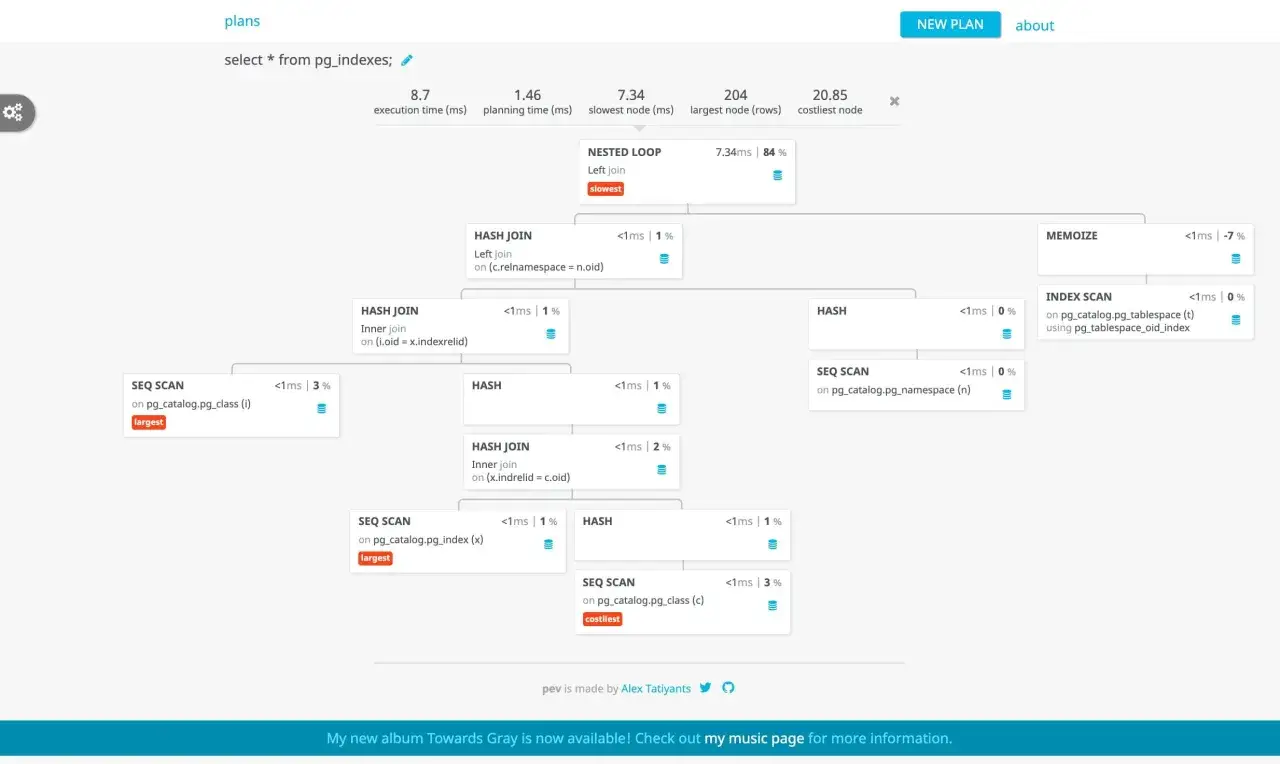
Funkcje okna często wymagają sortowania danych. Przy milionach rekordów może to być kosztowny etap, szczególnie gdy jedno zapytanie używa kilku różnych definicji okna. Sprawdzam wtedy plan przez EXPLAIN (ANALYZE, BUFFERS), ograniczam dane możliwie wcześnie i upewniam się, że sortowanie nie odbywa się na zbędnych kolumnach.
Indeks może pomóc w filtrowaniu i dostarczeniu danych w użytecznej kolejności, ale nie gwarantuje automatycznie taniego wykonania funkcji okna. Koszt zależy od filtrów, liczby partycji, kolejności sortowania, rozmiaru tabeli i ilości pamięci dostępnej dla operacji sortowania.
Jak dobierać funkcję do konkretnego problemu
Najlepiej nie zaczynać od nazwy funkcji, tylko od pytania, które ma odpowiedzieć raport. Gdy potrzebuję numeru rekordu, wybieram ROW_NUMBER(). Gdy analizuję miejsce z uwzględnieniem remisów, wybieram RANK() albo DENSE_RANK(). Do różnic w czasie używam LAG() i LEAD(), a do trendów agregatów z klauzulą OVER.
| Potrzeba | Najlepszy wybór | Na co uważać |
|---|---|---|
| Numerowanie rekordów w grupie | ROW_NUMBER() |
Dodaj jednoznaczne sortowanie |
| Ranking z remisami i lukami | RANK() |
Po remisie kolejne miejsce może być pominięte |
| Ranking bez luk | DENSE_RANK() |
Wszystkie wartości w grupie muszą mieć właściwe znaczenie biznesowe |
| Zmiana względem poprzedniego rekordu | LAG() |
Pierwszy wiersz zwróci NULL
|
| Suma lub średnia narastająca |
SUM() albo AVG() z OVER
|
Zdefiniuj właściwą ramę okna |
| Podział na segmenty | NTILE() |
Grupy nie zawsze będą miały identyczną liczbę wierszy |
Możesz użyć kilku funkcji okna w jednym zapytaniu. Jeśli wszystkie mają tę samą definicję partycji i sortowania, PostgreSQL pozwala nazwać okno w klauzuli WINDOW, co poprawia czytelność:
SELECT
    customer_id,
    amount,
    SUM(amount) OVER customer_window AS total_amount,
    AVG(amount) OVER customer_window AS average_amount
FROM sales
WINDOW customer_window AS (
    PARTITION BY customer_id
);
W kodzie aplikacji, także w projektach .NET korzystających z PostgreSQL, takie zapytania najlepiej trzymać blisko modelu raportowego i testować na danych z remisami, brakującymi datami oraz pustymi wartościami. To właśnie te przypadki najczęściej ujawniają, że pozornie poprawna funkcja okna wymaga doprecyzowania.
Funkcje okna warto projektować razem z logiką raportu
Najważniejsza zasada jest prosta. Najpierw określ grupę, kolejność i regułę remisów, a dopiero potem wybierz funkcję. Większość trudnych błędów nie wynika z samej składni, tylko z niejasnej odpowiedzi na pytanie, które wiersze powinny należeć do analizowanego okna.
Jeżeli wynik ma trafić do produkcyjnego raportu, sprawdź go na małym, ręcznie policzonym zbiorze, a później uruchom EXPLAIN ANALYZE na danych o realnej wielkości. Taka chwila kontroli zwykle oszczędza więcej czasu niż późniejsze poprawianie rankingu, który źle traktuje remisy albo sumy narastającej zależnej od przypadkowej kolejności.