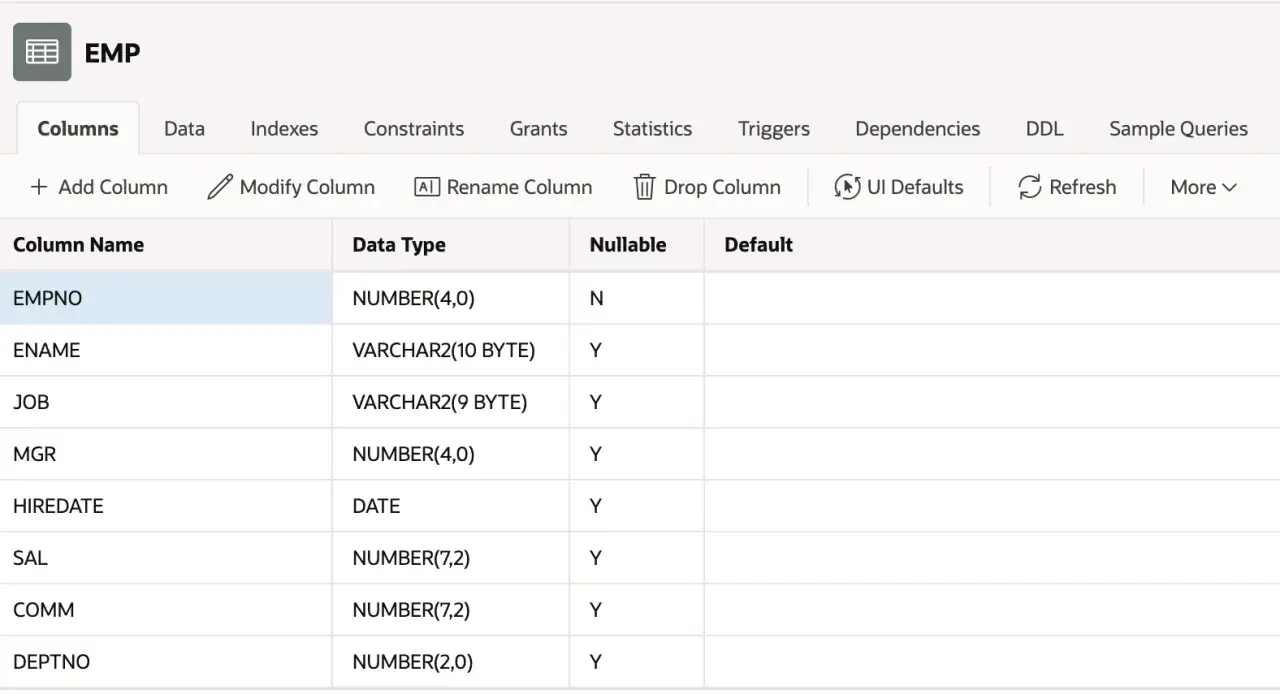
Nowa tabela w Oracle to nie tylko lista kolumn i typów danych. Dobrze napisane polecenie oracle create table powinno od razu uwzględniać klucz główny, ograniczenia integralności, sposób generowania identyfikatorów oraz dalszą pracę aplikacji, na przykład w .NET. Poniżej pokazuję składnię, praktyczne przykłady, wariant tworzenia tabeli na podstawie zapytania i błędy, które najczęściej zatrzymują skrypt.
Najważniejsze decyzje przy tworzeniu tabeli w Oracle
- CREATE TABLE definiuje strukturę tabeli, ale nie zastępuje projektu modelu danych.
- PRIMARY KEY powinien jednoznacznie identyfikować każdy rekord.
- VARCHAR2, NUMBER i TIMESTAMP dobieraj do rzeczywistego rodzaju przechowywanych danych.
- IDENTITY upraszcza generowanie kluczy w nowszych wersjach Oracle.
- CTAS pozwala utworzyć tabelę na podstawie wyniku zapytania, ale zwykle nie przenosi pełnej logiki ograniczeń.
- DDL zatwierdza transakcję, dlatego skrypty wdrożeniowe trzeba uruchamiać świadomie.
Od czego zacząć definicję tabeli w Oracle
Najprostsza składnia wygląda tak:
CREATE TABLE nazwa_tabeli (
    nazwa_kolumny typ_danych [ograniczenia],
    nazwa_kolumny typ_danych [ograniczenia]
);
Każda kolumna musi mieć nazwę i typ danych. Ograniczenia są opcjonalne składniowo, ale w praktyce brak ograniczeń szybko prowadzi do niespójnych danych. Samo polecenie wykonuję w schemacie właściciela tabeli, czyli użytkownika, który ma odpowiednie uprawnienie CREATE TABLE oraz dostępny limit miejsca w tablespace.
Przykład niewielkiej tabeli klientów może wyglądać tak:
CREATE TABLE customers (
    customer_id NUMBER GENERATED BY DEFAULT AS IDENTITY,
    email       VARCHAR2(320) NOT NULL,
    full_name   VARCHAR2(150) NOT NULL,
    created_at  TIMESTAMP WITH TIME ZONE DEFAULT SYSTIMESTAMP NOT NULL,

    CONSTRAINT customers_pk PRIMARY KEY (customer_id),
    CONSTRAINT customers_email_uk UNIQUE (email)
);
W tym przykładzie identyfikator generuje Oracle, adres e-mail musi być unikalny, a data utworzenia otrzymuje wartość domyślną. Takie decyzje są ważniejsze niż samo zapamiętanie składni, bo później wpływają na zapytania, migracje i kod aplikacji.
Jak dobrać kolumny i typy danych
Oracle oferuje wiele typów, ale w typowej aplikacji korzystam z kilku podstawowych. Najczęściej problemem nie jest brak możliwości, tylko użycie typu, który później utrudnia filtrowanie, sortowanie albo integrację z aplikacją.
| Typ | Zastosowanie | Przykład |
|---|---|---|
NUMBER(p,s) |
Liczby całkowite i wartości dziesiętne |
NUMBER(12,2) dla kwoty |
VARCHAR2(n) |
Tekst o zmiennej długości |
VARCHAR2(100) dla nazwy |
DATE |
Data i czas z dokładnością do sekund | published_at DATE |
TIMESTAMP |
Data i czas z większą precyzją | created_at TIMESTAMP |
TIMESTAMP WITH TIME ZONE |
Czas wymagający informacji o strefie | zdarzenia z wielu krajów |
CLOB |
Długi tekst | treść artykułu |
BLOB |
Dane binarne | plik lub obraz |
Dla kwot używam NUMBER z określoną precyzją i skalą, a nie typu zmiennoprzecinkowego. Przykład NUMBER(12,2) pozwala przechować maksymalnie 10 cyfr przed przecinkiem i 2 po przecinku. To rozsądniejszy wybór dla cen, podatków i wartości zamówień.
Do krótkiego tekstu wybieram VARCHAR2. Typ CHAR ma stałą długość i przez to zwykle nie pasuje do nazw, adresów ani identyfikatorów o różnej długości. Z kolei DATE w Oracle przechowuje również czas, choć nie przechowuje ułamków sekund ani informacji o strefie czasowej.
Klucze i ograniczenia, które chronią dane
Tabela może powstać bez ograniczeń, ale wtedy baza nie wie, które rekordy są poprawne. Najważniejsze ograniczenia to PRIMARY KEY, FOREIGN KEY, UNIQUE, NOT NULL i CHECK.
Klucz główny
Klucz główny identyfikuje jeden rekord i nie może zawierać wartości NULL. W prostych tabelach najczęściej stosuję pojedynczą kolumnę liczbową:
CREATE TABLE products (
    product_id NUMBER GENERATED ALWAYS AS IDENTITY,
    product_name VARCHAR2(200) NOT NULL,
    price NUMBER(12,2) NOT NULL,

    CONSTRAINT products_pk PRIMARY KEY (product_id),
    CONSTRAINT products_price_ck CHECK (price >= 0)
);
GENERATED ALWAYS AS IDENTITY oznacza, że identyfikator nadaje Oracle i aplikacja nie powinna przekazywać własnej wartości. Wariant BY DEFAULT jest bardziej elastyczny, bo pozwala podać wartość ręcznie. W systemach produkcyjnych wolę jednak jasno ustalić jedną regułę, zamiast mieszać oba sposoby.
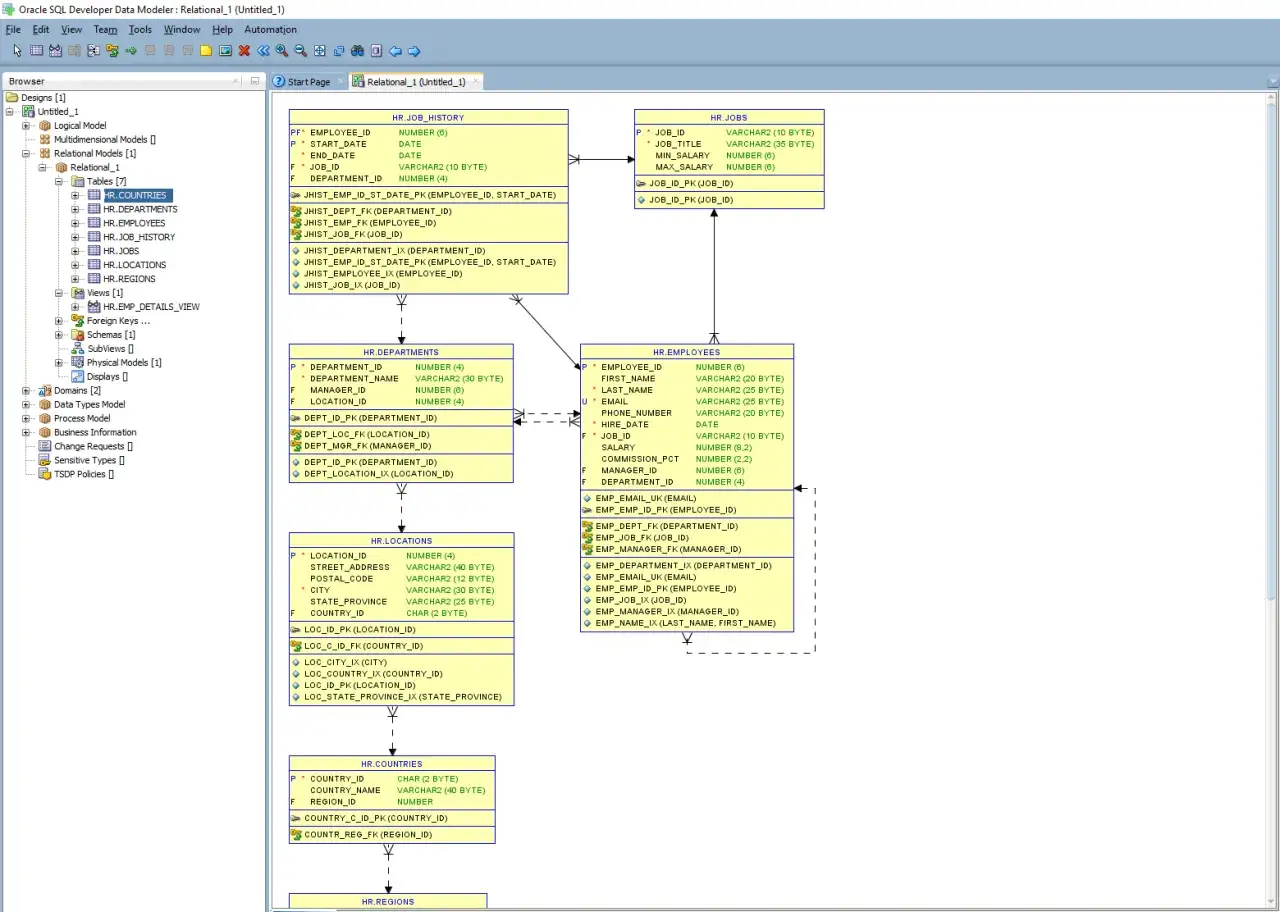
Klucz obcy
Klucz obcy łączy rekord z tabelą nadrzędną. W poniższym przykładzie zamówienie musi wskazywać istniejącego klienta:
CREATE TABLE orders (
    order_id NUMBER GENERATED BY DEFAULT AS IDENTITY,
    customer_id NUMBER NOT NULL,
    order_date DATE DEFAULT SYSDATE NOT NULL,
    status VARCHAR2(20) DEFAULT 'NEW' NOT NULL,

    CONSTRAINT orders_pk PRIMARY KEY (order_id),
    CONSTRAINT orders_customer_fk
        FOREIGN KEY (customer_id)
        REFERENCES customers (customer_id),
    CONSTRAINT orders_status_ck
        CHECK (status IN ('NEW', 'PAID', 'CANCELLED'))
);
Ograniczenie CHECK jest prostym sposobem na zamknięcie listy dopuszczalnych wartości. Nie zastąpi reguł biznesowych w każdej sytuacji, ale skutecznie chroni bazę przed literówkami i przypadkowymi statusami.
Ograniczenia kolumnowe i tabelowe
Ograniczenie można zapisać przy kolumnie albo na końcu definicji tabeli. Forma tabelowa jest wygodniejsza dla kluczy złożonych, czyli takich, które obejmują kilka kolumn:
CREATE TABLE order_items (
    order_id NUMBER NOT NULL,
    product_id NUMBER NOT NULL,
    quantity NUMBER(10) NOT NULL,

    CONSTRAINT order_items_pk PRIMARY KEY (order_id, product_id),
    CONSTRAINT order_items_quantity_ck CHECK (quantity > 0)
);
Własne nazwy ograniczeń, takie jak orders_customer_fk, bardzo ułatwiają diagnozowanie błędów. Domyślne nazwy generowane przez Oracle są trudniejsze do rozpoznania w logach i podczas migracji schematu.
Praktyczne warianty tworzenia tabeli
Najczęściej tworzę tabelę ręcznie, ale Oracle pozwala też zbudować ją na podstawie zapytania. Wybór zależy od tego, czy projektuję nowy model danych, czy przygotowuję kopię, raport albo tabelę roboczą.
Nowa tabela z automatycznym identyfikatorem
Dla nowych aplikacji dobrym punktem wyjścia jest kolumna identity. Dostępne są między innymi warianty ALWAYS, BY DEFAULT oraz BY DEFAULT ON NULL. Różnią się tym, czy aplikacja może przekazać własny identyfikator i co stanie się, gdy przekaże wartość NULL.
CREATE TABLE articles (
    article_id NUMBER GENERATED BY DEFAULT ON NULL AS IDENTITY,
    title VARCHAR2(250) NOT NULL,
    content CLOB,
    published_at TIMESTAMP WITH TIME ZONE,
    is_published NUMBER(1) DEFAULT 0 NOT NULL,

    CONSTRAINT articles_pk PRIMARY KEY (article_id),
    CONSTRAINT articles_published_ck CHECK (is_published IN (0, 1))
);
Jeżeli pracujesz ze starszą wersją Oracle, możesz spotkać klasyczny układ sekwencja plus trigger. Nadal działa, ale wymaga większej liczby obiektów i dodatkowego kodu. W nowym projekcie identity zwykle upraszcza konfigurację, natomiast przy utrzymywaniu starszego systemu nie ma sensu przebudowywać schematu tylko po to, by usunąć sekwencje.
Przeczytaj również: var w JavaScripcie - zakres, hoisting i pułapki starego kodu
Tabela zbudowana na podstawie zapytania
Do kopiowania danych albo przygotowania tabeli tymczasowej służy konstrukcja CREATE TABLE AS SELECT, często skracana do CTAS:
CREATE TABLE orders_archive AS
SELECT order_id, customer_id, order_date, status
FROM orders
WHERE order_date < ADD_MONTHS(SYSDATE, -12);
CTAS jest szybkie i wygodne, ale nie traktuję go jako pełnego zamiennika projektu tabeli. Taka operacja nie przenosi automatycznie kluczy głównych, kluczy obcych ani indeksów. Po utworzeniu tabeli trzeba sprawdzić typy kolumn i dodać potrzebne ograniczenia ręcznie.
Jeżeli potrzebujesz tylko struktury bez danych, użyj warunku zawsze fałszywego:
CREATE TABLE orders_empty AS
SELECT order_id, customer_id, order_date, status
FROM orders
WHERE 1 = 0;
Takie rozwiązanie przydaje się przy stagingu, czyli tabeli pośredniej dla importu. Nie umieszczałbym jednak w nim logiki domenowej, jeśli tabela ma później stać się częścią głównego modelu aplikacji.
Jak sprawdzić, czy tabela została utworzona poprawnie
Po wykonaniu polecenia nie kończę pracy na komunikacie o sukcesie. W SQL Developerze można podejrzeć obiekt w panelu tabel, ale przy skryptach wdrożeniowych szybciej korzystam z widoków słownika danych.
SELECT table_name
FROM user_tables
WHERE table_name = 'CUSTOMERS';

SELECT column_name, data_type, data_length, nullable
FROM user_tab_columns
WHERE table_name = 'CUSTOMERS'
ORDER BY column_id;

SELECT constraint_name, constraint_type, status
FROM user_constraints
WHERE table_name = 'CUSTOMERS';
Nazwy obiektów zapisane bez cudzysłowów Oracle przechowuje standardowo wielkimi literami, dlatego w filtrach używam wartości 'CUSTOMERS'. Cudzysłowy przy nazwach, na przykład "CustomerName", wprowadzają rozróżnianie wielkości liter i zwykle komplikują późniejsze zapytania. Unikam nazw cytowanych, chyba że integracja wymusza taki schemat.
Przy relacjach warto sprawdzić także kolumny ograniczeń:
SELECT constraint_name, column_name, position
FROM user_cons_columns
WHERE table_name = 'ORDERS'
ORDER BY constraint_name, position;
To drobna kontrola, ale potrafi szybko wykazać, że klucz obcy wskazuje inną kolumnę niż zakładaliśmy albo że klucz złożony ma nieprawidłową kolejność pól.
Błędy, które pojawiają się najczęściej
Najbardziej typowy problem to próba utworzenia obiektu o nazwie, która już istnieje. Oracle zwraca wtedy błąd ORA-00955. Zamiast bezrefleksyjnie usuwać tabelę, najpierw sprawdzam, czy obiekt nie zawiera danych albo czy nie jest używany przez aplikację.
Błąd ORA-01031 zwykle oznacza brak uprawnień. Użytkownik może mieć prawo do odczytu innych tabel, ale nie mieć możliwości tworzenia własnych obiektów. Tworzenie tabel w cudzym schemacie wymaga dodatkowych uprawnień i nie powinno być rozwiązaniem domyślnym.
Jeżeli pojawia się ORA-02270 przy kluczu obcym, sprawdź, czy kolumna wskazywana w tabeli nadrzędnej ma klucz główny albo ograniczenie UNIQUE. Klucz obcy nie może odwoływać się do dowolnej kolumny tylko dlatego, że ma ten sam typ danych.
Problemy składniowe, takie jak brak nawiasu lub przecinka, często kończą się błędem ORA-00907. Przy dłuższych definicjach pomaga formatowanie każdej kolumny w osobnej linii i nadawanie nazw wszystkim ograniczeniom.
Co sprawdzić przed użyciem tabeli w produkcji
Przed wdrożeniem patrzę na tabelę z trzech perspektyw. Najpierw sprawdzam, czy model przechowuje wszystkie potrzebne informacje. Później oceniam integralność danych, a na końcu sposób odczytu, czyli indeksy i zapytania używane przez aplikację.
- Model danych powinien rozdzielać niezależne pojęcia zamiast przechowywać wiele wartości w jednym polu tekstowym.
- Ograniczenia powinny blokować duplikaty, brakujące wartości i niepoprawne relacje.
- Indeksy trzeba dobierać do rzeczywistych filtrów i kluczy obcych, a nie tworzyć na każdej kolumnie.
- Skrypt migracyjny powinien być powtarzalny, wersjonowany i możliwy do przejrzenia przed uruchomieniem.
- Uprawnienia aplikacji powinny być możliwie wąskie, szczególnie w środowisku produkcyjnym.
Trzeba też pamiętać o zachowaniu DDL. Polecenia takie jak CREATE TABLE powodują w Oracle niejawne zatwierdzenie transakcji. Dlatego nie łączę ich przypadkowo z operacjami biznesowymi, które powinny zostać wycofane jednym ROLLBACK.
W aplikacjach .NET definicję tabeli zwykle dostarczam przez migrację albo kontrolowany skrypt bazy, a nie przez przypadkowe wykonanie SQL podczas startu aplikacji. Dzięki temu zmiana schematu ma właściciela, historię i jasny sposób wycofania.
Dobra tabela Oracle zaczyna się przed pierwszym INSERT-em
Najważniejsza lekcja jest prosta. Polecenie tworzące tabelę powinno od razu opisywać strukturę, relacje i reguły danych, a nie tylko rezerwować miejsce na kolumny. Dobrane typy, nazwane ograniczenia, sensowny klucz główny i sprawdzenie słownika danych oszczędzają później dużo czasu przy debugowaniu.
Jeżeli tabela ma służyć jako element aplikacji, zacznij od małego, czytelnego modelu i dodawaj kolejne reguły dopiero wtedy, gdy wynikają z rzeczywistych wymagań. W Oracle prosty skrypt jest dobry tylko wtedy, gdy nadal chroni dane, kiedy system zaczyna działać pod obciążeniem.