Masz tabelę produktów, klientów albo zamówień i chcesz zmienić jej dane na podstawie informacji przechowywanych gdzie indziej? Technika określana jako update with join pozwala zrobić to jednym zapytaniem, ale składnia zależy od używanego silnika SQL. Pokażę praktyczne przykłady dla SQL Server, PostgreSQL i MySQL, a także sposoby sprawdzania zakresu zmian, ochrony przed duplikatami i bezpiecznego uruchamiania aktualizacji.
Najważniejsza zasada to połączyć dane, ale aktualizować tylko tabelę docelową
- UPDATE z JOIN zmienia kolumny jednej tabeli na podstawie danych z drugiej.
- Składnia różni się między SQL Server, PostgreSQL i MySQL.
- Przed wykonaniem zapytania sprawdź wynik za pomocą SELECT.
- Relacja źródłowa powinna zwracać najwyżej jeden wiersz dla każdego aktualizowanego rekordu.
- Transakcja i kopia danych ograniczają skutki pomyłki.
Co naprawdę robi UPDATE z JOIN
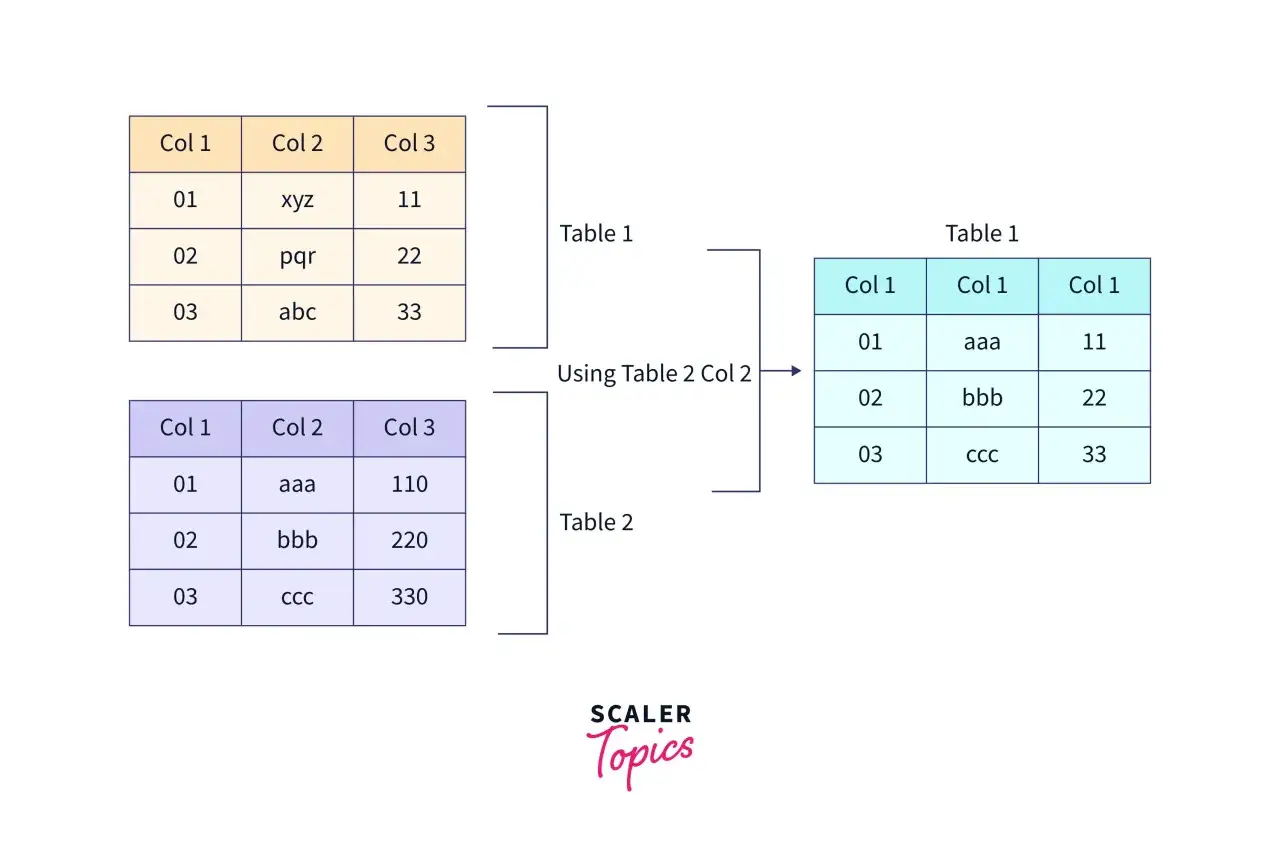
Standardowe UPDATE ustawia wartość kolumny na podstawie stałej, wyrażenia albo danych z aktualizowanego wiersza. JOIN dodaje do tego możliwość sięgnięcia do drugiej tabeli, na przykład cennika, kategorii, profilu klienta lub tabeli importowej.
Załóżmy, że tabela Products zawiera ceny, a Categories przechowuje mnożnik cenowy. Chcemy zmienić ceny tylko tych produktów, których kategoria jest aktywna. Logika wygląda tak:
UPDATE Products
SET Price = Price * Categories.PriceMultiplier
FROM Products
JOIN Categories ON Categories.Id = Products.CategoryId
WHERE Categories.IsActive = 1;
Zapytanie najpierw znajduje pasujące rekordy przez warunek Products.CategoryId = Categories.Id, a później ustawia nową wartość ceny. Sama obecność JOIN nie oznacza jeszcze, że zmienione zostaną wszystkie wiersze. O zakresie decydują warunki połączenia oraz filtr WHERE.
JOIN służy do znalezienia danych, SET do ich zmiany
To rozdzielenie dobrze porządkuje myślenie o zapytaniu. W części JOIN określam, skąd pobieram wartość, w SET wskazuję, co zmieniam, a w WHERE ograniczam zakres operacji.
UPDATE TargetTable
SET TargetColumn = SourceTable.SourceColumn
FROM TargetTable
JOIN SourceTable
  ON SourceTable.KeyColumn = TargetTable.KeyColumn
WHERE SourceTable.IsValid = 1;
Najczęstszy błąd polega na pomyleniu kolumny używanej do połączenia z kolumną przeznaczoną do aktualizacji. Klucz, taki jak CustomerId, zwykle tylko wskazuje powiązany rekord. Zmieniana jest na przykład kolumna DiscountPercent albo Status.
Składnia zależy od używanego silnika SQL
Nie istnieje jedna, w pełni przenośna składnia aktualizacji z JOIN. SQL Server korzysta z FROM, PostgreSQL również używa FROM, ale zapisuje zapytanie inaczej, a MySQL umieszcza JOIN bezpośrednio między nazwą tabeli a instrukcją SET.
| Silnik | Charakterystyczna składnia | Na co uważać |
|---|---|---|
| SQL Server | UPDATE alias SET ... FROM ... JOIN ... |
Alias tabeli docelowej podaje się po UPDATE. |
| PostgreSQL | UPDATE tabela SET ... FROM inna_tabela WHERE ... |
Warunek połączenia trafia do WHERE, nie do osobnego JOIN. |
| MySQL | UPDATE tabela JOIN ... SET ... WHERE ... |
To składnia wielotabelowego UPDATE, specyficzna dla MySQL. |
| Oracle | Podzapytanie skorelowane albo MERGE
|
Przykład z SQL Server nie zadziała bez zmian. |
SQL Server
UPDATE p
SET Price = p.Price * c.PriceMultiplier
FROM dbo.Products AS p
JOIN dbo.Categories AS c
  ON c.Id = p.CategoryId
WHERE c.IsActive = 1;
W SQL Server tabela docelowa jest wskazana przez alias po słowie UPDATE. W części SET nie trzeba poprzedzać nazwy zmienianej kolumny aliasem. Ten zapis jest czytelny i dobrze pasuje do zapytań wykonywanych w aplikacjach .NET oraz w skryptach migracyjnych.
PostgreSQL
UPDATE products AS p
SET price = p.price * c.price_multiplier
FROM categories AS c
WHERE c.id = p.category_id
  AND c.is_active = true;
PostgreSQL traktuje tabele wymienione po FROM jako źródło danych dla aktualizacji. Warunek łączenia znajduje się w WHERE, dlatego jego pominięcie może doprowadzić do zmiany znacznie większej liczby wierszy, niż zakładaliśmy.
MySQL
UPDATE products AS p
JOIN categories AS c
  ON c.id = p.category_id
SET p.price = p.price * c.price_multiplier
WHERE c.is_active = 1;
MySQL zapisuje JOIN najbardziej podobnie do zwykłego zapytania SELECT. Jeżeli aktualizujesz więcej niż jedną tabelę, składnia pozwala również zmieniać kolumny po obu stronach połączenia, ale w codziennej pracy lepiej ograniczyć operację do jednej tabeli docelowej, jeśli nie ma wyraźnej potrzeby robienia inaczej.
Praktyczne scenariusze aktualizacji zależnej od innej tabeli
Kopiowanie danych z tabeli importowej
Częsty przypadek to synchronizacja danych zaimportowanych z pliku lub zewnętrznego systemu. Tabela ProductImport zawiera nowe ceny, a Products jest tabelą używaną przez aplikację.
UPDATE p
SET Price = i.NewPrice,
    UpdatedAt = CURRENT_TIMESTAMP
FROM Products AS p
JOIN ProductImport AS i
  ON i.ExternalCode = p.ExternalCode
WHERE i.NewPrice IS NOT NULL;
Filtr i.NewPrice IS NOT NULL chroni przed nadpisaniem istniejącej ceny pustą wartością. Dodatkowo aktualizuję znacznik czasu, dzięki czemu łatwiej później ustalić, które rekordy zmienił import.
Zmiana statusu na podstawie zamówień
Można też aktualizować klienta na podstawie informacji o jego zamówieniach. Przykładowo klient, który ma co najmniej jedno opłacone zamówienie, może otrzymać status aktywnego użytkownika.
UPDATE c
SET Status = 'active'
FROM Customers AS c
JOIN Orders AS o
  ON o.CustomerId = c.Id
WHERE o.PaymentStatus = 'paid';
Ten przykład jest bezpieczny, jeśli wielokrotne dopasowanie klienta do kilku zamówień nie zmienia wyniku. W praktyce kilka rekordów źródłowych może jednak powodować problemy, gdy wartość ustawiana zależy od konkretnego wiersza. Wtedy lepiej najpierw zagregować dane, na przykład przez GROUP BY, i dopiero dołączyć wynik.
Aktualizacja wielu kolumn naraz
Jednym zapytaniem można zmienić kilka kolumn, co jest przydatne podczas synchronizacji rekordów.
UPDATE p
SET Name = i.Name,
    Price = i.Price,
    StockQuantity = i.StockQuantity,
    UpdatedAt = CURRENT_TIMESTAMP
FROM Products AS p
JOIN ProductImport AS i
  ON i.ExternalCode = p.ExternalCode
WHERE i.IsReady = 1;
Aktualizuję tylko kolumny wymienione w SET. Pozostałe pozostają bez zmian. To ważne szczególnie w dużych tabelach, gdzie niepotrzebne modyfikowanie danych może uruchamiać triggery, zwiększać liczbę blokad i generować dodatkowy zapis w dzienniku transakcji.
Jeżeli pracujesz w PostgreSQL, możesz po zmianie od razu zobaczyć zmodyfikowane rekordy za pomocą RETURNING:
UPDATE products AS p
SET price = i.new_price
FROM product_import AS i
WHERE i.external_code = p.external_code
  AND i.is_ready = true
RETURNING p.id, p.price;
Jak uniknąć błędnej aktualizacji
Największe ryzyko nie wynika zwykle ze składni, lecz z nieprecyzyjnego zakresu. Jedno pominięte kryterium może zmienić miliony rekordów, dlatego ja zawsze zaczynam od zapytania SELECT z identycznymi warunkami.
SELECT p.Id,
       p.Price AS OldPrice,
       p.Price * c.PriceMultiplier AS NewPrice
FROM Products AS p
JOIN Categories AS c
  ON c.Id = p.CategoryId
WHERE c.IsActive = 1;
Dopiero gdy wynik wygląda poprawnie, zamieniam SELECT na UPDATE. Sprawdzam przede wszystkim liczbę rekordów, wartości graniczne oraz przypadki, w których dane źródłowe są niekompletne.
Uważaj na duplikaty po stronie źródłowej
Jeśli dla jednego produktu istnieją dwa rekordy w tabeli źródłowej, wynik aktualizacji może być niejednoznaczny. Różne silniki mogą wybrać inną wartość, a sam fakt, że zapytanie wykonało się bez błędu, nie oznacza jeszcze poprawnego rezultatu.
Przed aktualizacją sprawdź powtarzające się klucze:
SELECT ExternalCode, COUNT(*) AS NumberOfRows
FROM ProductImport
GROUP BY ExternalCode
HAVING COUNT(*) > 1;
Jeżeli klucz powinien być unikalny, najlepszym rozwiązaniem jest unikalny indeks, a nie poleganie wyłącznie na poprawności danych z aplikacji. Gdy duplikaty są dopuszczalne, trzeba jasno określić, który rekord ma wygrać, na przykład najnowszy według ImportedAt.
LEFT JOIN może wyzerować albo wyczyścić dane
LEFT JOIN zachowuje rekordy tabeli docelowej nawet wtedy, gdy nie ma dopasowania w tabeli źródłowej. To bywa przydatne, ale kolumny źródłowe dla niedopasowanych wierszy przyjmują wartość NULL.
UPDATE p
SET DiscountPercent = c.DiscountPercent
FROM Products AS p
LEFT JOIN Categories AS c
  ON c.Id = p.CategoryId;
Jeżeli produkt nie ma kategorii, rabat może zostać wyczyszczony. Gdy chcesz zmieniać wyłącznie dopasowane rekordy, użyj zwykłego JOIN albo dodaj warunek, który wykluczy wartości NULL.
Przeczytaj również: Instalacja SQL Server bez typowych problemów
Uruchamiaj zmianę w transakcji
Przy większej operacji warto użyć transakcji i sprawdzić liczbę zmienionych wierszy przed zatwierdzeniem. W PostgreSQL i MySQL możesz rozpocząć ją poleceniem BEGIN, a w SQL Server używa się zwykle BEGIN TRANSACTION.
BEGIN;

UPDATE products AS p
SET price = i.new_price
FROM product_import AS i
WHERE i.external_code = p.external_code;

-- sprawdzenie liczby i zakresu zmian
-- COMMIT albo ROLLBACK
Na produkcji nie zostawiaj otwartej transakcji bez kontroli. Duża aktualizacja może blokować inne operacje i rozbudować dziennik transakcji. Przy milionach rekordów rozważ podział pracy na partie, przygotowanie indeksów na kolumnach łączenia oraz wykonanie operacji poza szczytem obciążenia.
Kiedy lepsze będzie podzapytanie albo MERGE
JOIN jest bardzo wygodny, gdy każdemu rekordowi tabeli docelowej odpowiada dokładnie jeden rekord źródłowy. Gdy logika obejmuje jednocześnie dodawanie, aktualizowanie i ewentualne usuwanie danych, prosty UPDATE przestaje być najlepszym narzędziem.
| Rozwiązanie | Kiedy użyć | Główne ograniczenie |
|---|---|---|
| UPDATE z JOIN | Gdy zmieniasz istniejące rekordy na podstawie jednego źródła. | Składnia zależy od silnika, a duplikaty mogą być niebezpieczne. |
| Podzapytanie skorelowane | Gdy potrzebujesz pobrać jedną precyzyjnie wybraną wartość. | Przy dużych danych może być mniej czytelne lub mniej wydajne. |
| MERGE | Gdy chcesz obsłużyć INSERT i UPDATE w jednym przepływie. | Implementacja i zachowanie różnią się między bazami. |
Podzapytanie bywa dobrym wyborem, gdy trzeba jawnie wymusić jedną wartość źródłową:
UPDATE products AS p
SET price = (
    SELECT i.new_price
    FROM product_import AS i
    WHERE i.external_code = p.external_code
)
WHERE EXISTS (
    SELECT 1
    FROM product_import AS i
    WHERE i.external_code = p.external_code
);
Warunek EXISTS zapobiega ustawieniu wartości NULL dla produktów bez dopasowania. Nadal trzeba jednak dopilnować, aby podzapytanie zwracało najwyżej jeden rekord. Jeśli zwróci kilka wierszy, wiele baz zgłosi błąd.
W przypadku synchronizacji danych z tabeli stagingowej można rozważyć MERGE, ale nie traktowałbym go jako automatycznie lepszego zamiennika. Najpierw sprawdzam obsługę konkretnego silnika, zachowanie przy duplikatach oraz sposób obsługi konfliktów. Prosty UPDATE jest często łatwiejszy do przetestowania i bezpieczniejszy w utrzymaniu.
Najbezpieczniejszy schemat pracy z aktualizacją zależną od JOIN
W praktyce skuteczny proces składa się z kilku prostych kontroli. Najpierw identyfikuję tabelę docelową, klucz połączenia i dokładną kolumnę, która ma się zmienić. Później uruchamiam odpowiadający UPDATE zwykły SELECT, aby zobaczyć stare i nowe wartości obok siebie.
- Sprawdź, czy kolumny używane w JOIN mają zgodne typy i odpowiednie indeksy.
- Zweryfikuj, czy źródło zwraca najwyżej jeden rekord dla każdego klucza docelowego.
- Dodaj warunek
WHERE, nawet jeśli obecnie wydaje się zbędny. - Przetestuj operację na kopii danych albo ogranicz ją tymczasowo przez filtr.
- Użyj transakcji i sprawdź liczbę zmienionych wierszy.
- Po aktualizacji uruchom kontrolny
SELECTi sprawdź kilka rekordów ręcznie.
Najważniejsza praktyczna reguła brzmi prosto: najpierw pokaż dane, które zamierzasz zmienić, a dopiero później je aktualizuj. Dzięki temu JOIN pozostaje narzędziem precyzyjnej synchronizacji, a nie ryzykowną operacją wykonywaną na ślepo.