Synchronizacja danych często zaczyna się niewinnie: trzeba zaktualizować istniejące rekordy, dodać nowe, a czasem oznaczyć jako nieaktywne te, których nie ma już w źródle. Pokażę, jak działa mechanizm t-sql merge, kiedy rzeczywiście upraszcza pracę, a kiedy lepiej zastąpić go osobnymi instrukcjami INSERT, UPDATE i DELETE. Znajdziesz tu składnię, praktyczne przykłady, zasady projektowania warunku ON oraz listę pułapek związanych z duplikatami i równoległym dostępem.
Najważniejsze zasady bezpiecznej synchronizacji danych
- MERGE łączy dane źródłowe z docelowymi i może wykonać INSERT, UPDATE lub DELETE.
- Warunek ON powinien opierać się wyłącznie na kluczu dopasowania rekordów.
- Źródło nie może zawierać duplikatów klucza, jeśli rekord docelowy ma być aktualizowany.
- WHEN NOT MATCHED BY SOURCE stosuj tylko wtedy, gdy źródło jest pełnym, wiarygodnym obrazem danych.
- Przy dużej konkurencji osobne instrukcje często są czytelniejsze i mniej blokujące.
Jak działa MERGE w T-SQL w praktyce
Instrukcja MERGE porównuje tabelę źródłową z tabelą docelową, a potem wykonuje odpowiednią operację zależnie od wyniku dopasowania. W jednym poleceniu można obsłużyć nowe, zmienione i nieobecne rekordy. Microsoft Learn opisuje tę instrukcję jako mechanizm synchronizacji tabel na podstawie wyniku połączenia źródła z celem. Dokumentacja MERGE w Microsoft Learn pokazuje również różnice między SQL Server, Azure SQL i Azure Synapse.
Najważniejsze elementy są cztery. USING wskazuje źródło danych, ON definiuje sposób dopasowania, a klauzule WHEN określają reakcję na znalezienie lub brak rekordu. Instrukcję trzeba zakończyć średnikiem, ponieważ jego brak może powodować błąd składni.
MERGE INTO dbo.Products AS target
USING dbo.ProductsStage AS source
    ON target.ProductCode = source.ProductCode
WHEN MATCHED THEN
    UPDATE SET
        target.ProductName = source.ProductName,
        target.Price = source.Price
WHEN NOT MATCHED BY TARGET THEN
    INSERT (ProductCode, ProductName, Price)
    VALUES (source.ProductCode, source.ProductName, source.Price);
Ten przykład realizuje klasyczny scenariusz upsertu. Rekord z istniejącym kodem produktu zostanie zaktualizowany, a nowy produkt trafi do tabeli docelowej. Nie ma tu usuwania, więc brak produktu w tabeli źródłowej nie oznacza automatycznie jego usunięcia.
Co oznaczają poszczególne warianty WHEN
| Klauzula | Działanie | Typowe zastosowanie |
|---|---|---|
WHEN MATCHED |
Aktualizuje albo usuwa pasujący rekord | Synchronizacja zmian |
WHEN NOT MATCHED BY TARGET |
Wstawia rekord obecny tylko w źródle | Upsert nowych danych |
WHEN NOT MATCHED BY SOURCE |
Aktualizuje albo usuwa rekord obecny tylko w celu | Pełne uzgadnianie danych |
W praktyce najczęściej potrzebujesz tylko dwóch pierwszych klauzul. Trzecia jest przydatna, ale też najbardziej ryzykowna, bo wymaga pewności, że źródło zawiera kompletny zestaw rekordów, a nie tylko przyrost zmian.
Przykład synchronizacji ze stagingiem
W aplikacjach .NET i procesach ETL dane zwykle nie trafiają od razu do tabeli produkcyjnej. Najpierw zapisuje się je w tabeli stagingowej, czyli pomocniczym obszarze, w którym można sprawdzić typy, kompletność i duplikaty. Dopiero później uruchamia się synchronizację z tabelą docelową.
Przed wykonaniem MERGE trzeba dopilnować, aby tabela źródłowa zwracała najwyżej jeden rekord dla każdego klucza. Jeśli dwa wiersze źródłowe pasują do tego samego wiersza docelowego, SQL Server nie wie, który z nich powinien wygrać i zwraca błąd.
WITH DeduplicatedSource AS
(
    SELECT
        ProductCode,
        ProductName,
        Price,
        ROW_NUMBER() OVER
        (
            PARTITION BY ProductCode
            ORDER BY ImportedAt DESC
        ) AS RowNumber
    FROM dbo.ProductsStage
)
MERGE INTO dbo.Products AS target
USING
(
    SELECT ProductCode, ProductName, Price
    FROM DeduplicatedSource
    WHERE RowNumber = 1
) AS source
    ON target.ProductCode = source.ProductCode
WHEN MATCHED THEN
    UPDATE SET
        target.ProductName = source.ProductName,
        target.Price = source.Price
WHEN NOT MATCHED BY TARGET THEN
    INSERT (ProductCode, ProductName, Price)
    VALUES (source.ProductCode, source.ProductName, source.Price)
OUTPUT
    $action AS ChangeType,
    inserted.ProductCode,
    inserted.ProductName;
CTE z funkcją ROW_NUMBER wybiera najnowszy rekord dla każdego produktu. To ważny krok, bo samo dodanie DISTINCT często nie rozwiązuje problemu. Dwa rekordy mogą mieć ten sam klucz, ale różne ceny, statusy lub daty importu.
Klauzula OUTPUT zwraca informację o operacji wykonanej dla każdego wiersza. Warto wykorzystać ją do audytu, logowania zmian albo aktualizacji pamięci podręcznej. Zmienna $action przyjmuje wartości INSERT, UPDATE lub DELETE.
Usuwanie i dezaktywowanie rekordów wymaga ostrożności
WHEN NOT MATCHED BY SOURCE oznacza, że rekord istnieje w tabeli docelowej, ale nie ma go w aktualnym źródle. To nie zawsze jest błąd ani sygnał do usunięcia. Wiele importów przesyła wyłącznie zmienione rekordy, więc użycie tej klauzuli w takim procesie skasowałoby dane, które po prostu nie znalazły się w bieżącej paczce.
Bezpieczniejszym rozwiązaniem jest często dezaktywowanie rekordów zamiast fizycznego usuwania. Przykład ma sens wtedy, gdy źródło jest pełnym eksportem produktów:
MERGE INTO dbo.Products AS target
USING dbo.ProductsFullSnapshot AS source
    ON target.ProductCode = source.ProductCode
WHEN MATCHED THEN
    UPDATE SET
        target.ProductName = source.ProductName,
        target.IsActive = 1
WHEN NOT MATCHED BY TARGET THEN
    INSERT (ProductCode, ProductName, IsActive)
    VALUES (source.ProductCode, source.ProductName, 1)
WHEN NOT MATCHED BY SOURCE
     AND target.IsActive = 1 THEN
    UPDATE SET
        target.IsActive = 0;
W tym wariancie produkt nieobecny w pełnym eksporcie zostaje oznaczony jako nieaktywny. Takie podejście zachowuje historię i zwykle lepiej pasuje do systemów biznesowych niż bezpowrotne DELETE. Dokumentacja Microsoft Learn ostrzega, aby operację usuwania po stronie źródła dodawać tylko wtedy, gdy dane wejściowe są autorytatywnym pełnym snapshotem.
Trzeba też pamiętać, że w klauzuli WHEN NOT MATCHED BY SOURCE nie można bezpiecznie korzystać z kolumn źródła, ponieważ dla takiego rekordu źródłowego po prostu nie ma.
Najczęstsze błędy przy użyciu MERGE
Niepełny warunek ON
Warunek ON powinien odpowiadać wyłącznie za ustalenie, czy rekordy reprezentują ten sam obiekt. Nie należy używać go do filtrowania rekordów według statusu, daty lub innych warunków biznesowych. Takie filtry lepiej umieścić w dodatkowym warunku przy WHEN MATCHED.
MERGE INTO dbo.Customers AS target
USING dbo.CustomerStage AS source
    ON target.ExternalId = source.ExternalId
WHEN MATCHED
     AND source.IsDeleted = 0 THEN
    UPDATE SET
        target.Name = source.Name;
Jeżeli status zostanie dopisany do ON, rekord może zostać uznany za nowy, mimo że istnieje w tabeli docelowej. To prowadzi do prób wstawienia duplikatu. Zasada jest prosta: ON identyfikuje rekord, a WHEN decyduje o operacji.
Brak unikalnego indeksu
Kolumna używana do dopasowania powinna mieć odpowiednie zabezpieczenie w bazie. Najczęściej będzie to klucz główny albo unikalny indeks na identyfikatorze z systemu źródłowego. Sam kod procedury nie wystarczy, jeśli równoległy proces może w tym samym czasie wstawić ten sam rekord.
Przeczytaj również: MERGE INTO w SQL - jak bezpiecznie synchronizować dane
Założenie, że MERGE zawsze jest atomowy w sensie biznesowym
Instrukcja jest pojedynczym poleceniem, ale nadal podlega blokadom, izolacji transakcji i konkurencji między sesjami. Przy intensywnym ruchu warto przetestować transakcję, poziom izolacji oraz ewentualne użycie HOLDLOCK. Taki mechanizm może ograniczyć ryzyko wyścigu podczas upsertu, ale zwiększa blokowanie, więc nie powinien być dodawany bez pomiarów.
Jeśli tabela jest często modyfikowana przez wiele procesów, osobne instrukcje mogą dać większą kontrolę nad blokadami. Właśnie dlatego przed wdrożeniem sprawdzam nie tylko poprawność wyniku, ale też plan wykonania, czas trwania blokad i zachowanie przy jednoczesnych importach.
Kiedy lepiej użyć osobnych instrukcji
MERGE dobrze pasuje do kontrolowanych procesów synchronizacji, szczególnie gdy źródło jest tabelą stagingową, dane mają jasny klucz, a liczba reguł pozostaje niewielka. Nie traktuję go jednak jako automatycznie lepszej wersji trzech osobnych poleceń.
| Scenariusz | Rozsądny wybór | Dlaczego |
|---|---|---|
| Prosty upsert jednego rekordu |
UPDATE i potem INSERT
|
Łatwiejsze debugowanie i kontrola wyniku |
| Duży import z tabeli stagingowej | MERGE |
Jedna deklaracja reguł synchronizacji |
| Duża konkurencja na tabeli | Osobne instrukcje | Większa kontrola nad blokadami |
| Pełny snapshot z dezaktywacją brakujących danych |
MERGE z WHEN NOT MATCHED BY SOURCE
|
Obsługa uzgadniania w jednym procesie |
| Wiele wyjątków i reguł biznesowych | Osobne operacje lub procedura etapowa | Lepsza czytelność i prostsze testy |
Microsoft Learn wskazuje, że przy dużej współbieżności rozdzielenie operacji może ograniczyć blokowanie i działać lepiej niż pojedynczy, rozbudowany MERGE. To praktyczna wskazówka, nie zakaz stosowania instrukcji. Ostateczną decyzję powinien poprzedzać pomiar na danych przypominających produkcyjne.
Co sprawdzić przed wdrożeniem synchronizacji
- Unikalność źródła - sprawdź, czy jeden klucz nie występuje w nim więcej niż raz.
-
Indeks dopasowania - zapewnij klucz główny lub unikalny indeks na kolumnach użytych w
ON. - Semantykę źródła - ustal, czy zawiera pełny snapshot, czy tylko przyrost zmian.
- Obsługę NULL - porównania kolumn mogą wymagać jawnego uwzględnienia wartości pustych.
- Transakcję i blokady - przetestuj równoległe uruchomienie dwóch importów.
-
Audyt - użyj
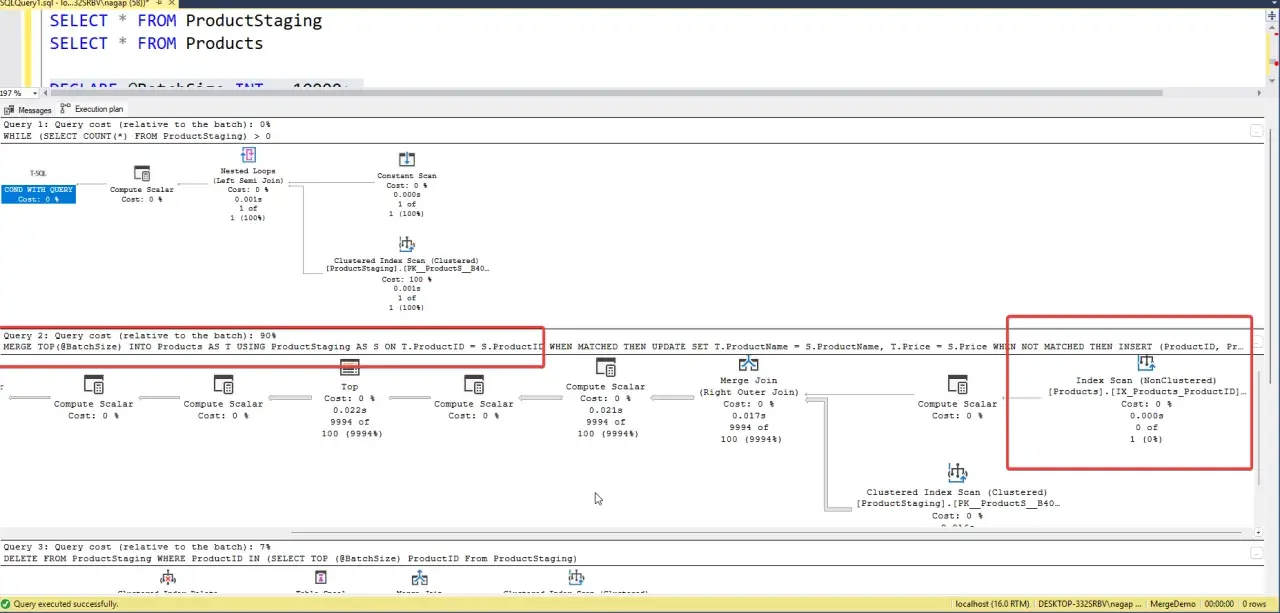
OUTPUT, jeśli musisz wiedzieć, które rekordy zostały zmienione. - Wydajność - sprawdź plan wykonania, liczbę skanowanych wierszy i czas blokowania tabel.
Najlepszy wzorzec jest zwykle prosty. Przygotuj i oczyść źródło, zagwarantuj jeden rekord na klucz, ogranicz ON do właściwego dopasowania, a dopiero potem dodawaj reguły aktualizacji lub dezaktywacji. MERGE jest użytecznym narzędziem do synchronizacji, ale jego bezpieczeństwo wynika przede wszystkim z jakości danych wejściowych, indeksów i świadomie zaprojektowanej obsługi współbieżności.