Gdy aplikacja ma dodać rekord tylko wtedy, gdy nie istnieje on jeszcze w tabeli, łatwo pomylić kilka podobnych konstrukcji SQL. Zapis if not exists sql może oznaczać zarówno warunkowy INSERT, sprawdzenie przez NOT EXISTS, jak i utworzenie tabeli poleceniem CREATE TABLE IF NOT EXISTS. Poniżej pokazuję różnice, przykłady dla popularnych baz oraz pułapki związane z równoległymi operacjami.
Najważniejsze zasady używania sprawdzenia nieistnienia w SQL
-
NOT EXISTSsprawdza, czy podzapytanie nie zwraca żadnego wiersza. -
IF NOT EXISTSsłuży głównie do warunkowego tworzenia lub usuwania obiektów, ale jego dostępność zależy od silnika. - Przy warunkowym dodawaniu danych używaj unikalnego indeksu, ponieważ samo sprawdzenie nie chroni przed wyścigiem transakcji.
-
NOT EXISTSjest bezpieczniejsze niżNOT IN, gdy podzapytanie może zawierać wartościNULL. - W PostgreSQL i MySQL często lepiej skorzystać z natywnego upsertu niż ręcznie łączyć sprawdzanie z wstawianiem.
NOT EXISTS i IF NOT EXISTS rozwiązują różne problemy
Najpierw trzeba rozdzielić dwa podobne zapisy. NOT EXISTS jest predykatem, czyli warunkiem używanym w zapytaniu do sprawdzenia, czy podzapytanie nie zwraca pasujących rekordów. Można wykorzystać go przy SELECT, INSERT, UPDATE oraz DELETE.
IF NOT EXISTS jest konstrukcją zależną od dialektu SQL. Najczęściej spotkasz ją przy tworzeniu tabel, indeksów, schematów lub innych obiektów. Nie jest uniwersalnym zamiennikiem dla NOT EXISTS, dlatego kod działający w PostgreSQL może wymagać zmiany w SQL Server.
SELECT 1
WHERE NOT EXISTS (
    SELECT 1
    FROM dbo.Users
    WHERE Email = @Email
);
W podzapytaniu zwykle zapisuję SELECT 1, ponieważ nie potrzebuję pobierać konkretnych kolumn. Silnik interesuje wyłącznie odpowiedź na pytanie, czy znaleziono przynajmniej jeden pasujący wiersz.
Intencja takiego warunku jest prosta. Jeżeli podzapytanie zwróci rekord, NOT EXISTS będzie fałszywe. Jeżeli nie zwróci niczego, warunek stanie się prawdziwy i zapytanie zewnętrzne będzie mogło wykonać dalszą operację.
Jak dodać rekord tylko wtedy, gdy jeszcze go nie ma
Najbardziej przenośny wzorzec dla warunkowego dodawania danych to INSERT ... SELECT ... WHERE NOT EXISTS. Zamiast osobno wykonywać SELECT, a potem INSERT, łączymy sprawdzenie z operacją zapisu.
INSERT INTO Users (Email, DisplayName)
SELECT @Email, @DisplayName
WHERE NOT EXISTS (
    SELECT 1
    FROM Users
    WHERE Email = @Email
);
Jeżeli użytkownik o podanym adresie nie istnieje, wartości zostaną wstawione. Gdy rekord już jest w tabeli, instrukcja nie doda żadnego wiersza i nie zgłosi błędu. To dobry wybór dla prostych skryptów oraz operacji, w których brak nowego rekordu jest prawidłowym rezultatem.
Dodawanie wielu rekordów bez duplikatów
Ten sam schemat działa przy kopiowaniu danych z jednej tabeli do drugiej. Warunek powinien odnosić się do klucza lub zestawu kolumn, który rzeczywiście definiuje duplikat.
INSERT INTO ProductCategories (ProductId, CategoryId)
SELECT p.ProductId, @CategoryId
FROM Products AS p
WHERE p.ProductId = @ProductId
  AND NOT EXISTS (
      SELECT 1
      FROM ProductCategories AS pc
      WHERE pc.ProductId = p.ProductId
        AND pc.CategoryId = @CategoryId
  );
W tym przykładzie duplikatem nie jest sam produkt ani sama kategoria, lecz konkretna para ProductId i CategoryId. Takie rozróżnienie często decyduje o tym, czy zapytanie zachowuje się poprawnie w rzeczywistym modelu danych.
Dlaczego NOT IN nie zawsze jest dobrym zamiennikiem
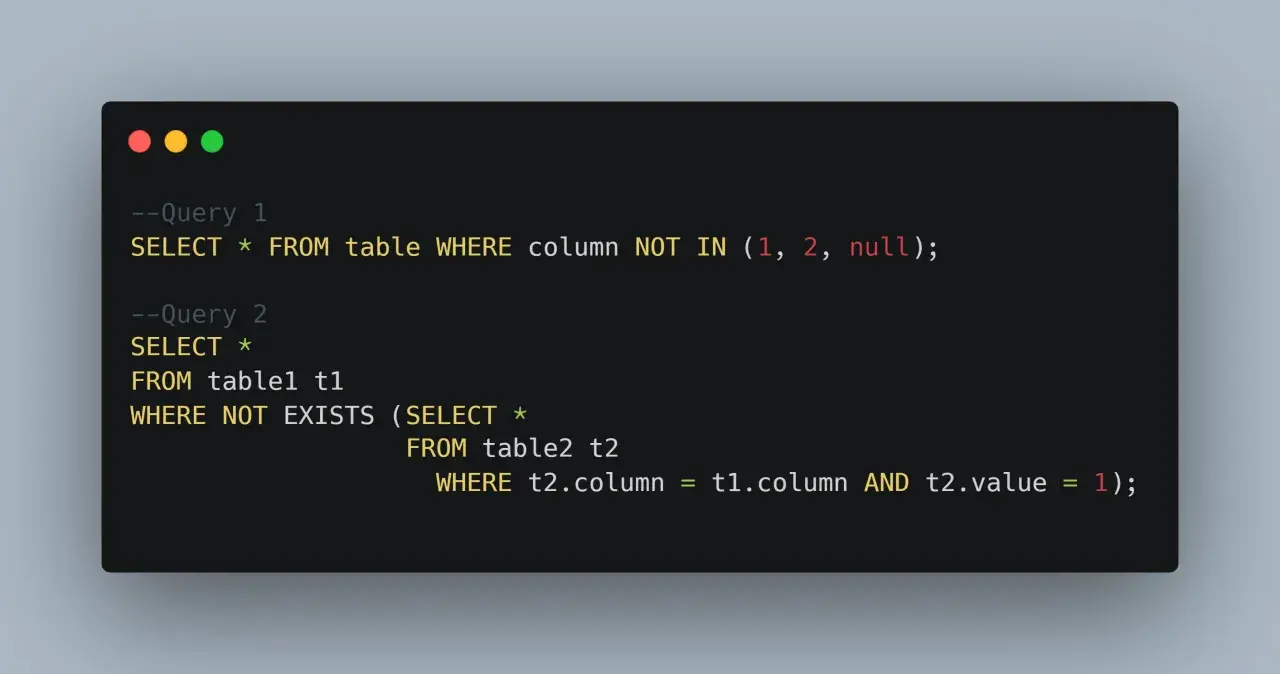
Podobny warunek można czasem zapisać za pomocą NOT IN, ale pojawia się problem z wartościami NULL. SQL stosuje logikę trójwartościową, więc obecność jednego NULL w podzapytaniu może sprawić, że wynik nie będzie taki, jak oczekujesz.
SELECT *
FROM Products AS p
WHERE NOT EXISTS (
    SELECT 1
    FROM ArchivedProducts AS a
    WHERE a.ProductId = p.ProductId
);
W praktyce preferuję NOT EXISTS przy porównywaniu rekordów z podzapytaniem. Zapis jest jednoznaczny, dobrze opisuje intencję i nie ma typowej pułapki NULL znanej z NOT IN.
Jak warunkowo utworzyć tabelę lub inny obiekt
Drugi popularny przypadek dotyczy skryptów inicjalizacyjnych i migracji. Chcesz utworzyć tabelę tylko wtedy, gdy nie ma jej jeszcze w bazie. Tutaj używa się zwykle CREATE TABLE IF NOT EXISTS, ale składnia nie jest jednakowa we wszystkich systemach.
PostgreSQL, MySQL i SQLite
CREATE TABLE IF NOT EXISTS Orders (
    Id INTEGER PRIMARY KEY,
    CustomerId INTEGER NOT NULL,
    CreatedAt TIMESTAMP NOT NULL
);
W tych silnikach taka konstrukcja pozwala ponownie uruchomić skrypt bez błędu wynikającego z istnienia tabeli. Trzeba jednak pamiętać, że nie aktualizuje istniejącej tabeli. Jeżeli tabela już istnieje, ale nie ma nowej kolumny, samo IF NOT EXISTS niczego nie zmieni.
Do modyfikacji istniejącej struktury potrzebujesz osobnego polecenia, na przykład ALTER TABLE, albo narzędzia migracyjnego. W projekcie .NET zwykle lepiej pozwolić, aby wersjonowaniem zmian zajmowały się migracje EF Core, zamiast budować rozbudowany skrypt pełen ręcznych warunków.
SQL Server i Azure SQL
W SQL Server nie używa się standardowo składni CREATE TABLE IF NOT EXISTS. Typowym rozwiązaniem jest sprawdzenie metadanych przez OBJECT_ID, a potem wykonanie instrukcji tworzącej tabelę.
IF OBJECT_ID(N'dbo.Orders', N'U') IS NULL
BEGIN
    CREATE TABLE dbo.Orders
    (
        Id int NOT NULL PRIMARY KEY,
        CustomerId int NOT NULL,
        CreatedAt datetime2 NOT NULL
    );
END;
Ten wariant pasuje również do Azure SQL, ponieważ usługa korzysta z silnika SQL Server. Przy sprawdzaniu obiektów dobrze podawać zarówno schemat, jak i typ obiektu, ponieważ sama nazwa może występować w różnych schematach.
Podobny wzorzec można zastosować przy indeksach, ale tutaj trzeba sprawdzać katalog systemowy, na przykład sys.indexes. Samo istnienie tabeli nie oznacza przecież, że ma ona wymagany indeks.
Różnice między popularnymi silnikami baz danych
Największy błąd polega na założeniu, że SQL jest identyczny w każdej bazie. Logika NOT EXISTS jest szeroko przenośna, ale składnia obsługi konfliktów, tabel i indeksów zależy od konkretnego silnika.
| Silnik | Warunkowe tworzenie tabeli | Typowy sposób unikania duplikatu |
|---|---|---|
| PostgreSQL | CREATE TABLE IF NOT EXISTS |
ON CONFLICT DO NOTHING |
| MySQL | CREATE TABLE IF NOT EXISTS |
INSERT IGNORE lub ON DUPLICATE KEY UPDATE
|
| SQLite | CREATE TABLE IF NOT EXISTS |
INSERT OR IGNORE lub ON CONFLICT
|
| SQL Server | IF OBJECT_ID(...) IS NULL |
NOT EXISTS wraz z unikalnym indeksem |
Przykład dla PostgreSQL może wyglądać tak:
INSERT INTO users (email, display_name)
VALUES (@Email, @DisplayName)
ON CONFLICT (email) DO NOTHING;
To rozwiązanie jest krótsze niż ręczne sprawdzanie i dobrze współpracuje z unikalnym indeksem. W MySQL analogiczny problem można rozwiązać przez INSERT IGNORE, ale trzeba uważać, ponieważ ta konstrukcja może ukrywać także inne ostrzeżenia lub błędy zależne od konfiguracji.
Nie kopiowałbym składni między bazami bez sprawdzenia dokumentacji konkretnego silnika. Najpierw ustalam, czy celem jest pominięcie konfliktu, aktualizacja istniejącego rekordu, czy tylko warunkowe wykonanie skryptu. Dopiero potem wybieram właściwy wariant.
Samo sprawdzenie nie wystarczy przy równoległych operacjach
Instrukcja NOT EXISTS może być logicznie poprawna, a mimo to nie zapobiec duplikatom. Problem pojawia się, gdy dwie transakcje wykonują sprawdzenie niemal w tym samym momencie. Obie mogą zobaczyć brak rekordu, a następnie obie spróbują go dodać.
IF NOT EXISTS (
    SELECT 1
    FROM Users
    WHERE Email = @Email
)
BEGIN
    INSERT INTO Users (Email)
    VALUES (@Email);
END;
W aplikacji obsługującej wielu użytkowników taki kod powinien być wsparty przez unikalny indeks na kolumnie Email. Baza danych staje się wtedy ostatnią i najważniejszą linią ochrony przed duplikatem, niezależnie od liczby uruchomionych instancji aplikacji.
CREATE UNIQUE INDEX UX_Users_Email
ON Users (Email);
W zależności od silnika możesz dodatkowo użyć transakcji, odpowiedniego poziomu izolacji albo blokad. Nie traktowałbym jednak ręcznego blokowania jako pierwszego rozwiązania, ponieważ może pogorszyć współbieżność i zwiększyć ryzyko zakleszczeń.
Przeczytaj również: PARTITION BY w SQL - składnia, przykłady i różnice względem GROUP BY
Co robić w aplikacji .NET
W kodzie aplikacji najbezpieczniejszy schemat zwykle wygląda tak: unikalny indeks, pojedyncza operacja zapisu i obsługa konfliktu. W PostgreSQL będzie to często ON CONFLICT, w SQL Server można wykonać próbę wstawienia i obsłużyć naruszenie klucza unikalnego, a w innych bazach warto wykorzystać ich natywny mechanizm upsertu.
W przypadku Entity Framework Core dobrze skonfigurować indeks w modelu, ale nie zakładać, że sama konfiguracja aplikacji zastąpi ograniczenie w bazie. Schemat bazy jest wspólnym zabezpieczeniem dla wszystkich klientów, także dla zadań w tle, skryptów administracyjnych i procesów uruchamianych w Azure.
Jak wybrać właściwy wariant bez komplikowania zapytania
- Gdy sprawdzasz brak powiązanego rekordu, użyj
NOT EXISTS. - Gdy tworzysz tabelę lub schemat, sprawdź, czy dany silnik obsługuje
IF NOT EXISTS. - Gdy aplikacja działa współbieżnie, dodaj unikalny indeks i nie polegaj wyłącznie na wcześniejszym sprawdzeniu.
- Gdy baza ma natywny upsert, rozważ go przed ręcznym łączeniem
SELECTiINSERT. - Gdy tworzysz migrację, pamiętaj, że warunkowe utworzenie obiektu nie zmienia jego istniejącej definicji.
Najczęściej wybieram NOT EXISTS jako czytelny i przenośny wzorzec dla danych, a składnię specyficzną dla silnika zostawiam tam, gdzie rzeczywiście daje przewagę. Dzięki temu zapytanie jasno komunikuje intencję, a reguły integralności pozostają po stronie bazy, gdzie powinny być egzekwowane.
Najważniejsza decyzja dotyczy nie składni, lecz ochrony danych
Warunkowe wykonanie SQL jest przydatne przy migracjach, importach i synchronizacji danych, ale sama konstrukcja IF NOT EXISTS lub NOT EXISTS nie rozwiązuje wszystkich problemów. Trzeba jeszcze określić, co dokładnie oznacza duplikat, zabezpieczyć tę regułę unikalnym indeksem i dopasować składnię do używanego silnika.
Jeżeli zapytanie ma działać tylko raz w prostym skrypcie, podstawowy wzorzec wystarczy. Gdy operacja trafia do produkcyjnej aplikacji .NET lub Azure, traktuję ograniczenia bazy, współbieżność i obsługę konfliktów jako równie ważne jak sam warunek sprawdzający istnienie rekordu.