Gdy dane klienta przychodzą z API, pliku CSV i systemu ERP, samo INSERT szybko przestaje wystarczać. Właśnie wtedy przydaje się instrukcja MERGE INTO w SQL, która pozwala porównać źródło z tabelą docelową i zdecydować, które rekordy zaktualizować, a które dopiero dodać. Pokażę praktyczną składnię, bezpieczny proces ładowania danych oraz różnice między popularnymi silnikami bazodanowymi.
Jedno polecenie może obsłużyć aktualizację i dodawanie danych
- MERGE porównuje źródło z tabelą docelową na podstawie warunku dopasowania.
- Rekordy istniejące można zaktualizować, a brakujące dodać.
- Najbezpieczniej zasilać tabelę docelową ze stagingu, czyli tymczasowego obszaru na dane wejściowe.
- Źródło musi mieć jednoznaczny klucz, inaczej jeden rekord docelowy może zostać dopasowany wielokrotnie.
- Składnia i zachowanie różnią się między SQL Server, PostgreSQL i Oracle.
Do czego służy MERGE i kiedy naprawdę ma sens
MERGE łączy kilka operacji DML w jednym poleceniu. Dla każdego rekordu ze źródła baza sprawdza warunek ON, a potem wykonuje odpowiednią akcję. Gdy rekord pasuje do tabeli docelowej, działa sekcja WHEN MATCHED. Gdy go nie ma, uruchamiana jest sekcja WHEN NOT MATCHED.
Customers. Dzięki temu nie trzeba osobno pisać logiki „najpierw sprawdź, potem aktualizuj albo dodaj”.
W praktyce używam tego mechanizmu głównie przy ładowaniu paczek danych, integracjach ETL oraz synchronizacji tabel referencyjnych. Nie traktuję go jednak jako uniwersalnego zamiennika dla każdej operacji. Przy pojedynczym zapisie z aplikacji prostsze INSERT albo mechanizm upsert często będzie czytelniejszy.
Jak działa porównanie rekordów
Instrukcja potrzebuje trzech elementów. Pierwszy to tabela docelowa, drugi to źródło danych, a trzeci to warunek, który mówi, kiedy oba rekordy oznaczają ten sam obiekt. Najczęściej jest nim klucz biznesowy albo klucz techniczny, na przykład CustomerId.
MERGE INTO tabela_docelowa AS target
USING tabela_zrodlowa AS source
ON target.Id = source.Id
WHEN MATCHED THEN
    UPDATE SET target.Nazwa = source.Nazwa
WHEN NOT MATCHED THEN
    INSERT (Id, Nazwa)
    VALUES (source.Id, source.Nazwa);
Ten schemat jest prosty, ale krytyczny jest warunek ON. Jeśli dopasowanie oprzesz na nazwie klienta zamiast na stabilnym identyfikatorze, zmiana nazwy może zostać potraktowana jako nowy rekord. Dla mnie to jeden z najczęstszych powodów błędnej synchronizacji, szczególnie gdy źródło pochodzi z arkusza lub pliku CSV.
Jak przygotować MERGE krok po kroku
Najpierw przygotuj tabelę docelową i źródło danych. W rozwiązaniach produkcyjnych preferuję tabelę staging, do której trafia cały import. Można wtedy sprawdzić typy danych, usunąć duplikaty, odrzucić błędne rekordy i dopiero później uruchomić właściwą synchronizację.
Przykład dla SQL Server
Załóżmy, że tabela Customer przechowuje dane klientów, a CustomerImport zawiera ostatnią paczkę pobraną z systemu zewnętrznego. Poniższy przykład aktualizuje istniejące osoby i dodaje nowe.
MERGE INTO dbo.Customer AS target
USING dbo.CustomerImport AS source
    ON target.ExternalId = source.ExternalId
WHEN MATCHED THEN
    UPDATE SET
        target.Name = source.Name,
        target.Email = source.Email,
        target.ModifiedAt = SYSUTCDATETIME()
WHEN NOT MATCHED BY TARGET THEN
    INSERT (ExternalId, Name, Email, ModifiedAt)
    VALUES (
        source.ExternalId,
        source.Name,
        source.Email,
        SYSUTCDATETIME()
    )
OUTPUT
    $action AS ActionName,
    inserted.ExternalId;
Klauzula OUTPUT jest bardzo przydatna, bo pozwala zapisać informację, które rekordy zostały dodane, a które zmienione. Przy większych importach warto przechowywać taki wynik w dzienniku synchronizacji. Dzięki temu łatwiej wyjaśnić, dlaczego konkretny klient zmienił dane.
Usuń duplikaty przed dopasowaniem
Źródło nie może zawierać kilku rekordów z tym samym ExternalId. W przeciwnym razie baza może zgłosić błąd albo nie będzie jasne, która wersja danych powinna trafić do tabeli docelowej. Najlepiej rozstrzygnąć to jeszcze w zapytaniu źródłowym.
USING (
    SELECT ExternalId, Name, Email
    FROM (
        SELECT
            ExternalId,
            Name,
            Email,
            ROW_NUMBER() OVER (
                PARTITION BY ExternalId
                ORDER BY ImportedAt DESC
            ) AS RowNumber
        FROM dbo.CustomerImport
    ) AS prepared
    WHERE RowNumber = 1
) AS source
W tym wariancie zostaje najnowszy rekord dla każdego klienta. ROW_NUMBER numeruje wiersze w obrębie tej samej wartości klucza, a sortowanie po dacie pozwala wybrać aktualną wersję. To drobny fragment SQL, który często robi większą różnicę niż samo polecenie MERGE.
Dodaj transakcję i walidację
Jeśli import obejmuje kilka tabel, synchronizację uruchom w transakcji. Wtedy błąd w jednej części procesu nie zostawi połowy danych zaktualizowanych, a połowy starych. Przed wykonaniem operacji sprawdź też liczbę rekordów, duplikaty oraz wartości kluczy pustych.BEGIN TRANSACTION;
-- walidacja danych źródłowych
-- MERGE tabeli docelowej
-- zapis wyniku synchronizacji
COMMIT TRANSACTION;Ważny jest również tryb obsługi błędów. Sama transakcja nie rozwiązuje problemu, jeśli aplikacja nie wykona ROLLBACK po wyjątku. W kodzie aplikacji, na przykład w .NET, łączę wykonanie polecenia z logowaniem identyfikatora importu i liczbą zmienionych rekordów.
Łączenie danych z pliku, API i innej bazy
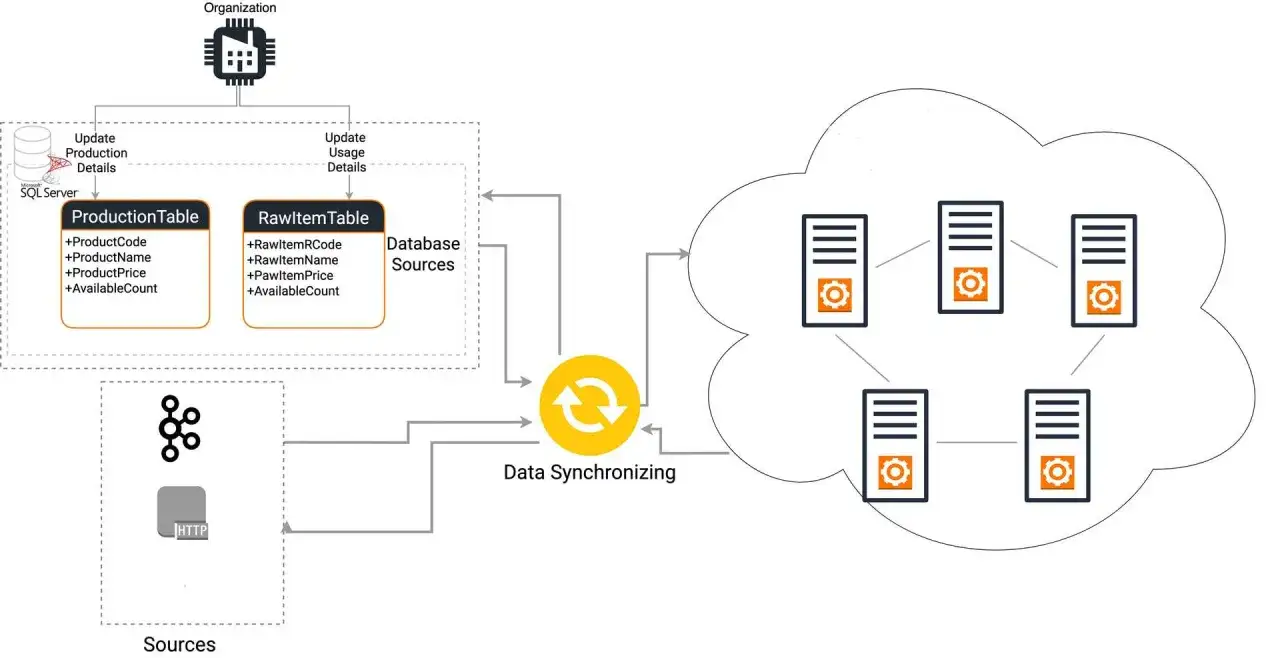
Najbardziej praktyczny przepływ wygląda zwykle tak: pobierasz dane, zapisujesz surową paczkę w stagingu, normalizujesz wartości i dopiero uruchamiasz MERGE. Taki podział jest bezpieczniejszy niż bezpośrednie zapisywanie odpowiedzi API do tabel biznesowych, ponieważ pozwala ponowić import bez ponownego pobierania danych.
- Pobierz dane z API, pliku CSV albo drugiej bazy.
- Zapisz oryginalną paczkę w tabeli stagingowej wraz z identyfikatorem importu.
- Zweryfikuj typy i wartości, na przykład format adresu e-mail, datę oraz wymagane klucze.
- Usuń lub oznacz duplikaty według reguły biznesowej.
- Uruchom MERGE w transakcji na przygotowanym źródle.
- Zapisz rezultat i liczby rekordów dodanych, zmienionych oraz odrzuconych.
Przykład z klientem zewnętrznym dobrze pokazuje, dlaczego staging jest potrzebny. Jeśli API zwróci pustą listę z powodu chwilowego błędu, bezpośredni proces może błędnie potraktować brak danych jako informację o usunięciu wszystkich klientów. Staging pozwala rozdzielić brak danych od świadomej decyzji o usunięciu rekordów.
Warto też przechowywać kolumnę SourceSystem oraz czas importu. Przy kilku źródłach ta informacja ułatwia rozwiązywanie konfliktów, gdy dwa systemy podają inną wartość dla tego samego rekordu.
Różnice między silnikami SQL
Nazwa instrukcji jest podobna, ale szczegóły składni i zachowania nie są identyczne. Przed przeniesieniem zapytania między bazami sprawdź wersję silnika oraz dokumentację konkretnej platformy. Nie zakładaj, że przykład z SQL Server zadziała bez zmian w PostgreSQL albo Oracle.
| Silnik | Charakterystyka | Praktyczna uwaga |
|---|---|---|
| SQL Server i Azure SQL | Obsługuje MERGE, dodatkowe warunki oraz OUTPUT. |
Przy złożonych i silnie współbieżnych operacjach dokładnie testuj blokady i plan wykonania. |
| PostgreSQL | Obsługuje MERGE w nowszych wersjach, a dla prostego upsertu ma też INSERT ... ON CONFLICT. |
Do konfliktu po kluczu unikalnym często wystarczy prostsze i bardziej jednoznaczne ON CONFLICT. |
| Oracle | Instrukcja jest od dawna używana do synchronizacji źródła z tabelą docelową. | Sprawdź ograniczenia dotyczące wielokrotnego dopasowania tego samego rekordu. |
W SQL Server często korzystam z MERGE przy kontrolowanych importach stagingowych, ale nie wybieram go automatycznie do każdej ścieżki zapisu. Microsoft od lat opisuje różnice dotyczące wyzwalaczy, blokad i zachowania w różnych scenariuszach. Jeżeli operacja jest krytyczna biznesowo, osobne UPDATE i INSERT mogą być łatwiejsze do monitorowania oraz strojenia.
W PostgreSQL prosty przypadek „dodaj albo zaktualizuj” często lepiej wyraża INSERT ... ON CONFLICT DO UPDATE. MERGE zyskuje przewagę wtedy, gdy potrzebujesz kilku warunków, różnych akcji albo obsługi większego źródła danych.
Najczęstsze błędy i sposoby ich uniknięcia
Nieunikalny warunek dopasowania
Jeżeli tabela źródłowa ma dwa rekordy z tym samym kluczem, wynik może być nieprzewidywalny albo zakończyć się błędem. Rozwiązaniem jest unikalny indeks, walidacja stagingu i deduplikacja przed uruchomieniem synchronizacji. Unikalność źródła powinna być warunkiem procesu, a nie nadzieją autora zapytania.Brak ograniczeń w tabeli docelowej
Sam kod MERGE nie zastąpi klucza głównego ani indeksu unikalnego. Jeśli ExternalId ma identyfikować klienta, wymuś tę regułę także w schemacie bazy. W przeciwnym razie inny proces może wstawić duplikat pomiędzy kolejnymi importami.
Traktowanie braku rekordu jako usunięcia
Nie dodawaj bezrefleksyjnie obsługi WHEN NOT MATCHED BY SOURCE THEN DELETE. Brak klienta w bieżącej paczce może oznaczać błąd API, filtr albo niepełny import, a nie faktyczne usunięcie. Zwykle bezpieczniej jest oznaczyć rekord jako nieaktywny dopiero po kilku potwierdzonych synchronizacjach.
Brak kontroli współbieżności
Dwa uruchomienia tego samego importu mogą pracować na tym samym źródle. Zadbaj o identyfikator procesu, blokadę lub mechanizm, który nie pozwoli rozpocząć drugiego ładowania przed zakończeniem pierwszego. W przeciwnym razie nawet poprawna składnia nie ochroni przed wyścigiem procesów.
Przeczytaj również: Pętla do-while w C# - składnia, przykłady i pułapki
Ignorowanie wydajności
Warunek ON powinien korzystać z indeksowanych kolumn. Przy dużych tabelach brak indeksu może zamienić synchronizację kilku tysięcy rekordów w długie skanowanie całej tabeli. Przed wdrożeniem sprawdź plan wykonania i zmierz czas dla paczki podobnej do produkcyjnej, nie tylko dla dziesięciu testowych wierszy.
Najlepsza decyzja zależy od rodzaju synchronizacji
MERGE dobrze sprawdza się wtedy, gdy masz przygotowane źródło, stabilny klucz i jasno opisane reguły aktualizacji. Do cyklicznego importu danych z API lub pliku CSV jest wygodny, czytelny i łatwy do połączenia z tabelą stagingową.
Nie traktowałbym go jednak jako obowiązkowego wzorca. Dla prostego pojedynczego upsertu wybierz konstrukcję właściwą dla danego silnika, a przy operacji o wysokiej współbieżności rozważ osobne polecenia i dokładniejsze sterowanie transakcją. Najwięcej bezpieczeństwa daje nie sama instrukcja, lecz unikalny klucz, walidacja źródła, indeksy i możliwość odtworzenia importu.