Praca z tekstem w SQL Server często sprowadza się do wyciągnięcia kilku znaków z dłuższej wartości: prefiksu numeru zamówienia, domeny z adresu e-mail albo fragmentu kodu produktu. Funkcja SUBSTRING robi to precyzyjnie, ale wymaga zrozumienia numerowania znaków, długości fragmentu i zachowania dla wartości NULL. Poniżej pokazuję składnię, praktyczne przykłady, typowe błędy oraz sytuacje, w których lepiej użyć CHARINDEX, LEFT, RIGHT albo STRING_SPLIT.
Najważniejsze zasady wycinania fragmentów tekstu w SQL Server
- SUBSTRING przyjmuje wyrażenie, pozycję początkową i liczbę znaków.
- Numerowanie znaków zaczyna się od 1, a nie od zera.
- Ujemna długość powoduje błąd wykonania zapytania.
- Pozycję fragmentu można wyznaczyć dynamicznie za pomocą CHARINDEX.
- W warunku WHERE funkcja na kolumnie może pogorszyć wydajność i użycie indeksu.
Jak działa funkcja SUBSTRING w SQL Server
Podstawowa składnia jest prosta:
SUBSTRING(expression, start, length)Expression to tekst, kolumna albo inne wyrażenie, z którego pobieramy fragment. Parametr start wskazuje pozycję pierwszego znaku, a length określa, ile znaków ma zostać zwróconych.
SELECT SUBSTRING('Kursdotnet.pl', 1, 4) AS Fragment;Wynikiem będzie Kurs. Pierwszy znak ma pozycję 1, drugi pozycję 2, a kropka w adresie znajduje się na pozycji 11. To drobna różnica względem wielu języków programowania, gdzie indeksowanie często zaczyna się od zera. Sam kilka razy widziałem błąd w zapytaniu wynikający właśnie z automatycznego przeniesienia przyzwyczajeń z C# do T-SQL.
Najważniejsze reguły parametrów
- Gdy start jest większy niż długość tekstu, SQL Server zwraca pusty wynik.
- Gdy start jest mniejszy niż 1, funkcja zaczyna od pierwszego znaku, ale skraca zwracany fragment.
- Jeżeli length wykracza poza koniec tekstu, zwracane są znaki dostępne do końca.
- Ujemna wartość length kończy zapytanie błędem.
- Jeżeli wyrażenie wejściowe ma wartość NULL, wynik również będzie NULL.
SELECT
    SUBSTRING('ABCDEF', 2, 3) AS NormalnyFragment,
    SUBSTRING('ABCDEF', 2, 20) AS ZaDlugieOkno,
    SUBSTRING('ABCDEF', 20, 3) AS PozaTekstem;
Pierwsze wyrażenie zwróci BCD, drugie BCDEF, a trzecie pustą wartość. Funkcja nie dopełnia tekstu spacjami ani zerami, dlatego wynik trzeba samodzielnie przygotować, jeśli aplikacja oczekuje stałego formatu.
Praktyczne przykłady z kolumnami i stałymi pozycjami
Najczęstszy scenariusz to pobranie fragmentu z kolumny tabeli. Załóżmy, że tabela przechowuje identyfikatory produktów w formacie ELEC-2026-0042.
SELECT
    ProductCode,
    SUBSTRING(ProductCode, 1, 4) AS Category,
    SUBSTRING(ProductCode, 6, 4) AS ProductYear,
    SUBSTRING(ProductCode, 11, 4) AS SequenceNumber
FROM Products;
To rozwiązanie działa dobrze, gdy format jest stały i każda część zawsze ma tę samą długość. Jeśli ktoś zmieni dane na ELEC-26-42, pozycje przestaną odpowiadać rzeczywistym fragmentom. Przy danych biznesowych nie zakładam więc stałych pozycji bez sprawdzenia, czy format jest wymuszany przez ograniczenie, walidację aplikacji albo procedurę importu.
Wycinanie prefiksu i końcówki
Jeżeli potrzebujesz tylko początku tekstu, krótszy i czytelniejszy będzie LEFT. Dla końca wartości analogicznie używa się funkcji RIGHT.
SELECT
    LEFT('ORD-2026-000145', 3) AS Prefix,
    RIGHT('ORD-2026-000145', 6) AS Numer;
SUBSTRING daje większą kontrolę, ale nie zawsze jest najlepszym wyborem. Do prostego prefiksu używam LEFT, bo od razu komunikuje zamiar osobie, która będzie utrzymywać zapytanie za kilka miesięcy.
Fragment adresu e-mail
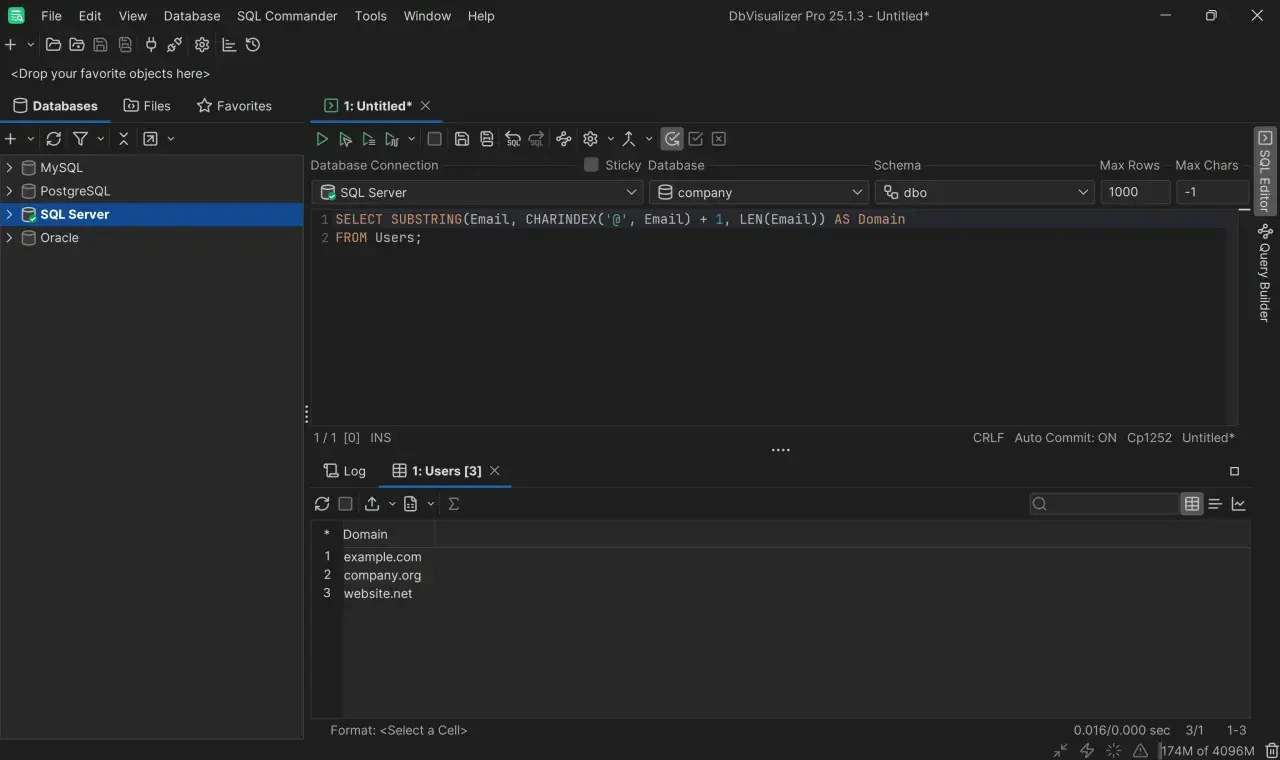
Jeśli dane mają przewidywalny układ, można wyciągnąć domenę po znaku @. Samo SUBSTRING nie wyszukuje separatora, dlatego łączymy je z CHARINDEX.
SELECT
    Email,
    SUBSTRING(
        Email,
        CHARINDEX('@', Email) + 1,
        LEN(Email)
    ) AS DomainName
FROM Users
WHERE Email IS NOT NULL
  AND CHARINDEX('@', Email) > 0;
Warunek z CHARINDEX jest tu istotny. Bez niego rekord pozbawiony znaku @ może zwrócić nieoczekiwany rezultat albo utrudnić późniejszą walidację. Dla bardziej złożonych danych nie traktuję takiego wyrażenia jako pełnego parsera adresów e-mail, lecz jako prostą operację na poprawnie zweryfikowanych wartościach.
Dynamiczna długość fragmentu z CHARINDEX
Stała liczba znaków wystarcza przy kodach o jednolitym formacie. W praktyce częściej trzeba pobrać tekst do pierwszego separatora albo od separatora do końca. Wtedy pozycję i długość obliczamy podczas wykonywania zapytania.
SELECT
    FullName,
    SUBSTRING(
        FullName,
        1,
        CHARINDEX(' ', FullName + ' ') - 1
    ) AS FirstName
FROM Customers;
Dodanie spacji do wartości w CHARINDEX zabezpiecza przypadek, w którym klient ma tylko jedno imię i nie zawiera separatora. Dzięki temu funkcja zawsze znajdzie znak kończący pierwszy fragment. To mały zabieg, ale właśnie takie szczegóły decydują o tym, czy zapytanie działa stabilnie na danych produkcyjnych.
Tekst między dwoma separatorami
Załóżmy, że kolumna przechowuje wartości w formacie PL|MAZ|Warszawa. Chcemy pobrać drugi element, czyli kod województwa.
SELECT
    LocationCode,
    SUBSTRING(
        LocationCode,
        CHARINDEX('|', LocationCode) + 1,
        CHARINDEX('|', LocationCode, CHARINDEX('|', LocationCode) + 1)
            - CHARINDEX('|', LocationCode) - 1
    ) AS RegionCode
FROM Locations;
To działa, ale szybko staje się trudne do czytania. Przy kilku separatorach rozważam STRING_SPLIT albo zmianę modelu danych. Trzeba jednak pamiętać, że w starszych zastosowaniach STRING_SPLIT nie gwarantuje kolejności elementów bez dodatkowej obsługi, dlatego nie używam go bezrefleksyjnie, gdy pozycja fragmentu ma znaczenie.
Bezpieczne obliczanie długości
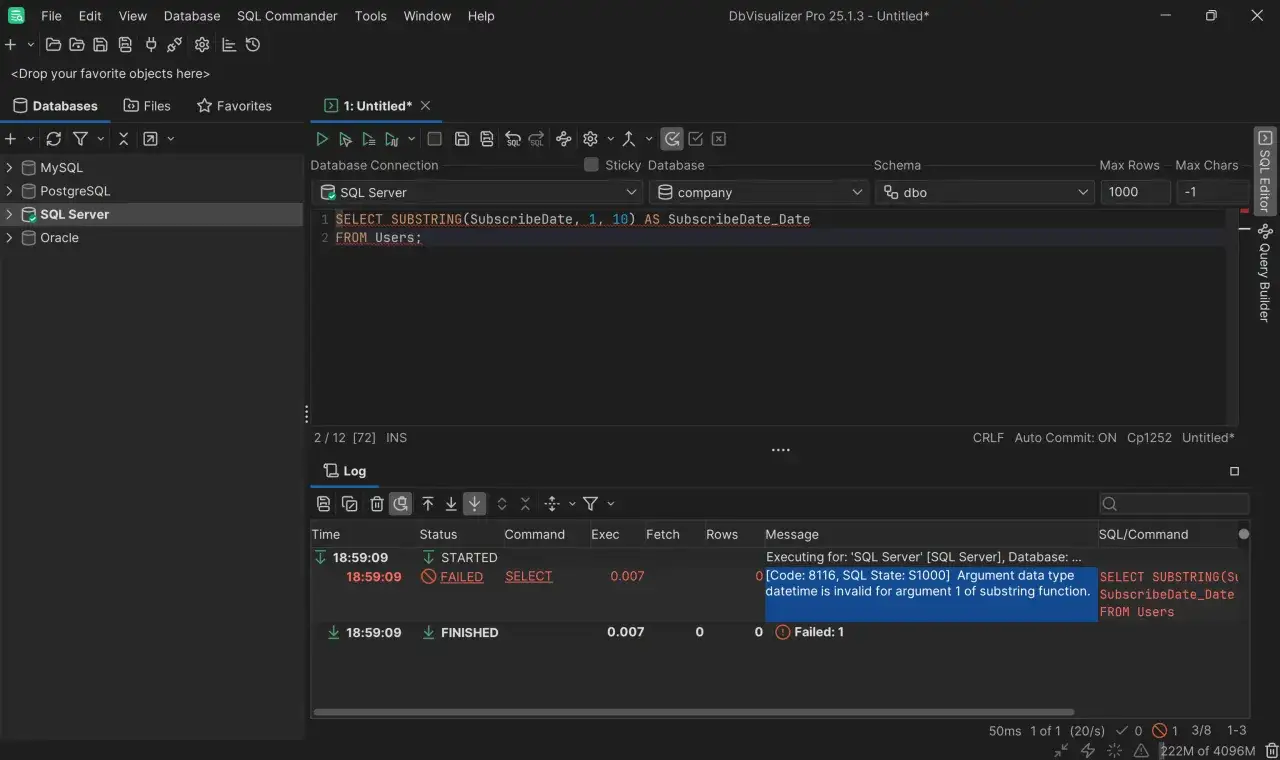
Najczęstszy błąd polega na przekazaniu do SUBSTRING wartości ujemnej. Dzieje się tak, gdy drugi separator nie istnieje albo znajduje się przed pierwszym. Przy niepewnych danych najpierw sprawdzam format, a dopiero później wykonuję wycinanie.
SELECT
    CASE
        WHEN CHARINDEX('|', LocationCode) > 0
         AND CHARINDEX('|', LocationCode, CHARINDEX('|', LocationCode) + 1) > 0
        THEN SUBSTRING(
            LocationCode,
            CHARINDEX('|', LocationCode) + 1,
            CHARINDEX('|', LocationCode, CHARINDEX('|', LocationCode) + 1)
                - CHARINDEX('|', LocationCode) - 1
        )
        ELSE NULL
    END AS RegionCode
FROM Locations;
W wielu projektach lepiej przenieść takie reguły do warstwy importu i zapisać osobne wartości w kolumnach. Dynamiczne parsowanie w każdym SELECT-u jest wygodne na początku, lecz przy dużej liczbie raportów szybko zwiększa koszt utrzymania.
SUBSTRING a inne funkcje tekstowe
Funkcje tekstowe częściowo się pokrywają, ale każda ma inne zastosowanie. Poniższe zestawienie pomaga wybrać prostsze rozwiązanie bez budowania skomplikowanego wyrażenia.
| Funkcja | Najlepsze zastosowanie | Przykład |
|---|---|---|
| SUBSTRING | Fragment wskazany pozycją i długością | SUBSTRING(Code, 6, 4) |
| LEFT | Początek tekstu | LEFT(Code, 3) |
| RIGHT | Koniec tekstu | RIGHT(Code, 4) |
| CHARINDEX | Odnalezienie pozycji znaku lub ciągu | CHARINDEX('-', Code) |
| STUFF | Usunięcie i zastąpienie fragmentu | STUFF(Code, 1, 3, 'NEW') |
| STRING_SPLIT | Podział tekstu na elementy według separatora | STRING_SPLIT(Tags, ',') |
Moja praktyczna zasada jest prosta. Do stałej pozycji wybieram SUBSTRING, do początku lub końca LEFT albo RIGHT, a do znalezienia separatora CHARINDEX. Jeżeli tekst jest listą elementów, lepiej użyć STRING_SPLIT niż wielokrotnie zagnieżdżać SUBSTRING.
Typowe błędy i wpływ na wydajność
Mylenie pozycji z indeksem
W SQL Server pierwszy znak ma pozycję 1. Dla tekstu ABC wyrażenie SUBSTRING('ABC', 1, 1) zwróci A, a SUBSTRING('ABC', 0, 1) nie oznacza pierwszego znaku w taki sam sposób jak indeks 0 w C#.
Brak kontroli wartości NULL
SUBSTRING nie zamienia NULL na pusty tekst. Jeżeli aplikacja oczekuje wartości domyślnej, użyj jawnie COALESCE.
SELECT COALESCE(SUBSTRING(DisplayName, 1, 1), '?') AS Initial
FROM Users;
To rozróżnienie ma znaczenie w raportach, filtrach i eksportach. Pusty tekst i NULL mogą być później interpretowane jako dwie różne informacje.
Używanie funkcji na kolumnie w WHERE
Zapytanie poniżej jest czytelne, ale przy dużej tabeli może wymagać odczytania wielu wierszy:
SELECT *
FROM Orders
WHERE SUBSTRING(OrderNumber, 1, 3) = 'ORD';
Jeśli chodzi tylko o prefiks, zwykle lepiej zapisać warunek jako:
SELECT *
FROM Orders
WHERE OrderNumber LIKE 'ORD%';
Powód jest praktyczny: funkcja wykonana na kolumnie może uniemożliwić efektywne użycie zwykłego indeksu. Gdy filtrowanie po wyciętym fragmencie jest częste, rozważam kolumnę obliczaną, ewentualnie utrwaloną i zindeksowaną. Takie rozwiązanie ma sens dopiero po sprawdzeniu planu wykonania i rzeczywistego czasu zapytań, a nie na podstawie samego przeczucia.
Przeczytaj również: COALESCE w PostgreSQL - jak bezpiecznie obsługiwać NULL?
Różnice między wersjami SQL Server
W SQL Server 2022 i starszych wersjach parametr length jest wymagany. W SQL Server 2025 i nowszych oraz w wybranych usługach Azure SQL można pominąć długość, aby pobrać tekst od wskazanej pozycji do końca.
SELECT SUBSTRING('Kursdotnet.pl', 6) AS OdSzostegoZnaku;Jeżeli zapytanie ma działać w kilku środowiskach, nie korzystam z opcjonalnego parametru bez sprawdzenia wersji docelowej bazy. Jawne podanie długości jest bardziej przenośne i często czytelniejsze dla zespołu.
Jak podejść do SUBSTRING w projekcie produkcyjnym
Przed napisaniem wyrażenia sprawdzam trzy rzeczy: czy format danych jest stały, czy separator zawsze występuje oraz czy funkcja będzie używana tylko do prezentacji, czy także do filtrowania. Te trzy odpowiedzi zwykle pokazują, czy wystarczy prosty SUBSTRING, czy potrzebna jest walidacja, osobna kolumna albo zmiana struktury tabeli.
- Dla stałych kodów stosuj pozycję i długość.
- Dla tekstu z separatorami połącz SUBSTRING z CHARINDEX i zabezpiecz brakujące znaki.
- Dla prostego początku lub końca użyj LEFT albo RIGHT.
- Dla częstego filtrowania rozważ indeksowaną kolumnę obliczaną.
- Dla wieloelementowych list sprawdź, czy dane nie powinny trafić do osobnej tabeli.
Największa pułapka nie leży w samej składni, tylko w założeniu, że wszystkie wartości są poprawne. Jedna niepełna wartość może wygenerować ujemną długość, pusty fragment albo błędny wynik raportu. Dlatego przed wdrożeniem testuję przypadki normalne, NULL, brak separatora, zbyt krótki tekst i dane zawierające znaki narodowe.
SUBSTRING jest małą funkcją, ale dobrze użyta rozwiązuje wiele codziennych problemów w T-SQL. Najważniejsze jest zapamiętanie, że pozycje zaczynają się od 1, długość musi być poprawna, a dynamiczne parsowanie warto stosować tylko tam, gdzie rzeczywiście pasuje do jakości i struktury danych.