Gdy tabela przechowuje strukturę folderów, hierarchię pracowników albo zależności między komponentami, zwykły JOIN szybko przestaje wystarczać. W dokumentacji spotkasz wtedy angielski termin sql recursive query, czyli zapytanie, które korzysta z własnego wyniku i krok po kroku przechodzi przez kolejne poziomy danych. Pokażę, jak budować takie zapytania, czym różnią się składnie popularnych baz oraz jak uniknąć zapętlenia i problemów z wydajnością.
Rekurencyjne CTE pozwala przejść przez hierarchię bez pętli w kodzie aplikacji
-
CTE rekurencyjne składa się z części startowej i rekurencyjnej połączonych operatorem
UNION ALL. - Warunek zakończenia musi sprawić, że kolejna iteracja zwróci zero wierszy.
- Najczęstsze zastosowania to drzewa kategorii, struktury organizacyjne, foldery, BOM-y i grafy zależności.
-
SQL Server używa składni
WITHbez słowaRECURSIVE, a PostgreSQL, MySQL i SQLite korzystają zWITH RECURSIVE. - Bezpieczeństwo zwiększają limit głębokości, śledzenie odwiedzonych elementów i indeks na kolumnie relacji.
Najpierw zrozum model danych
Zapytanie rekurencyjne ma sens wtedy, gdy rekord wskazuje na inny rekord w tej samej tabeli albo gdy relacja tworzy graf. Klasyczny przykład to tabela kategorii, w której parent_id wskazuje kategorię nadrzędną. Jeden wiersz może być korzeniem, a pozostałe tworzą jego dzieci, wnuki i kolejne poziomy.
CREATE TABLE categories (
    id        INT PRIMARY KEY,
    parent_id INT NULL,
    name      VARCHAR(100) NOT NULL
);
Przykładowe dane mogą wyglądać tak, że „Elektronika” jest rodzicem dla „Komputerów”, a „Komputery” dla „Laptopów”. Dla bazy to nie jest gotowe drzewo, tylko zestaw płaskich relacji. Rekurencja składa te relacje w ścieżkę, którą można później wyświetlić, filtrować albo wykorzystać w dalszym zapytaniu.
| id | parent_id | name |
|---|---|---|
| 1 | NULL | Elektronika |
| 2 | 1 | Komputery |
| 3 | 2 | Laptopy |
| 4 | 1 | Monitory |
Najważniejsza decyzja projektowa brzmi: w którą stronę będziesz przechodzić? Możesz zacząć od korzenia i schodzić do dzieci albo wskazać konkretny węzeł i szukać jego przodków. Oba warianty używają podobnego mechanizmu, ale mają inną część startową i inne warunki filtrowania.
Jak zbudować rekurencyjne CTE krok po kroku
Każde takie zapytanie ma dwa elementy. Pierwszy to anchor member, czyli zapytanie startowe zwracające pierwszy zestaw wierszy. Drugi to recursive member, który odwołuje się do nazwy CTE i pobiera następny poziom danych.
WITH RECURSIVE category_tree AS (
    SELECT
        id,
        parent_id,
        name,
        0 AS depth
    FROM categories
    WHERE parent_id IS NULL

    UNION ALL

    SELECT
        child.id,
        child.parent_id,
        child.name,
        tree.depth + 1
    FROM categories AS child
    JOIN category_tree AS tree
        ON child.parent_id = tree.id
)
SELECT id, parent_id, name, depth
FROM category_tree
ORDER BY depth, id;
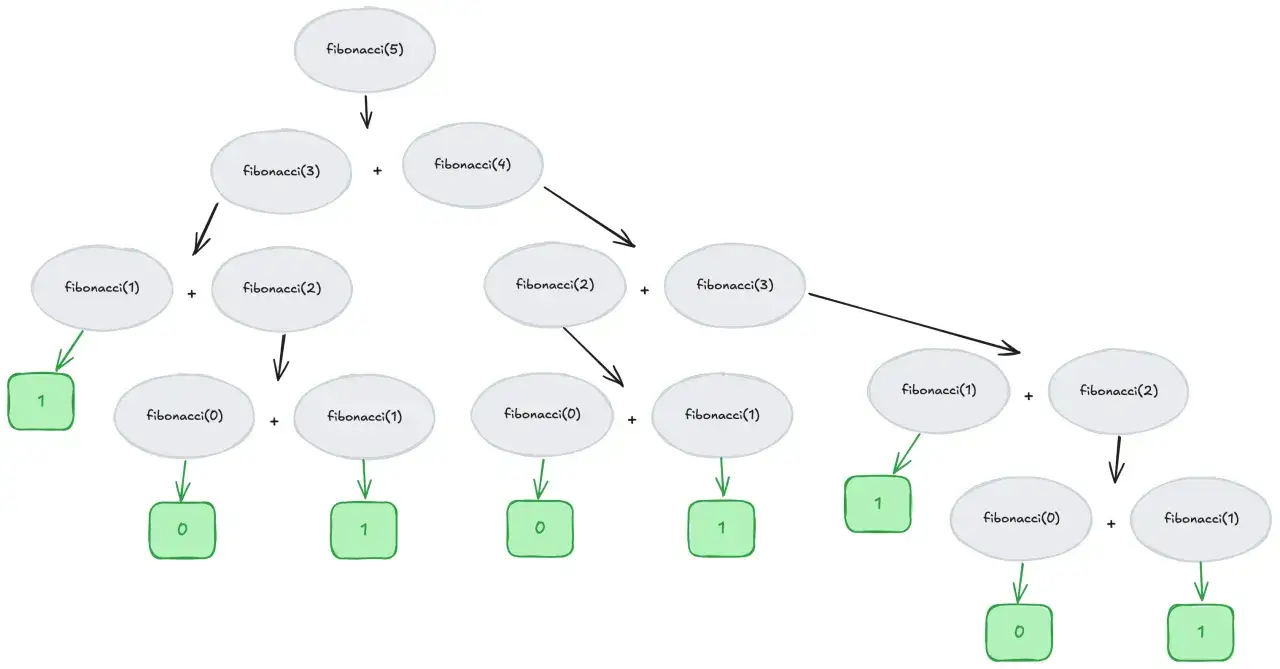
W pierwszym przebiegu baza zwraca „Elektronikę” z poziomem 0. Część rekurencyjna znajduje jej dzieci i nadaje im poziom 1, a potem szuka dzieci tych dzieci. Proces kończy się automatycznie wtedy, gdy JOIN nie znajdzie już kolejnych rekordów.
Kolumna depth nie jest obowiązkowa, ale w praktyce dodaję ją niemal zawsze. Ułatwia kontrolę głębokości, budowanie wcięć w interfejsie i szybkie wykrycie podejrzanie głębokiej gałęzi. Jeśli chcesz wyświetlić pełną ścieżkę, możesz przechowywać ją jako tekst.
WITH RECURSIVE category_tree AS (
    SELECT
        id,
        parent_id,
        name,
        0 AS depth,
        name AS path
    FROM categories
    WHERE parent_id IS NULL

    UNION ALL

    SELECT
        child.id,
        child.parent_id,
        child.name,
        tree.depth + 1,
        tree.path || ' / ' || child.name
    FROM categories AS child
    JOIN category_tree AS tree
        ON child.parent_id = tree.id
)
SELECT name, depth, path
FROM category_tree
ORDER BY path;
Operator łączenia tekstu zależy od silnika. W PostgreSQL i SQLite użyjesz ||, natomiast w SQL Server typowym rozwiązaniem będzie CONCAT albo operator +. Typy kolumn części startowej i rekurencyjnej muszą być zgodne, dlatego przy dłuższych ścieżkach trzeba czasem jawnie zastosować CAST.
Hierarchie pracowników i folderów
Jednym z najbardziej praktycznych zastosowań jest znalezienie wszystkich osób podlegających danemu menedżerowi. Model jest prosty: tabela zawiera identyfikator pracownika oraz manager_id. Zapytanie może zwrócić zarówno bezpośrednich podwładnych, jak i osoby znajdujące się kilka poziomów niżej.
WITH RECURSIVE team AS (
    SELECT
        employee_id,
        manager_id,
        name,
        0 AS level
    FROM employees
    WHERE employee_id = 10

    UNION ALL

    SELECT
        employee.employee_id,
        employee.manager_id,
        employee.name,
        team.level + 1
    FROM employees AS employee
    JOIN team
        ON employee.manager_id = team.employee_id
)
SELECT employee_id, name, level
FROM team
ORDER BY level, name;
W tym przykładzie rekord o identyfikatorze 10 jest punktem startowym. Jeśli chcesz zwrócić wyłącznie podwładnych, możesz pominąć go w końcowym SELECT, filtrując po level > 0. Taki szczegół często ma znaczenie w API, bo użytkownik zwykle oczekuje listy zespołu, a nie dodatkowo danych osoby, od której rozpoczęto wyszukiwanie.
Ten sam wzorzec działa dla folderów. Nie zakładaj jednak, że kolejność wierszy jest kolejnością drzewa. Sama rekurencja zwraca rekordy w kolejności zależnej od silnika i planu wykonania. Do stabilnego sortowania potrzebujesz ścieżki, numerów porządkowych albo osobnego klucza określającego kolejność rodzeństwa.
Przeczytaj również: Funkcje okna w PostgreSQL - rankingi, sumy i LAG
Gdy potrzebujesz przodków zamiast potomków
Wyszukiwanie ścieżki do katalogu nadrzędnego wymaga odwrócenia JOIN-a. Startujesz od wybranego folderu, a potem przechodzisz z parent_id do id rodzica.
WITH RECURSIVE ancestors AS (
    SELECT
        id,
        parent_id,
        name,
        0 AS distance
    FROM categories
    WHERE id = 3

    UNION ALL

    SELECT
        parent.id,
        parent.parent_id,
        parent.name,
        ancestors.distance + 1
    FROM categories AS parent
    JOIN ancestors
        ON parent.id = ancestors.parent_id
)
SELECT id, name, distance
FROM ancestors
ORDER BY distance;
To rozróżnienie jest proste, ale bardzo często powoduje błędy. Przechodzenie po dzieciach używa warunku w rodzaju child.parent_id = tree.id, a przechodzenie po rodzicach zwykle parent.id = tree.parent_id. Zanim dodasz kolejne filtry, rozpisz jeden przebieg na kartce. Oszczędza to sporo czasu przy większych strukturach.
Grafy zależności wymagają ochrony przed cyklem
Drzewo zakłada, że każdy element ma najwyżej jednego rodzica i że nie da się wrócić do wcześniej odwiedzonego węzła. Graf może mieć wiele połączeń, a relacja przypadkowo może tworzyć cykl. Przykładowo pakiet A zależy od B, B od C, a C ponownie od A.
WITH RECURSIVE dependencies AS (
    SELECT
        package_id,
        depends_on_id,
        0 AS depth,
        CAST(package_id AS VARCHAR(1000)) AS visited
    FROM package_dependencies
    WHERE package_id = 100

    UNION ALL

    SELECT
        relation.package_id,
        relation.depends_on_id,
        dependencies.depth + 1,
        dependencies.visited || ',' || relation.depends_on_id
    FROM package_dependencies AS relation
    JOIN dependencies
        ON relation.package_id = dependencies.depends_on_id
    WHERE dependencies.depth < 50
      AND dependencies.visited NOT LIKE '%' || relation.depends_on_id || '%'
)
SELECT package_id, depends_on_id, depth
FROM dependencies;
Ten przykład pokazuje dwa zabezpieczenia. Limit poziomu chroni przed zbyt długim przejściem, a lista odwiedzonych identyfikatorów ogranicza powrót do tych samych elementów. W produkcyjnym kodzie nie traktowałbym jednak prostego LIKE jako idealnego mechanizmu, bo identyfikator 12 może zostać pomylony z fragmentem 112. Bezpieczniejsza jest tablica identyfikatorów, typ JSON albo format ścieżki z jednoznacznymi separatorami.
PostgreSQL oferuje również konstrukcję CYCLE, która upraszcza wykrywanie cykli w rekurencyjnym CTE. W rozwiązaniu przenośnym między bazami częściej spotkasz ręczne śledzenie ścieżki. Nie zamieniaj bezmyślnie UNION ALL na UNION, licząc na rozwiązanie problemu. Usuwanie duplikatów może pomóc w prostych przypadkach, ale jeśli wynik zawiera poziom lub ścieżkę, kolejne wiersze nadal mogą nie być identyczne.
Składnia zależy od silnika bazy
Idea pozostaje ta sama, lecz szczegóły składni nie są identyczne. Ten fakt jest szczególnie ważny w projektach .NET, gdzie aplikacja może zmienić dostawcę bazy albo obsługiwać kilka silników. Przed przeniesieniem zapytania sprawdź nie tylko słowo RECURSIVE, lecz także ograniczenia części rekurencyjnej i sposób konkatenacji tekstu.
| Silnik | Składnia | Praktyczna uwaga |
|---|---|---|
| PostgreSQL | WITH RECURSIVE |
Obsługuje śledzenie cykli przez CYCLE w nowszych wersjach. |
| MySQL 8+ | WITH RECURSIVE |
Głębokość kontroluje między innymi cte_max_recursion_depth. |
| SQLite | WITH RECURSIVE |
Przydatne są LIMIT i ORDER BY w części rekurencyjnej, jeśli pasują do problemu. |
| SQL Server | WITH |
Limit dla pojedynczego zapytania ustawisz przez OPTION (MAXRECURSION n). |
W SQL Server odpowiednik przykładu nie zawiera słowa RECURSIVE. Jeśli poprzednia instrukcja w partii nie kończy się średnikiem, często trzeba rozpocząć CTE od ;WITH. Przy testach dobrym zabezpieczeniem jest OPTION (MAXRECURSION 100). Wartość 0 oznacza brak limitu, dlatego zostawianie jej w kodzie produkcyjnym bez dodatkowej ochrony uważam za zły nawyk.
;WITH category_tree AS (
    SELECT id, parent_id, name, 0 AS depth
    FROM categories
    WHERE parent_id IS NULL

    UNION ALL

    SELECT child.id, child.parent_id, child.name, tree.depth + 1
    FROM categories AS child
    JOIN category_tree AS tree
        ON child.parent_id = tree.id
)
SELECT id, parent_id, name, depth
FROM category_tree
OPTION (MAXRECURSION 100);
Wydajność zależy od modelu i warunku stopu
Rekurencyjne CTE nie jest magiczną optymalizacją. Upraszcza zapis i przenosi przechodzenie po danych do bazy, ale przy szerokim drzewie może wygenerować bardzo dużo wierszy. Największą różnicę robi zwykle indeks na kolumnie używanej w JOIN-ie, na przykład categories(parent_id) albo employees(manager_id).
Przed wdrożeniem sprawdź plan wykonania i przetestuj kilka przypadków: korzeń z dużą liczbą dzieci, głęboka pojedyncza gałąź, pusty wynik oraz uszkodzone dane. Sam czas dla małej tabeli niczego nie dowodzi. CTE, które działa w milisekundach dla 500 rekordów, może stać się problemem po załadowaniu setek tysięcy zależności.
- Ogranicz zbiór startowy, jeśli interesuje Cię jedna gałąź, a nie całe drzewo.
- Dodaj limit głębokości, gdy biznes zna maksymalny poziom hierarchii.
- Indeksuj klucz rodzica, ponieważ to on jest najczęściej używany w rekurencyjnym JOIN-ie.
- Nie sortuj zbyt wcześnie, bo sortowanie pełnego wyniku może wymusić przetworzenie całej rekurencji.
- Rozważ spłaszczony model, gdy zapytania odczytują ogromne drzewa znacznie częściej, niż dane się zmieniają.
Jeżeli hierarchia jest płytka i zmienia się często, model adjacency list z rekurencyjnym CTE zwykle jest rozsądnym wyborem. Gdy odczyty dominują, a zapytania regularnie pobierają całe poddrzewa, możesz rozważyć materialized path, tabelę domknięcia albo przechowywanie ścieżki. Nie wybieraj bardziej złożonego modelu tylko dlatego, że wygląda szybciej. Koszt aktualizacji i ryzyko niespójności też są częścią wydajności systemu.
Rekurencja działa dobrze, gdy ma wyraźną granicę
Najczęstszy błąd nie polega na złym słowie kluczowym, tylko na braku pewności, że kolejna iteracja kiedyś się skończy. Zanim uruchomię zapytanie na danych produkcyjnych, sprawdzam, czy relacja rzeczywiście prowadzi do nowych rekordów oraz czy dane mogą zawierać cykle. Warunek stopu powinien wynikać z modelu danych, a limit techniczny traktuję jako drugą linię obrony.
Dobry wzorzec jest prosty: wybierz rekord początkowy, dołącz dokładnie następny poziom, zwiększ głębokość, kontroluj odwiedzone elementy i dopiero na końcu dodaj prezentacyjne sortowanie. W ten sposób rekurencyjne zapytanie pozostaje czytelne, testowalne i łatwiejsze do przeniesienia między PostgreSQL, SQL Server, MySQL oraz SQLite.
Jeżeli dane tworzą zwykłe drzewo, zacznij od WITH RECURSIVE i kolumny depth. Jeżeli opisują graf, od razu zaplanuj ochronę przed cyklem. To właśnie te dwa rozróżnienia decydują, czy rozwiązanie będzie praktycznym narzędziem do pracy z hierarchią, czy źródłem trudnego do wykrycia problemu z nieskończoną rekurencją.