Gdy trzeba szybko przygotować kopię tabeli do testów, raportu albo migracji, najważniejsze pytanie brzmi nie „jak skopiować wszystko”, lecz co dokładnie ma zostać zachowane. Zapytania typu sql copy table mogą oznaczać samo przeniesienie danych, pusty szablon struktury albo pełną kopię z kluczami, indeksami i ograniczeniami. Poniżej pokazuję praktyczne metody dla SQL Server, PostgreSQL, MySQL i SQLite oraz pułapki, przez które pozornie poprawna kopia często nie jest wierną kopią.
Najszybszy wybór metody zależy od tego, co chcesz zachować
-
Nowa tabela z danymi powstaje przez
CREATE TABLE AS SELECTalboSELECT INTOw SQL Server. -
Istniejąca tabela docelowa wymaga instrukcji
INSERT INTO ... SELECT. - Struktura bez rekordów ma różną składnię w każdym silniku, a SQLite nie kopiuje automatycznie kluczy ani ograniczeń.
- Indeksy, klucze i triggery zwykle trzeba odtworzyć osobno.
- Kopia nie jest backupem, ponieważ nie zabezpiecza całej bazy, metadanych ani spójności między tabelami.
Najpierw ustal, co ma zostać skopiowane
Jedna tabela to nie tylko wiersze. Składają się na nią także kolumny, typy danych, wartości domyślne, klucz główny, klucze obce, indeksy, ograniczenia CHECK, triggery i czasem uprawnienia. Proste polecenie kopiujące wynik zapytania zazwyczaj przenosi kolumny oraz dane, ale pomija część pozostałych elementów.
Ja przed napisaniem skryptu rozdzielam trzy scenariusze. Dzięki temu nie oczekuję od krótkiego zapytania właściwości, których ono po prostu nie ma.
| Cel | Co kopiujemy | Typowa metoda |
|---|---|---|
| Kopia robocza | Kolumny i wybrane rekordy |
CREATE TABLE AS SELECT lub SELECT INTO
|
| Pusty szablon | Struktura tabeli bez danych |
LIKE, WHERE 1 = 0 albo ręczne CREATE TABLE
|
| Zasilenie istniejącej tabeli | Dane dopasowane do gotowych kolumn | INSERT INTO ... SELECT |
| Pełny klon | Struktura, indeksy, ograniczenia i dane | DDL tabeli, osobne indeksy i kontrolowane kopiowanie danych |
To rozróżnienie ma praktyczne znaczenie. Kopia do analizy może celowo nie mieć kluczy i indeksów, natomiast tabela używana przez aplikację powinna zachować reguły integralności. W drugim przypadku automatyczne kopiowanie „wszystkiego” jednym poleceniem jest zwykle zbyt optymistycznym założeniem.
Najszybsza kopia danych do nowej tabeli
Jeżeli tabela docelowa jeszcze nie istnieje, najwygodniejszy jest wariant oparty na zapytaniu SELECT. Pozwala od razu skopiować całość, wybrane kolumny albo tylko rekordy spełniające warunek.
SQL Server i instrukcja SELECT INTO
SELECT *
INTO dbo.OrdersCopy
FROM dbo.Orders;
SQL Server utworzy tabelę dbo.OrdersCopy i wypełni ją wynikiem zapytania. Filtrowanie danych jest równie proste.
SELECT OrderId, CustomerId, CreatedAt, TotalAmount
INTO dbo.RecentOrders
FROM dbo.Orders
WHERE CreatedAt >= '2026-01-01';
To dobre rozwiązanie dla kopii roboczej, eksportu lub tabeli stagingowej, czyli obszaru, w którym dane są chwilowo przygotowywane przed dalszym przetwarzaniem. Trzeba jednak pamiętać, że SELECT INTO nie odtworzy automatycznie indeksów, triggerów ani wszystkich ograniczeń tabeli źródłowej.
PostgreSQL, MySQL, SQLite i Oracle
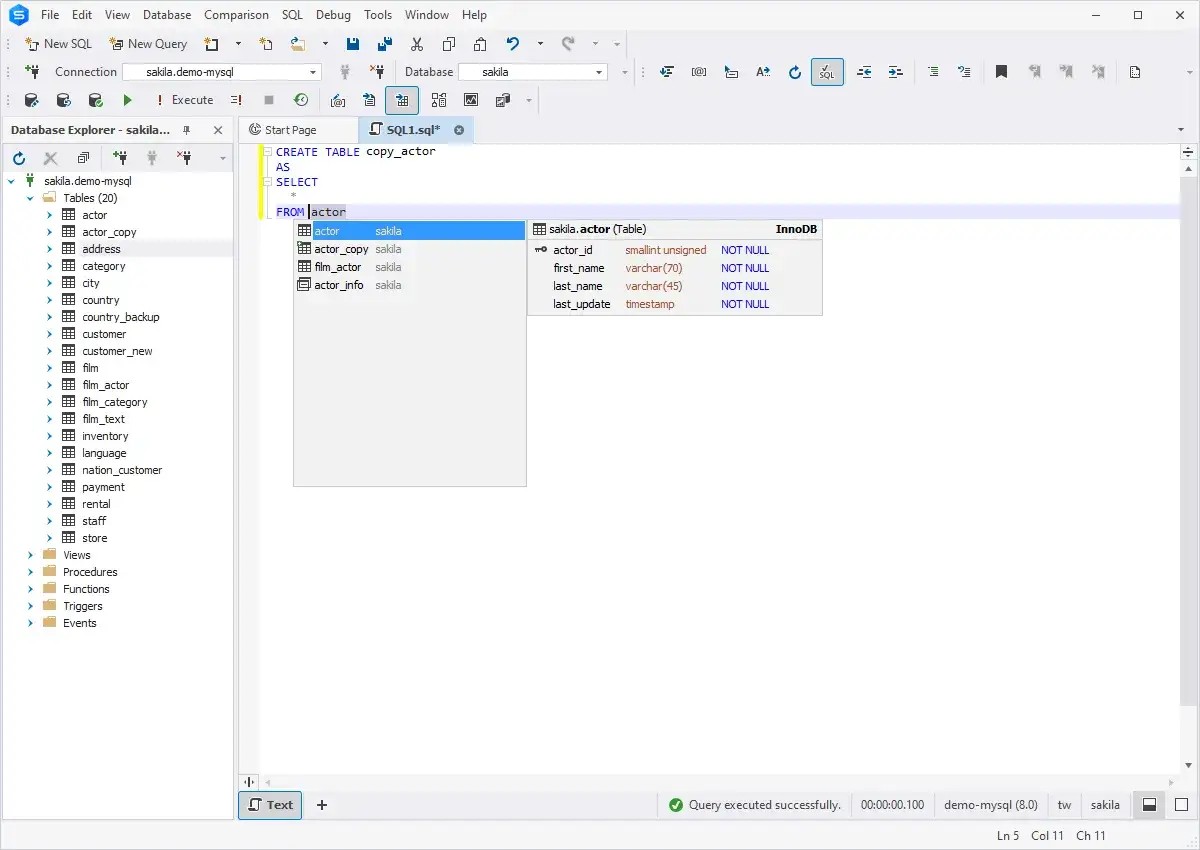
W wielu silnikach używa się konstrukcji CREATE TABLE ... AS SELECT. Przykład jest czytelny i łatwo rozszerzyć go o filtr albo transformację danych.
CREATE TABLE orders_copy AS
SELECT *
FROM orders;
Można również kopiować tylko wybrany wycinek:
CREATE TABLE orders_archive AS
SELECT OrderId, CustomerId, CreatedAt, TotalAmount
FROM orders
WHERE CreatedAt < '2025-01-01';
W PostgreSQL taka forma jest preferowana nad starszym wariantem SELECT INTO, ponieważ ten drugi zapis ma dodatkowe znaczenia w kodzie proceduralnym. W SQLite tabela utworzona przez CREATE TABLE AS SELECT otrzyma kolumny i dane, ale nie dostanie klucza głównego ani ograniczeń. MySQL również rozdziela kopiowanie definicji od kopiowania danych, dlatego przy ważnych tabelach trzeba zastosować dokładniejszy wariant opisany niżej.
Nie używaj SELECT * w skryptach, które mają żyć długo
Gwiazdkę stosuję podczas jednorazowej pracy, ale w migracjach i procesach produkcyjnych wolę jawnie wymieniać kolumny. Gdy ktoś później doda kolumnę do tabeli źródłowej, skrypt z SELECT * może zacząć tworzyć inny wynik albo przestać pasować do tabeli docelowej.
CREATE TABLE orders_copy AS
SELECT
    OrderId,
    CustomerId,
    CreatedAt,
    TotalAmount
FROM orders
WHERE TotalAmount > 1000;
Jawna lista kolumn dokumentuje intencję i chroni przed przypadkowym skopiowaniem danych wrażliwych. W praktyce to mała zmiana, która mocno poprawia stabilność skryptu po zmianach schematu.
Gdy tabela docelowa już istnieje
Jeśli wcześniej utworzyłeś strukturę tabeli albo chcesz dopisać dane do istniejącego archiwum, użyj INSERT INTO ... SELECT. Ta metoda nie tworzy nowej tabeli, więc to Ty decydujesz o typach kolumn, kluczach, indeksach i wartościach domyślnych.
INSERT INTO OrdersArchive
    (OrderId, CustomerId, CreatedAt, TotalAmount)
SELECT
    OrderId,
    CustomerId,
    CreatedAt,
    TotalAmount
FROM Orders
WHERE CreatedAt < '2025-01-01';
Najbezpieczniej wymienić kolumny po obu stronach. Kolejność musi odpowiadać sobie znaczeniowo, a typy danych powinny być zgodne lub mieć kontrolowaną konwersję. Wstawienie kwoty tekstowej do kolumny liczbowej albo pominięcie kolumny wymaganej przez NOT NULL skończy się błędem lub niepożądanym przekształceniem.
Ta forma przydaje się także do kopiowania danych między tabelami o podobnej, ale nieidentycznej strukturze.
INSERT INTO CustomersArchive
    (CustomerId, FullName, Email)
SELECT
    Id,
    Name,
    EmailAddress
FROM Customers
WHERE IsDeleted = 1;
W tym przykładzie nazwy kolumn są inne, ale sens danych pozostaje jasny. To podejście wybieram wtedy, gdy kopia ma być częścią procesu biznesowego, a nie mechanicznym powieleniem tabeli.
Jak utworzyć pustą tabelę o podobnej strukturze
Czasem potrzebujesz tabeli bez danych, na przykład do testów, importu lub buforowania wyników. Najprostszy wariant polega na użyciu zapytania, które nigdy nie zwróci wiersza.
Wariant zgodny z SELECT
CREATE TABLE orders_empty AS
SELECT *
FROM orders
WHERE 1 = 0;
W SQL Server analogiczny efekt daje:
SELECT TOP (0) *
INTO dbo.OrdersEmpty
FROM dbo.Orders;
To szybki sposób na uzyskanie kolumn, ale nie pełnej definicji tabeli. W SQLite, a często także w kopiach tworzonych przez CTAS w innych silnikach, trzeba później osobno dodać PRIMARY KEY, UNIQUE, CHECK i indeksy.
Przeczytaj również: PIVOT w SQL Serverze bez tajemnic - przykłady i dobre praktyki
Metody specyficzne dla silnika
Jeżeli zależy Ci na dokładniejszym odwzorowaniu struktury bez rekordów, użyj możliwości konkretnego systemu.
-- PostgreSQL
CREATE TABLE orders_empty
(LIKE orders INCLUDING ALL);

-- MySQL
CREATE TABLE orders_empty LIKE orders;

-- SQLite, tylko kolumny i typy wynikające z SELECT
CREATE TABLE orders_empty AS
SELECT *
FROM orders
WHERE 0;
MySQL przez CREATE TABLE ... LIKE kopiuje definicję tabeli oraz indeksy, ale nie należy zakładać, że odwzoruje wszystkie zależności zewnętrzne. PostgreSQL z INCLUDING ALL potrafi skopiować znacznie więcej elementów definicji, jednak przy tabelach produkcyjnych i tak sprawdzam wynikowy DDL.
Moja praktyczna zasada jest prosta: do testowego bufora wystarczy CTAS, a do tabeli wykorzystywanej przez aplikację lepiej użyć jawnej definicji CREATE TABLE albo narzędzia generującego skrypt DDL.
Pełna kopia wymaga więcej niż przeniesienia wierszy
Najwięcej nieporozumień pojawia się przy słowie „kopia”. Polecenie, które przeniosło 100 tysięcy rekordów, może nadal utworzyć tabelę nieprzydatną dla aplikacji, bo zabrakło klucza głównego, indeksu unikalnego lub triggera.
Przy pełnym klonie pracuję w kilku etapach:
- Odtwarzam definicję tabeli wraz z typami, wartościami domyślnymi i ograniczeniami.
- Dodaję indeksy oraz klucze obce, uwzględniając kolejność zależności.
- Kopiuję dane przez
INSERT INTO ... SELECT. - Tworzę triggery i sprawdzam, czy podczas ładowania danych powinny być aktywne.
- Porównuję liczbę rekordów oraz najważniejsze klucze biznesowe.
Warto zwrócić uwagę na kolumny automatyczne. IDENTITY, AUTO_INCREMENT i sekwencje nie zachowują się identycznie w każdym silniku. Skopiowanie wartości identyfikatorów nie zawsze oznacza skopiowanie aktualnego licznika, więc kolejny insert może zakończyć się konfliktem albo wymagać ustawienia sekwencji na właściwą wartość.
Podobnie jest z kolumnami wyliczanymi i generowanymi. Gdy nowa tabela powstaje z wyrażenia w SELECT, typ, nullowalność lub sposób wyliczania kolumny może różnić się od oryginału. Dlatego po utworzeniu kopii sprawdzam definicję w katalogu systemowym lub narzędziu administracyjnym, zamiast ufać samej składni zapytania.
Kopiowanie między bazami i bezpieczna kontrola wyniku
Przeniesienie tabeli między schematami jest zwykle proste, ale kopiowanie między osobnymi bazami zależy od silnika. W SQL Server można odwołać się do tabeli nazwą obejmującą bazę i schemat:
SELECT *
INTO Reporting.dbo.OrdersCopy
FROM Sales.dbo.Orders;
W MySQL podobny zapis wykorzystuje nazwę bazy przed nazwą tabeli:
CREATE TABLE reporting.orders_copy AS
SELECT *
FROM sales.orders;
W PostgreSQL osobne bazy nie są domyślnie dostępne w jednym zwykłym zapytaniu. Do takiego zadania stosuje się między innymi postgres_fdw, eksport i import albo narzędzia migracyjne. SQLite pozwala podłączyć drugi plik przez ATTACH DATABASE, a potem odwołać się do tabeli z aliasem bazy.
ATTACH DATABASE 'source.db' AS source_db;

CREATE TABLE main.orders_copy AS
SELECT *
FROM source_db.orders;
Po wykonaniu kopii nie poprzestaję na komunikacie „query completed”. Najpierw porównuję liczbę wierszy:
SELECT COUNT(*) AS source_rows
FROM Orders;

SELECT COUNT(*) AS copied_rows
FROM OrdersCopy;
Przy kopii filtrowanej liczba rekordów powinna odpowiadać warunkowi, a nie tabeli źródłowej. Dodatkowo sprawdzam kilka kluczy, wartości skrajne oraz rekordy, które nie znalazły odpowiednika w tabeli docelowej. Taka krótka kontrola wykrywa literówki w nazwie kolumny, nieoczekiwany filtr i problemy z konwersją typów.
Jeśli w trakcie kopiowania źródło jest modyfikowane, trzeba też pomyśleć o spójności. Pojedyncze zapytanie często daje spójny obraz danych zgodnie z izolacją transakcji danego silnika, ale kopiowanie kilku tabel osobnymi poleceniami może już uchwycić różne momenty. Przy krytycznych danych używam transakcji, odpowiedniego poziomu izolacji albo krótkiego okna, w którym aplikacja nie zapisuje zmian.
Duża kopia może zająć dużo miejsca i obciążyć log transakcyjny, I/O oraz indeksy. Dlatego przed operacją produkcyjną sprawdzam rozmiar tabeli, wolne miejsce i czas wykonania na reprezentatywnej próbce. Sama składnia jest krótka, ale jej koszt zależy od liczby wierszy, indeksów i równoległego ruchu w bazie.
Dobra kopia tabeli zaczyna się od właściwej definicji celu
Do szybkiej kopii danych wybierz SELECT INTO w SQL Server albo CREATE TABLE AS SELECT w pozostałych popularnych silnikach. Gdy tabela docelowa już istnieje, użyj INSERT INTO ... SELECT i jawnie wskaż kolumny.
Jeżeli potrzebujesz wiernego klonu, potraktuj kopiowanie jako małą migrację. Odtwórz DDL, indeksy, ograniczenia i triggery, a potem zweryfikuj dane. Tabela utworzona jednym zapytaniem jest świetnym narzędziem roboczym, ale nie zastępuje backupu ani pełnego procesu odtwarzania bazy.