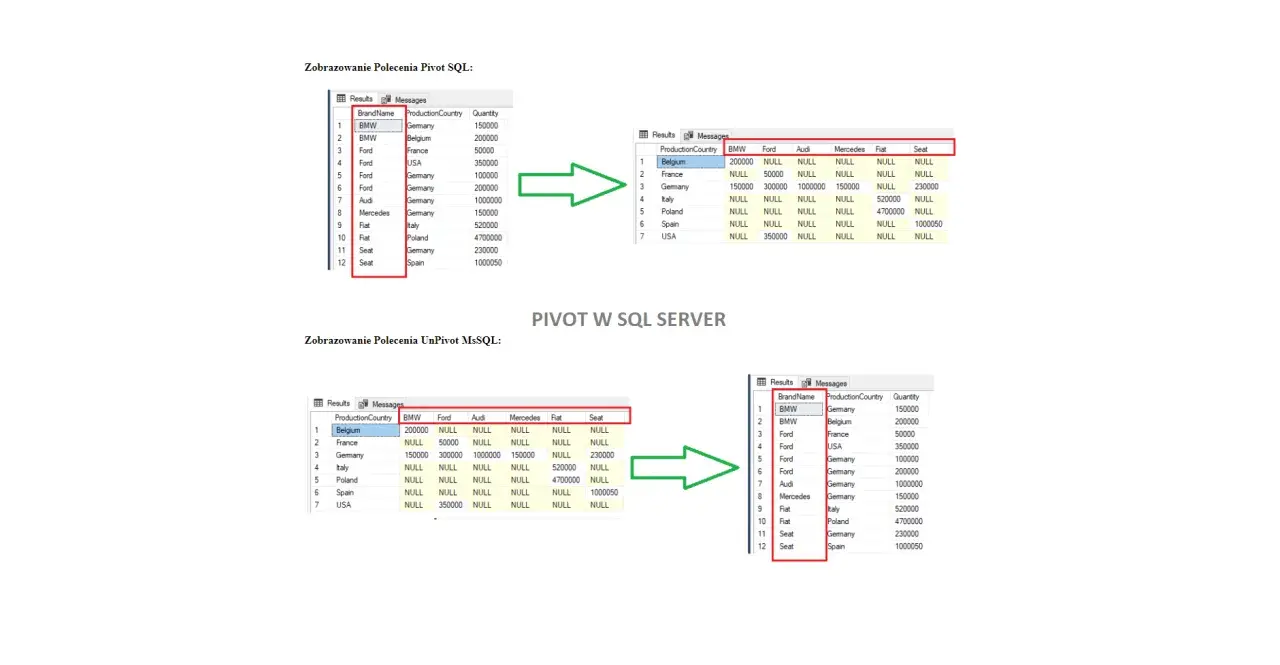
Raport zaczyna się od danych zapisanych w wierszach, ale odbiorca często potrzebuje miesięcy, kategorii albo statusów pokazanych jako osobne kolumny. Do takiej zmiany układu służy operator PIVOT w SQL Serverze. Pokażę, jak działa, jak budować zapytania statyczne i dynamiczne, kiedy lepiej użyć CASE, a także jak uniknąć pustych wartości, błędów agregacji i problemów z wydajnością.
Najważniejsze zasady pivotowania danych w SQL Serverze
- PIVOT obraca dane, zamieniając wartości z jednego pola na kolumny wyniku.
- Operator wymaga funkcji agregującej, najczęściej
SUM,COUNTalboMAX. - Lista kolumn w klasycznym zapytaniu jest statyczna i musi zostać podana w klauzuli
IN. - Przy zmiennej liczbie kategorii stosuje się dynamiczny SQL z
QUOTENAMEisp_executesql. - W prostych raportach alternatywą bywa agregacja warunkowa z użyciem
SUM(CASE WHEN ...).
Jak działa pivotowanie danych w SQL Serverze
Załóżmy, że tabela sprzedaży przechowuje jeden rekord dla każdej transakcji. W takim układzie miesiąc znajduje się w kolumnie Miesiac, a wartość sprzedaży w kolumnie Kwota. Dla aplikacji jest to wygodne, ale raport miesięczny często powinien mieć osobne kolumny dla stycznia, lutego i marca.
PIVOT zamienia unikalne wartości jednej kolumny na nagłówki i jednocześnie agreguje dane. Pozostała kolumna, na przykład handlowiec, wyznacza wiersze wyniku. To ważne, bo operator nie kopiuje danych mechanicznie. Najpierw grupuje je według kolumn, które nie biorą udziału w obracaniu.
| Element | Rola |
|---|---|
Handlowiec |
Kolumna opisująca wiersze wyniku |
Miesiac |
Kolumna, której wartości staną się nagłówkami |
Kwota |
Wartość podlegająca agregacji |
SUM |
Sposób połączenia wielu rekordów w jednej komórce |
Najprościej zapamiętać składnię w trzech częściach. Najpierw przygotowuję źródło danych, potem wskazuję agregowaną kolumnę i pole zawierające nagłówki, a na końcu wymieniam kolumny wynikowe w IN. Właśnie ta ostatnia lista sprawia, że podstawowa wersja jest statyczna.
Prosty przykład z miesięczną sprzedażą
Do demonstracji wystarczy tabela tymczasowa. W prawdziwej aplikacji będzie to zapewne tabela faktów sprzedaży albo wynik zapytania łączącego zamówienia z pozycjami zamówień.
CREATE TABLE #Sprzedaz
(
    Handlowiec nvarchar(100),
    Miesiac varchar(3),
    Kwota decimal(12, 2)
);

INSERT INTO #Sprzedaz (Handlowiec, Miesiac, Kwota)
VALUES
    (N'Anna', 'Sty', 12000.00),
    (N'Anna', 'Sty', 3500.00),
    (N'Anna', 'Lut', 9800.00),
    (N'Anna', 'Mar', 11300.00),
    (N'Piotr', 'Sty', 7200.00),
    (N'Piotr', 'Lut', 10400.00),
    (N'Piotr', 'Mar', 8700.00);
Zapytanie z operatorem PIVOT może wyglądać tak:
SELECT
    Handlowiec,
    [Sty],
    [Lut],
    [Mar]
FROM
(
    SELECT
        Handlowiec,
        Miesiac,
        Kwota
    FROM #Sprzedaz
) AS Dane
PIVOT
(
    SUM(Kwota)
    FOR Miesiac IN ([Sty], [Lut], [Mar])
) AS Raport
ORDER BY Handlowiec;
Wynikiem będą dwa wiersze, po jednym dla każdego handlowca, oraz trzy kolumny miesięczne. Dwa rekordy Anny ze stycznia zostaną połączone przez SUM(Kwota), więc w kolumnie Sty pojawi się wartość 15 500.
Podzapytanie źródłowe powinno zawierać tylko pola potrzebne do raportu. To drobna rzecz, ale ograniczenie liczby kolumn ułatwia przewidzenie sposobu grupowania. Gdy przypadkowo dodamy do źródła na przykład identyfikator transakcji, SQL Server może potraktować go jako dodatkowy wymiar i zwrócić więcej wierszy, niż oczekujemy.
Jak obsłużyć brakujące wartości
Jeżeli Piotr nie miał sprzedaży w marcu, wynik dla [Mar] będzie miał wartość NULL. To prawidłowe zachowanie, ale raport prezentowany użytkownikowi zwykle powinien pokazywać zero zamiast pustej komórki.
SELECT
    Handlowiec,
    COALESCE([Sty], 0) AS [Sty],
    COALESCE([Lut], 0) AS [Lut],
    COALESCE([Mar], 0) AS [Mar]
FROM
(
    SELECT Handlowiec, Miesiac, Kwota
    FROM #Sprzedaz
) AS Dane
PIVOT
(
    SUM(Kwota)
    FOR Miesiac IN ([Sty], [Lut], [Mar])
) AS Raport;
COALESCE działa już na wyniku pivotowania. Nie próbowałbym zastępować nim braków w tabeli źródłowej, ponieważ brak sprzedaży i sprzedaż o wartości zero mogą oznaczać różne rzeczy biznesowe. To rozróżnienie ma znaczenie przy późniejszych analizach.
Statyczny i dynamiczny PIVOT mają różne zastosowania
Statyczny wariant dobrze sprawdza się wtedy, gdy zestaw kolumn jest znany z góry. Miesiące, kwartały i stałe statusy zamówień zwykle spełniają ten warunek. Zapytanie jest czytelne, łatwe do testowania i bezpieczne dla raportu, który musi mieć zawsze taki sam układ.
Problem pojawia się wtedy, gdy kolumny wynikowe wynikają z danych. Mogą to być produkty, lata, kody regionów albo nowe statusy dodawane przez administratora. W takiej sytuacji lista w IN musi zostać wygenerowana przed wykonaniem zapytania.
| Wariant | Kiedy go wybrać | Największa zaleta | Ograniczenie |
|---|---|---|---|
| Statyczny PIVOT | Stały zestaw kategorii | Czytelność i przewidywalny wynik | Trzeba ręcznie zmieniać listę kolumn |
| Dynamiczny PIVOT | Kolumny zależne od danych | Automatyczne dopasowanie raportu | Więcej kodu i trudniejsze testowanie |
SUM(CASE) |
Mało kolumn i proste warunki | Pełna kontrola nad logiką | Zapytanie szybko robi się długie |
Przeczytaj również: TRUNCATE TABLE czy DELETE? Różnice, ryzyko i zastosowania
Bezpieczny dynamiczny raport
Przy dynamicznym wariancie najpierw pobieram unikalne wartości miesięcy, a potem tworzę z nich listę nazw kolumn. QUOTENAME chroni identyfikatory, czyli nazwy kolumn, ale nie zastępuje parametrów dla wartości filtrowanych przez użytkownika.
DECLARE @Kolumny nvarchar(max);
DECLARE @Sql nvarchar(max);

SELECT @Kolumny =
    STRING_AGG(QUOTENAME(Miesiac), ',')
    WITHIN GROUP (ORDER BY Miesiac)
FROM
(
    SELECT DISTINCT Miesiac
    FROM dbo.Sprzedaz
    WHERE DataSprzedazy >= '20260101'
      AND DataSprzedazy <  '20270101'
) AS Lista;

IF @Kolumny IS NULL
    THROW 50001, 'Brak danych do utworzenia raportu.', 1;

SET @Sql = N'
SELECT Handlowiec, ' + @Kolumny + N'
FROM
(
    SELECT Handlowiec, Miesiac, Kwota
    FROM dbo.Sprzedaz
    WHERE DataSprzedazy >= @Od
      AND DataSprzedazy <  @Do
) AS Dane
PIVOT
(
    SUM(Kwota)
    FOR Miesiac IN (' + @Kolumny + N')
) AS Raport
ORDER BY Handlowiec;';

EXEC sys.sp_executesql
    @Sql,
    N'@Od date, @Do date',
    @Od = '20260101',
    @Do = '20270101';
W tym przykładzie nazwy kolumn są składane dynamicznie, ale daty pozostają parametrami. Takie rozdzielenie jest istotne dla bezpieczeństwa i planowania zapytań. Nie należy doklejać bezpośrednio do tekstu SQL wartości pochodzących z formularza, adresu URL ani pliku importowanego od użytkownika.
Dynamiczny raport ma też koszt organizacyjny. Konsument wyniku, na przykład kod C# albo kontrolka tabeli, nie zna z góry liczby kolumn. Jeżeli aplikacja potrzebuje stabilnego kontraktu, lepszy będzie statyczny raport albo zwykły wynik wierszowy, który dopiero warstwa prezentacji zamieni na tabelę.
Kiedy lepsze będzie CASE zamiast PIVOT
Operator PIVOT nie jest jedynym sposobem na obracanie danych. Przy dwóch lub trzech znanych kategoriach często wybieram agregację warunkową, ponieważ jej logika jest bardziej oczywista dla osoby, która nie używa tego operatora na co dzień.
SELECT
    Handlowiec,
    SUM(CASE WHEN Miesiac = 'Sty' THEN Kwota ELSE 0 END) AS [Sty],
    SUM(CASE WHEN Miesiac = 'Lut' THEN Kwota ELSE 0 END) AS [Lut],
    SUM(CASE WHEN Miesiac = 'Mar' THEN Kwota ELSE 0 END) AS [Mar]
FROM #Sprzedaz
GROUP BY Handlowiec
ORDER BY Handlowiec;
Oba podejścia mogą zwrócić ten sam wynik. CASE daje większą swobodę, gdy każda kolumna ma inną regułę, na przykład osobny filtr, limit albo przelicznik. PIVOT wygrywa natomiast czytelnością, gdy raport rzeczywiście polega na zamianie wartości jednej kolumny na nagłówki.
Nie kierowałbym się samą długością zapytania. Ważniejsze jest to, czy osoba utrzymująca raport łatwo sprawdzi, skąd wzięła się dana liczba. W systemach .NET i Azure często warto też rozważyć, czy formatowanie nie powinno zostać wykonane w warstwie raportowej, zamiast budować bardzo szeroki wynik w bazie.
UNPIVOT i powrót do danych wierszowych
Czasem problem jest odwrotny. Otrzymujemy tabelę z kolumnami Sty, Lut i Mar, ale potrzebujemy jednego pola Miesiac oraz jednego pola Kwota. Do takiej normalizacji służy UNPIVOT.
WITH Raport AS
(
    SELECT *
    FROM
    (
        VALUES
            (N'Anna', 15500.00, 9800.00, 11300.00),
            (N'Piotr', 7200.00, 10400.00, 8700.00)
    ) AS V(Handlowiec, Sty, Lut, Mar)
)
SELECT
    Handlowiec,
    Miesiac,
    Kwota
FROM Raport
UNPIVOT
(
    Kwota FOR Miesiac IN ([Sty], [Lut], [Mar])
) AS Dane;
UNPIVOT przydaje się podczas importu arkuszy kalkulacyjnych i migracji danych zapisanych w szerokim układzie. Trzeba jednak uważać na wartości NULL, ponieważ puste komórki mogą nie pojawić się w wyniku. Przed dalszym przetwarzaniem dobrze sprawdzić, czy brak rekordu oznacza brak danych, czy tylko brak wartości w konkretnej kolumnie.
Wydajność i błędy, które psują wynik
Najczęstszy problem nie wynika z samego PIVOT-a, lecz z danych przekazanych do operatora. Jeżeli źródło zawiera niepotrzebne kolumny, nieunikalne identyfikatory albo nieprzefiltrowane miliony rekordów, raport może być wolny i zwracać zaskakująco szczegółowe wyniki.
- Filtruj dane przed pivotowaniem, zwłaszcza po dacie i jednostce organizacyjnej.
- Przekazuj do podzapytania tylko kolumny potrzebne do raportu.
- Sprawdź, czy wybrana funkcja agregująca odpowiada znaczeniu danych.
- Nie stosuj wielu kolejnych operacji
PIVOTiUNPIVOTbez pomiaru planu wykonania. - Przy dynamicznym SQL kontroluj przypadek pustej listy kolumn.
Typowa pomyłka polega na użyciu COUNT tam, gdzie potrzebna jest suma kwot, albo na użyciu MAX tylko dlatego, że zapytanie wymaga agregacji. Funkcja agregująca nie jest formalnością. Określa, co stanie się z wieloma rekordami przypadającymi na jedną komórkę raportu.
Wydajność sprawdzam na rzeczywistym planie wykonania, a nie na małej tabeli testowej. Przy dużych zbiorach indeks na kolumnach używanych w filtrze i połączeniach może zrobić większą różnicę niż sama zamiana PIVOT-a na CASE. Ostateczny wybór warto oprzeć na pomiarze czasu, liczbie odczytanych stron i pamięci przydzielonej zapytaniu.
Nie warto też budować bardzo szerokiego wyniku tylko dlatego, że tabela wygląda wtedy efektownie. Duża liczba dynamicznych kolumn utrudnia eksport, testowanie i obsługę w aplikacji. Często bardziej trwałym rozwiązaniem jest pozostawienie danych w układzie wierszowym i zbudowanie tabeli przestawnej dopiero w Power BI, Excelu albo interfejsie aplikacji.
Dobry wybór zależy od kształtu raportu
Gdy kolumny są znane i raport ma mieć stały układ, wybrałbym statyczny PIVOT. Gdy lista kategorii zmienia się zależnie od danych, potrzebny będzie wariant dynamiczny, ale trzeba zabezpieczyć nazwy kolumn, parametry i przypadek pustego wyniku.
Do krótkiego zapytania z kilkoma warunkami agregacja przez SUM(CASE) bywa prostsza w utrzymaniu. Najważniejsze jest nie samo użycie konkretnego operatora, lecz świadome ustalenie, co wyznacza wiersz, co staje się kolumną i jak łączone są wartości.
Jeżeli te trzy decyzje są jasne, pivotowanie danych w SQL Serverze przestaje być sztuczką składniową. Staje się zwykłym sposobem dopasowania danych do raportu, przy zachowaniu kontroli nad poprawnością, bezpieczeństwem i wydajnością.