Gdy jedno zapytanie SQL potrzebuje wyniku innego zapytania, nie trzeba od razu budować skomplikowanych procedur ani przenosić danych do aplikacji. Zagnieżdżony SELECT pozwala filtrować rekordy, obliczać wartości i tworzyć tymczasowe zestawy danych w ramach jednego polecenia. W praktyce zapis typu select from select oznacza właśnie pracę z podzapytaniami, dlatego pokażę jego najważniejsze warianty, przykłady oraz pułapki związane z wydajnością.
Zagnieżdżone zapytania upraszczają filtrowanie i analizę danych
- Podzapytanie to instrukcja SELECT umieszczona wewnątrz innego zapytania.
- Możesz używać go w klauzulach WHERE, FROM, SELECT oraz HAVING.
- Operator IN sprawdza wiele wartości, a EXISTS jedynie obecność pasującego rekordu.
- Podzapytanie skalarne musi zwrócić jedną wartość, inaczej baza zgłosi błąd.
- Przy większych zbiorach danych często lepszym wyborem będzie JOIN lub CTE.
Podzapytanie SQL w prostym przykładzie
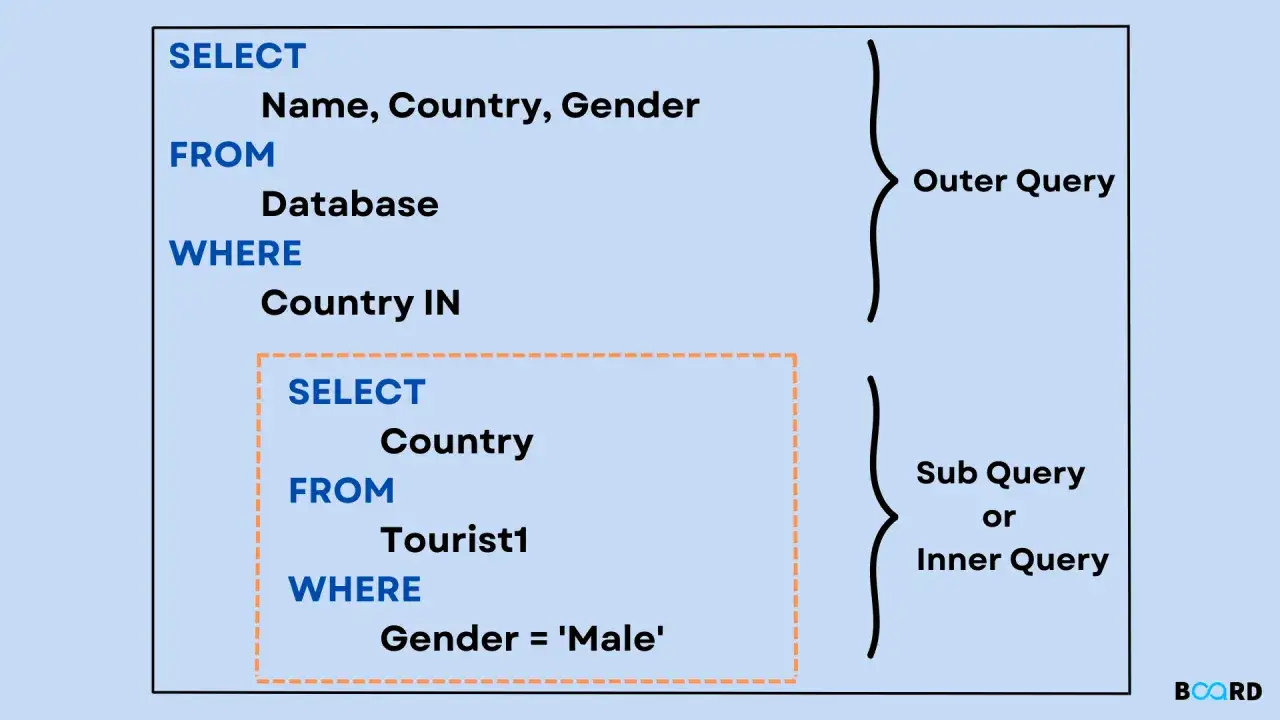
Podzapytanie, nazywane też subquery albo nested query, jest zwykłym poleceniem SELECT umieszczonym w innym zapytaniu. Zapytanie wewnętrzne przygotowuje wynik, a zapytanie zewnętrzne wykorzystuje go do dalszego filtrowania lub prezentacji danych.
Załóżmy, że mamy tabelę Products z kolumnami ProductName i Price. Chcemy pobrać produkty droższe niż średnia cena wszystkich produktów:
SELECT ProductName, Price
FROM Products
WHERE Price > (
    SELECT AVG(Price)
    FROM Products
);
Wewnętrzny SELECT oblicza średnią, na przykład 250 zł. Zewnętrzne zapytanie porównuje z nią cenę każdego produktu. To dobry przykład podzapytania skalarnego, ponieważ zwraca ono dokładnie jedną wartość.
Ja traktuję takie zapytanie jako dwa logiczne kroki. Najpierw baza ustala wartość referencyjną, a dopiero później wybiera rekordy spełniające warunek. Dzięki temu kod jest czytelniejszy niż ręczne wpisywanie aktualnej średniej, która przecież może zmienić się po dodaniu nowych danych.
Podzapytanie w WHERE pozwala filtrować dane z innej tabeli
Najczęstsze zastosowanie zagnieżdżonego SELECT-a polega na filtrowaniu jednej tabeli na podstawie wyników z drugiej. Przykładem może być pobranie klientów, którzy złożyli przynajmniej jedno zamówienie.
SELECT CustomerId, CustomerName
FROM Customers
WHERE CustomerId IN (
    SELECT CustomerId
    FROM Orders
);
Operator IN porównuje wartość z kolumny CustomerId z całym zestawem zwróconym przez podzapytanie. Wewnętrzny SELECT może zwrócić wiele wierszy, ale powinien zwracać jedną kolumnę, której typ pasuje do wartości porównywanej w zapytaniu zewnętrznym.
Jeżeli interesuje nas przeciwna sytuacja, czyli klienci bez zamówień, możemy użyć NOT IN:
SELECT CustomerId, CustomerName
FROM Customers
WHERE CustomerId NOT IN (
    SELECT CustomerId
    FROM Orders
);
Tu pojawia się ważna pułapka. Jeżeli podzapytanie zwróci choć jedną wartość NULL, działanie NOT IN może dać zaskakujący rezultat i nie zwrócić żadnego rekordu. W praktyce bezpieczniej użyć NOT EXISTS albo odfiltrować wartości puste:
SELECT CustomerId, CustomerName
FROM Customers c
WHERE NOT EXISTS (
    SELECT 1
    FROM Orders o
    WHERE o.CustomerId = c.CustomerId
);
W tym przypadku nie interesuje nas konkretna wartość z zamówienia. Sprawdzamy wyłącznie, czy powiązany rekord istnieje. Dlatego EXISTS często lepiej oddaje intencję i nie ma problemu z NULL-em w taki sposób jak NOT IN.
IN, EXISTS i podzapytanie skalarne rozwiązują różne problemy
Te konstrukcje bywają wrzucane do jednego worka, ale ich znaczenie jest inne. Dobór operatora wpływa na czytelność zapytania, a czasem także na plan wykonania.
| Konstrukcja | Kiedy jej użyć | Wynik podzapytania |
|---|---|---|
IN |
Gdy porównujesz wartość z listą wyników | Jedna kolumna, wiele wierszy |
EXISTS |
Gdy sprawdzasz, czy istnieje powiązany rekord | Informacja logiczna TRUE/FALSE |
| Podzapytanie skalarne | Gdy potrzebujesz jednej wartości, np. średniej lub maksimum | Jedna wartość |
NOT EXISTS |
Gdy szukasz rekordów bez odpowiednika w drugiej tabeli | Informacja logiczna TRUE/FALSE |
Przykład z EXISTS może wyglądać tak:
SELECT p.ProductId, p.ProductName
FROM Products p
WHERE EXISTS (
    SELECT 1
    FROM OrderItems oi
    WHERE oi.ProductId = p.ProductId
);
Wewnętrzne zapytanie jest powiązane z bieżącym rekordem produktu przez p.ProductId. To podzapytanie skorelowane, czyli takie, które korzysta z wartości dostępnej w zapytaniu zewnętrznym. Baza analizuje zależność dla kolejnych produktów, choć optymalizator może wykonać ją znacznie sprytniej niż dosłownie wiersz po wierszu.
SELECT w FROM tworzy tymczasowy zestaw danych
Podzapytanie może wystąpić nie tylko w WHERE, lecz także w klauzuli FROM. Wtedy działa jak tymczasowa tabela, często nazywana derived table. Taki wariant przydaje się, gdy chcesz najpierw pogrupować dane, a dopiero potem filtrować wynik agregacji.
Załóżmy, że chcemy znaleźć klientów, których łączna wartość zamówień przekracza 10 000 zł:
SELECT CustomerId, TotalAmount
FROM (
    SELECT CustomerId, SUM(OrderAmount) AS TotalAmount
    FROM Orders
    GROUP BY CustomerId
) AS CustomerTotals
WHERE TotalAmount > 10000;
Wewnętrzne zapytanie tworzy zestaw zawierający jednego klienta w każdym wierszu. Zewnętrzny SELECT filtruje już gotowe sumy. Alias CustomerTotals jest wymagany w wielu silnikach baz danych, dlatego nie warto go pomijać nawet wtedy, gdy konkretna wersja systemu dopuszcza taki zapis.
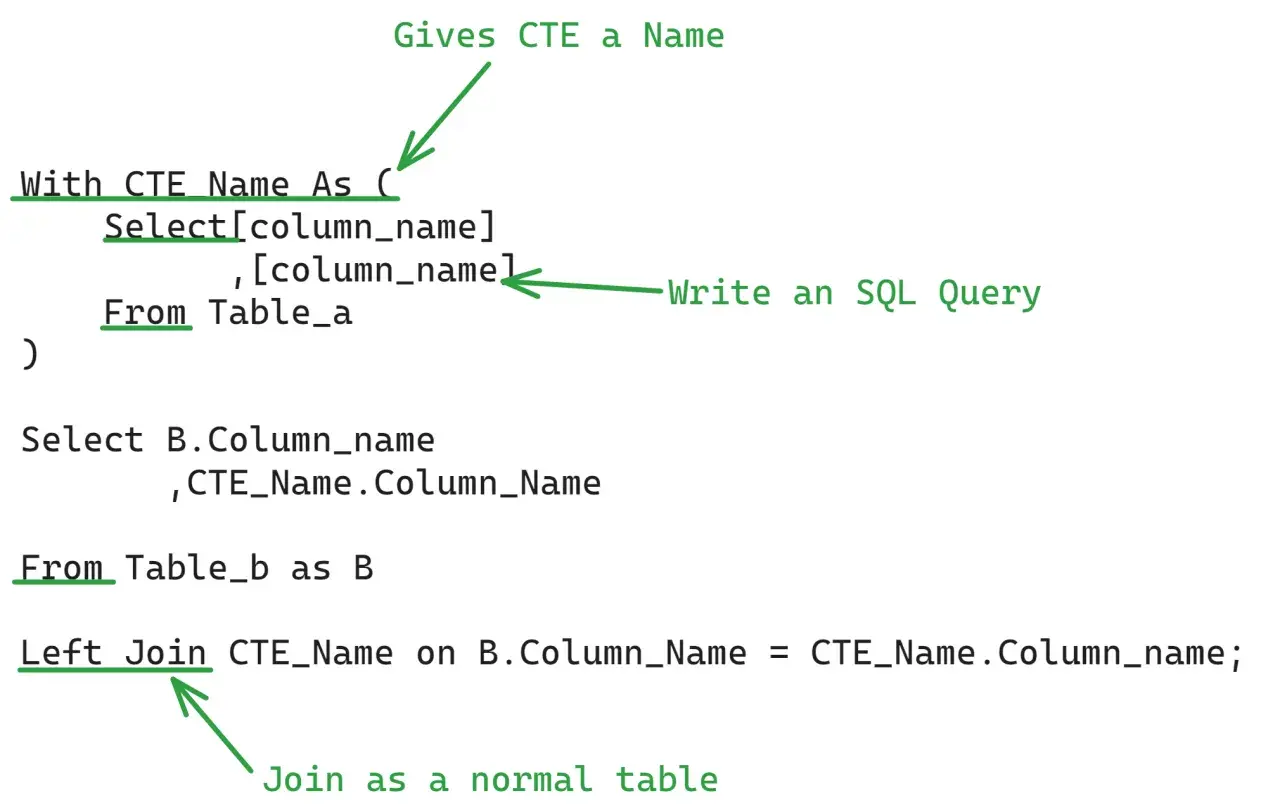
Podobny efekt można uzyskać za pomocą CTE, czyli konstrukcji WITH:
WITH CustomerTotals AS (
    SELECT CustomerId, SUM(OrderAmount) AS TotalAmount
    FROM Orders
    GROUP BY CustomerId
)
SELECT CustomerId, TotalAmount
FROM CustomerTotals
WHERE TotalAmount > 10000;
Moim zdaniem CTE wygrywa z długim SELECT-em w FROM, gdy zapytanie ma kilka etapów albo będzie rozwijane przez innych programistów. Samo podzapytanie jest krótsze, ale przy rozbudowanej logice szybko staje się trudne do czytania.
Podzapytanie w SELECT oblicza wartość dla każdego rekordu
Możesz także umieścić SELECT bezpośrednio na liście wybieranych kolumn. Wtedy podzapytanie dostarcza dodatkową wartość do każdego wiersza wyniku.
SELECT
    c.CustomerId,
    c.CustomerName,
    (
        SELECT COUNT(*)
        FROM Orders o
        WHERE o.CustomerId = c.CustomerId
    ) AS OrderCount
FROM Customers c;
Wynik pokaże klientów oraz liczbę ich zamówień. To wygodny zapis, szczególnie gdy potrzebujesz jednej prostej wartości, ale przy dużej liczbie klientów może być mniej korzystny niż agregacja połączona z JOIN.
Alternatywa wygląda następująco:
SELECT
    c.CustomerId,
    c.CustomerName,
    COUNT(o.OrderId) AS OrderCount
FROM Customers c
LEFT JOIN Orders o
    ON o.CustomerId = c.CustomerId
GROUP BY c.CustomerId, c.CustomerName;
Podzapytanie lepiej pokazuje pojedynczą zależność, natomiast JOIN z GROUP BY często daje optymalizatorowi większe pole manewru. Nie traktuję jednak JOIN-a jako automatycznie lepszego rozwiązania. Jeżeli liczy się prostota i tabela jest niewielka, podzapytanie w SELECT może być najbardziej zrozumiałym wyborem.
Najczęstsze błędy przy zagnieżdżonych SELECT-ach
Podzapytanie zwraca zbyt wiele wierszy
Ten kod może zakończyć się błędem:
SELECT ProductName
FROM Products
WHERE Price = (
    SELECT Price
    FROM Products
    WHERE CategoryId = 3
);
Jeżeli kategoria zawiera kilka produktów, wewnętrzny SELECT zwróci wiele cen, a operator = oczekuje jednej wartości. Rozwiązaniem może być IN, funkcja agregująca albo dodatkowy warunek ograniczający wynik do jednego rekordu.
Podzapytanie zwraca zbyt wiele kolumn
Operator IN potrzebuje jednej kolumny:
WHERE CustomerId IN (
    SELECT CustomerId, CustomerName
    FROM Customers
);
Ten zapis jest niepoprawny, ponieważ wewnętrzne zapytanie zwraca dwie kolumny. Jeżeli chcesz porównywać kilka pól jednocześnie, składnia zależy od silnika bazy i zwykle wymaga porównania krotek albo użycia EXISTS.
Brak aliasów powoduje niejasność
Przy kilku tabelach łatwo pomylić kolumnę z zapytania zewnętrznego i wewnętrznego. Jawne aliasy, takie jak c, o i p, ograniczają ryzyko błędu oraz pomagają czytać zapytanie bez zgadywania, z której tabeli pochodzi dana wartość.
Przeczytaj również: T-SQL MERGE w praktyce - synchronizacja danych bez pułapek
NULL zmienia logikę warunku
SQL stosuje logikę trójwartościową, więc porównanie z NULL nie daje klasycznego TRUE ani FALSE. Przy konstrukcjach NOT IN jest to szczególnie zdradliwe. Jeżeli nie masz pełnej kontroli nad danymi, zwykle wybieram NOT EXISTS i jawne powiązanie tabel.
Podzapytanie czy JOIN i CTE
Nie ma jednej konstrukcji najlepszej w każdej sytuacji. Najrozsądniej zacząć od pytania, czy potrzebujesz listy wartości, sprawdzenia istnienia rekordu, pojedynczego obliczenia czy wieloetapowego przetwarzania danych.
| Potrzeba | Najczęściej pasujące rozwiązanie | Dlaczego |
|---|---|---|
| Porównanie z listą identyfikatorów | IN |
Czytelnie opisuje filtrowanie po zbiorze |
| Sprawdzenie powiązanego rekordu | EXISTS |
Nie pobiera danych, których nie potrzebujesz |
| Pobranie kolumn z dwóch tabel | JOIN |
Naturalnie łączy dane w jeden wynik |
| Kilka etapów obliczeń | CTE |
Porządkuje złożoną logikę |
| Jedna wartość pomocnicza | Podzapytanie skalarne | Krótki zapis bez dodatkowego łączenia tabel |
Wydajność zależy od silnika bazy, indeksów, liczby rekordów i planu wykonania. Dla tabel liczących miliony wierszy nie zgaduję, czy podzapytanie będzie szybkie. Sprawdzam plan wykonania i mierzę czas na danych zbliżonych do produkcyjnych, bo sama forma zapisu nie daje wiarygodnej odpowiedzi.
Warto też pamiętać, że SQL Server, PostgreSQL, MySQL i Oracle mają podobne podstawy, ale różnią się detalami optymalizacji oraz obsługi specyficznych konstrukcji. Przenośny przykład zwykle zadziała wszędzie, lecz przy kodzie produkcyjnym trzeba sprawdzić dokumentację używanego systemu.
Jak pisać zagnieżdżone zapytania, które da się utrzymać
Najpierw określam, jaki wynik ma dostarczyć zapytanie wewnętrzne. Jeżeli jest to jedna liczba, używam agregacji i pilnuję, aby wynik był skalarny. Jeżeli potrzebuję informacji o istnieniu, wybieram EXISTS, a jeżeli chcę pobrać kolumny z kilku źródeł, rozważam JOIN.
- Stosuj aliasy tabel, szczególnie w podzapytaniach skorelowanych.
- Unikaj SELECT *, gdy podzapytanie ma działać jako źródło danych dla dalszej logiki.
- Sprawdź, czy podzapytanie zwraca jedną kolumnę lub jedną wartość, zależnie od użytego operatora.
- Przetestuj zachowanie dla pustego wyniku i wartości NULL.
- Przy dużych tabelach sprawdź indeksy na kolumnach używanych w warunkach powiązania.
- Gdy zapytanie robi się wielopoziomowe, przenieś kolejne etapy do CTE albo rozważ widok.
Największą różnicę robi nie samo użycie zagnieżdżonego SELECT-a, lecz dopasowanie konstrukcji do celu. Dobrze napisane podzapytanie potrafi skrócić kod i jasno pokazać logikę biznesową, ale źle użyte może ukryć kosztowne operacje za pozornie niewinną składnią.
Od jednego SELECT-a do świadomego wyboru konstrukcji
Zagnieżdżone zapytania są naturalnym sposobem pracy z zależnościami między danymi. Pozwalają filtrować rekordy na podstawie innych tabel, obliczać wartości pomocnicze i budować tymczasowe zestawy bez kopiowania danych do aplikacji.
Najprostsza reguła wygląda tak: IN służy do porównania ze zbiorem, EXISTS do sprawdzenia obecności, a podzapytanie skalarne do pobrania jednej wartości. Gdy logika obejmuje wiele etapów, lepiej sięgnąć po CTE lub JOIN i sprawdzić plan wykonania. Taki sposób myślenia jest ważniejszy niż zapamiętanie pojedynczego szablonu składni.