Gdy aplikacja w C# zaczyna korzystać z większej liczby tabel, ręczne składanie zapytań SQL szybko staje się źródłem powtarzalnego kodu i trudnych do wykrycia błędów. ORM pomaga połączyć klasy, relacje i operacje biznesowe z bazą danych, ale nie zwalnia z rozumienia SQL. Pokażę, jak działa mapowanie obiektowo-relacyjne, kiedy wybrać EF Core albo Dappera, jak pisać wydajne zapytania oraz których pułapek unikać.
Najważniejsze decyzje przy wyborze ORM w C#
- EF Core sprawdzi się jako domyślny wybór w większości aplikacji .NET.
- Dapper daje większą kontrolę nad SQL-em i niewielki narzut wykonania.
- AsNoTracking() ma sens przy odczytach, których nie będziemy zapisywać.
- Projekcja do DTO ogranicza liczbę kolumn i ilość danych przesyłanych z bazy.
- ORM nie zastępuje znajomości indeksów, planów zapytań i transakcji.
Na czym polega ORM w aplikacji C#
ORM, czyli Object-Relational Mapping, tłumaczy obiekty aplikacji na rekordy relacyjnej bazy danych. Klasa Product może odpowiadać tabeli Products, jej właściwość Name kolumnie, a kolekcja zamówień relacji jeden do wielu. Dzięki temu programista pracuje głównie z kodem C#, a framework generuje znaczną część SQL-a.
To wygodne, ale nie jest magią. ORM musi rozstrzygnąć, jak odwzorować typy, klucze główne, wartości null, relacje i moment zapisu zmian. Im bardziej model obiektowy różni się od schematu bazy, tym większą rolę odgrywa konfiguracja mapowania.
Co zyskujemy
- mniej powtarzalnego kodu ADO.NET,
- silne typowanie zapytań dzięki LINQ,
- automatyczne mapowanie wyników na obiekty,
- obsługę relacji i śledzenia zmian,
- migracje pozwalające wersjonować schemat bazy.
W praktyce największą korzyścią jest spójność kodu dostępu do danych. Zamiast ręcznie otwierać połączenie, tworzyć komendę, dodawać parametry i mapować każdą kolumnę, opisujemy operację na poziomie modelu aplikacji.
Gdzie pojawia się koszt
Warstwa abstrakcji może generować zapytania, których nie napisano by ręcznie. Problemem bywają też niejawne operacje, na przykład automatyczne dociąganie powiązanych danych albo pobieranie całych encji, gdy potrzebne są tylko dwie kolumny.
Dlatego moje podejście jest proste: ORM powinien ułatwiać pracę, ale SQL nadal trzeba umieć czytać. Gdy zapytanie działa wolno, sprawdzam wygenerowany SQL i plan wykonania zamiast zgadywać, który fragment C# jest winny.
Dlaczego EF Core jest najczęstszym wyborem
Entity Framework Core jest obecnie najbardziej naturalnym wyborem dla aplikacji budowanych w ekosystemie .NET. Jest wieloplatformowy, open source, współpracuje z popularnymi silnikami baz danych i integruje się z ASP.NET Core przez wstrzykiwanie zależności.
Centralnym elementem jest DbContext. Reprezentuje sesję pracy z bazą, udostępnia zbiory encji przez DbSet i pilnuje zmian, które mają zostać zapisane.
public sealed class Product
{
    public int Id { get; set; }
    public string Name { get; set; } = string.Empty;
    public decimal Price { get; set; }
    public bool IsActive { get; set; }
}

public sealed class ShopDbContext : DbContext
{
    public DbSet Products => Set();

    public ShopDbContext(DbContextOptions options)
        : base(options)
    {
    }
}
Proste pobranie danych może wyglądać tak:
var products = await db.Products
    .Where(p => p.IsActive)
    .OrderBy(p => p.Name)
    .ToListAsync();
Wyrażenie LINQ nie wykonuje się od razu. Do momentu wywołania metody kończącej zapytanie, takiej jak ToListAsync(), budowane jest wyrażenie, które provider próbuje przetłumaczyć na SQL. To ważne, ponieważ nie każda metoda C# ma odpowiednik możliwy do wykonania po stronie bazy.
Konfiguracja modelu
Mapowanie można opierać na konwencjach, atrybutach albo Fluent API. Przy małym projekcie konwencje często wystarczają. W większej aplikacji preferuję Fluent API, bo konfiguracja relacji, indeksów i ograniczeń pozostaje w jednym, łatwiejszym do testowania miejscu.
protected override void OnModelCreating(ModelBuilder modelBuilder)
{
    modelBuilder.Entity(entity =>
    {
        entity.Property(p => p.Name)
            .HasMaxLength(200)
            .IsRequired();

        entity.Property(p => p.Price)
            .HasPrecision(18, 2);

        entity.HasIndex(p => new { p.IsActive, p.Name });
    });
}
EF Core obsługuje też migracje, czyli kolejne wersje zmian schematu bazy. To wygodne w zespołach, ale migracje powinny przechodzić przez kontrolę kodu i być testowane na kopii danych. Migracja nie zastępuje strategii wdrożenia, szczególnie gdy zmiana tabeli dotyczy milionów rekordów.
EF Core, Dapper czy NHibernate
Nie ma jednego ORM odpowiedniego dla każdej aplikacji. Najlepszy wybór zależy od tego, czy ważniejsza jest szybkość tworzenia funkcji, kontrola nad SQL-em, rozbudowane mapowanie czy możliwie mała liczba abstrakcji.
| Narzędzie | Najmocniejsza strona | Dobre zastosowanie | Ograniczenie |
|---|---|---|---|
| EF Core | Pełny ORM, LINQ, migracje i śledzenie zmian | API, aplikacje biznesowe, typowe systemy CRUD | Trzeba kontrolować generowany SQL i sposób ładowania relacji |
| Dapper | Bezpośrednia kontrola nad zapytaniami SQL | Raporty, odczyty, procedury i wymagające zapytania | Więcej ręcznego kodu i brak pełnego change trackera |
| NHibernate | Rozbudowane mapowanie i dojrzały model sesji | Duże systemy z istniejącym modelem domenowym | Wyższy próg wejścia i mniej typowa ścieżka w nowych projektach .NET |
Dapper jest mikro-ORM-em, który upraszcza pracę z ADO.NET, ale pozostawia SQL w rękach programisty. Przykład jest krótki i czytelny:
const string sql = """
    SELECT Id, Name, Price
    FROM Products
    WHERE IsActive = @IsActive
    ORDER BY Name
    """;

var products = await connection.QueryAsync(
    sql,
    new { IsActive = true });
W tym podejściu zapytanie jest jawne, a parametry chronią przed typowym SQL injection. Dapper nie śledzi zmian encji i nie zarządza relacjami tak jak EF Core, więc dobrze pasuje do miejsc, w których chcemy dokładnie kontrolować wynik i koszt zapytania.
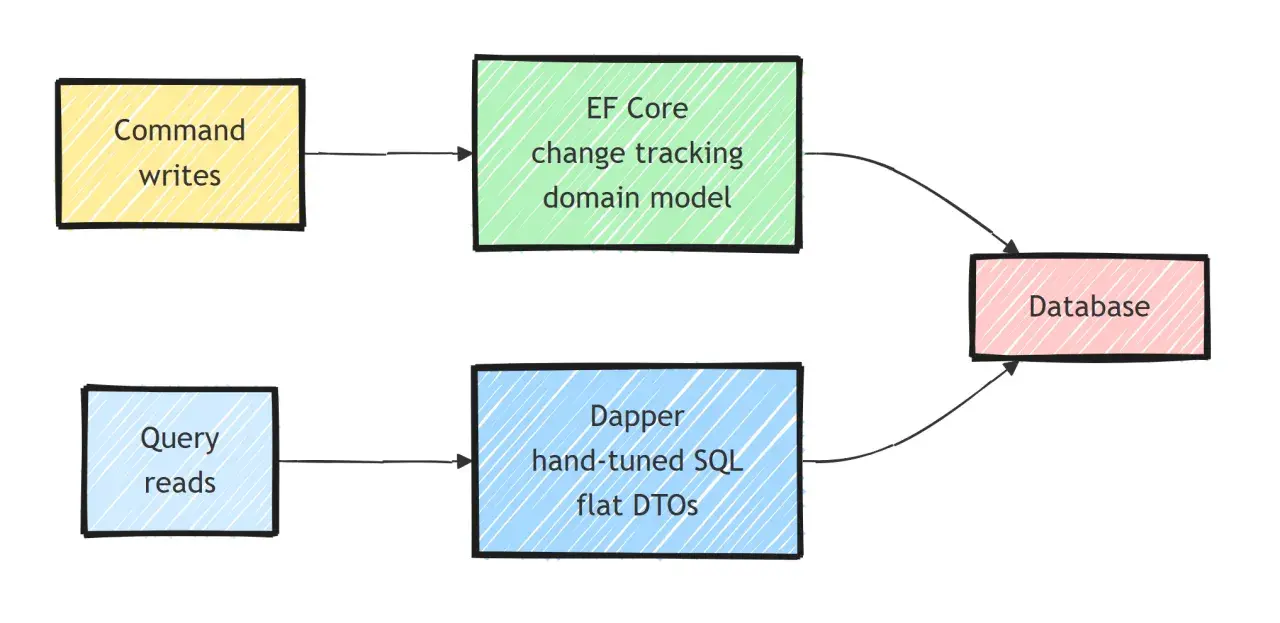
W wielu systemach rozsądny jest model mieszany. EF Core obsługuje standardowe operacje domenowe, a Dapper dostarcza kilka wyspecjalizowanych zapytań raportowych. Nie widzę sensu wymieniać całego ORM tylko dlatego, że jeden raport wymaga ręcznie napisanego SQL-a.
Jak pisać wydajne zapytania w EF Core
Najczęstszy problem nie wynika z samego ORM, lecz z tego, że aplikacja pobiera za dużo danych. Tabela z kilkuset tysiącami wierszy może działać dobrze w testach, a potem spowolnić endpoint produkcyjny, gdy ktoś usunie filtr albo zwróci pełną listę bez paginacji.
Pobieraj tylko potrzebne kolumny
Jeśli ekran wyświetla nazwę i cenę, nie ma powodu ładować całej encji z opisem, datami, metadanymi i relacjami. Projekcja do DTO ogranicza transfer danych oraz ilość obiektów tworzonych w pamięci.
var result = await db.Products
    .Where(p => p.IsActive)
    .Select(p => new ProductListItem(
        p.Id,
        p.Name,
        p.Price))
    .OrderBy(p => p.Name)
    .Take(50)
    .ToListAsync();
To zwykle daje większy efekt niż mechaniczne dodawanie kolejnych warstw cache. Najtańszy rekord to ten, którego nie trzeba pobrać.
Wyłącz śledzenie przy odczytach
EF Core domyślnie śledzi encje, aby wykryć ich zmiany przy SaveChangesAsync(). Dla list referencyjnych, raportów i widoków tylko do odczytu ten mechanizm często nie jest potrzebny.
var categories = await db.Categories
    .AsNoTracking()
    .OrderBy(c => c.Name)
    .ToListAsync();
AsNoTracking() może zmniejszyć narzut pamięci i czas materializacji, ale nie jest uniwersalnym przyspieszaczem. Jeśli w ramach jednego kontekstu wielokrotnie pracujemy z tymi samymi encjami albo chcemy je później zmienić, śledzenie może być wygodniejsze i czasem bardziej efektywne.
Kontroluj relacje i problem N+1
Problem N+1 pojawia się wtedy, gdy aplikacja wykonuje jedno zapytanie po listę główną, a potem osobne zapytanie dla każdego elementu. Przy 100 zamówieniach może to oznaczać 101 wywołań bazy zamiast jednego dobrze zaprojektowanego zapytania.
Jawne Include() może pomóc, ale nie powinno być dodawane bez zastanowienia. Przy kilku relacjach jeden do wielu wynik może zawierać wiele powtórzonych danych. W takich przypadkach przydaje się projekcja do DTO albo AsSplitQuery(), które rozdziela pobieranie relacji na osobne zapytania.
var orders = await db.Orders
    .Where(o => o.CustomerId == customerId)
    .Select(o => new OrderSummary(
        o.Id,
        o.CreatedAt,
        o.Items.Sum(i => i.Quantity * i.UnitPrice)))
    .ToListAsync();
Ten zapis jest często lepszy niż pobranie całego grafu obiektów i liczenie sum w C#. Baza danych została stworzona do filtrowania, grupowania i agregowania, więc warto pozwolić jej wykonać tę pracę.
Indeksy i paginacja mają większe znaczenie niż drobne optymalizacje
Indeks powinien odpowiadać realnym filtrom i sortowaniu. Jeżeli użytkownicy często filtrują produkty po IsActive i sortują po Name, taki scenariusz warto sprawdzić w planie wykonania, a nie tylko w kodzie encji.
Unikaj również Skip() na bardzo odległych stronach dużych tabel, ponieważ baza może najpierw odczytać i odrzucić wiele wcześniejszych rekordów. Przy dużych zbiorach lepsza bywa paginacja keyset, oparta na ostatnim znanym identyfikatorze lub dacie.
Transakcje, SQL i granice abstrakcji
ORM upraszcza dostęp do danych, ale nie usuwa potrzeby projektowania transakcji. Jeżeli operacja tworzy zamówienie, rezerwuje stan magazynowy i zapisuje płatność, trzeba jasno określić, które zmiany muszą zostać zatwierdzone razem.
await using var transaction = await db.Database.BeginTransactionAsync();

try
{
    db.Orders.Add(order);
    await db.SaveChangesAsync();

    stock.Reserve(order);
    await db.SaveChangesAsync();

    await transaction.CommitAsync();
}
catch
{
    await transaction.RollbackAsync();
    throw;
}
W prostych przypadkach pojedyncze SaveChangesAsync() samo korzysta z transakcji, ale przy kilku zapisach lub współpracy z innymi zasobami potrzebna jest świadoma decyzja. Nie warto też trzymać transakcji otwartej podczas wywołania zewnętrznego API, bo blokady mogą utrzymywać się znacznie dłużej, niż zakładamy.
Przeczytaj również: CONVERT w SQL Server - daty, TRY_CONVERT i wydajność
Kiedy użyć ręcznego SQL-a
Ręczny SQL ma sens przy skomplikowanych raportach, zapytaniach korzystających ze specyficznych funkcji silnika bazy oraz miejscach, gdzie profilowanie pokazało problem z wygenerowanym zapytaniem. Nie powinien być jednak pierwszą reakcją na każdy wolniejszy endpoint.
Przed przejściem na SQL sprawdzam kolejno projekcję, indeksy, liczbę zwracanych rekordów, sposób ładowania relacji i plan wykonania. Dopiero potem oceniam, czy ręcznie napisane zapytanie rzeczywiście rozwiązuje problem. Raw SQL daje kontrolę, ale zwiększa koszt utrzymania i może mocniej związać aplikację z konkretnym silnikiem bazy.
Błędy, które najczęściej psują projekty z ORM
- Jeden DbContext na całe życie aplikacji. Kontekst powinien mieć ograniczony czas życia, zwykle związany z żądaniem HTTP albo konkretną operacją.
- Brak limitu wyników. Endpoint zwracający całą tabelę prędzej czy później stanie się problemem.
- Wykonywanie zapytania w pętli. Najpierw sprawdź, czy da się użyć projekcji, złączenia albo pojedynczego zapytania zbiorczego.
- Bezrefleksyjne Include(). Duży graf encji może oznaczać ciężki SQL i powielone dane.
- Brak obserwowalności. Loguj czas zapytań i analizuj SQL, który rzeczywiście trafił do bazy.
- Traktowanie migracji jak zwykłego wdrożenia kodu. Zmiany schematu mogą wymagać etapowego wdrożenia i migracji kompatybilnej wstecz.
- Przenoszenie całej logiki do zapytań. SQL powinien efektywnie pobierać dane, ale reguły biznesowe nie powinny znikać w trudnych do testowania konstrukcjach.
W projektach produkcyjnych szczególnie pilnuję rozdzielenia modeli. Encja bazy danych, model domenowy i DTO odpowiedzi API nie zawsze powinny być tą samą klasą. Taki podział ogranicza przypadkowe ujawnianie kolumn i pozwala zmieniać schemat bez łamania kontraktu API.
Przy wyborze narzędzia zaczynam od charakteru systemu. Dla typowego API biznesowego wybrałbym EF Core, dla kilku precyzyjnych raportów dołożyłbym Dappera, a przy rozbudowanym istniejącym modelu sprawdziłbym, czy NHibernate nie ma już gotowych rozwiązań pasujących do architektury.
Dobry ORM zaczyna się od dobrego modelu danych
ORM nie naprawi źle zaprojektowanych tabel, brakujących indeksów ani niejasnych granic transakcji. Najlepsze rezultaty daje połączenie wygodnego mapowania z podstawową dyscypliną SQL: ograniczaniem wyników, analizą planów, świadomym ładowaniem relacji i pomiarem zamiast domysłów.
Jeśli dopiero zaczynasz, zacznij od EF Core, poznaj DbContext, migracje, projekcje i AsNoTracking(), a potem sprawdź wygenerowany SQL dla kilku rzeczywistych przypadków. Taka kolejność pozwala korzystać z produktywności ORM bez utraty kontroli nad tym, co naprawdę dzieje się w bazie.