Gdy dane są rozłożone na kilka tabel, samo pobranie rekordów rzadko wystarcza. Trzeba jeszcze określić, które wiersze opisują ten sam obiekt, a za to odpowiada warunek ON w konstrukcji JOIN, często określanej skrótowo jako join on. Pokażę, jak budować takie zapytania, czym różni się ON od WHERE, jak działają rodzaje złączeń oraz skąd biorą się duplikaty i nieoczekiwane wyniki.
Warunek ON decyduje, które rekordy zostaną połączone
-
JOIN ... ONopisuje relację między tabelami. - Najczęściej łączy się klucz główny z odpowiadającym mu kluczem obcym.
-
LEFT JOINzachowuje wszystkie rekordy z lewej tabeli, nawet bez dopasowania. - Przeniesienie warunku z
ONdoWHEREmoże zmienić wynik złączenia zewnętrznego. - Duplikaty zwykle wynikają z relacji jeden do wielu, a nie z błędu samego SQL.
Jak działa warunek ON w SQL
Najprostszy przykład łączenia tabel wygląda tak:
SELECT
    o.id,
    o.order_date,
    c.name
FROM orders AS o
JOIN customers AS c
    ON c.id = o.customer_id;
Warunek ON c.id = o.customer_id mówi silnikowi, że rekord zamówienia należy połączyć z klientem o odpowiadającym identyfikatorze. Nie filtruję tutaj jeszcze zamówień po dacie ani wartości. Określam wyłącznie, w jaki sposób dwa źródła danych są ze sobą powiązane.
Alias, taki jak o lub c, nie jest obowiązkowy, ale bardzo poprawia czytelność. Szczególnie przy kilku tabelach zawsze kwalifikuję kolumny nazwą tabeli lub aliasem, ponieważ zapis id = id może być niejednoznaczny albo prowadzić do pomyłki.
Co musi znajdować się w warunku
Wyrażenie po ON musi zwracać wartość logiczną, czyli określać, czy dana para wierszy spełnia warunek dopasowania. Najczęściej jest to porównanie równości, ale SQL pozwala także na bardziej złożone reguły.
ON p.category_id = c.id
AND p.is_active = 1
W tym przypadku produkt jest łączony z kategorią tylko wtedy, gdy identyfikator kategorii pasuje, a produkt jest aktywny. Taki dodatkowy warunek ma znaczenie zwłaszcza przy złączeniach zewnętrznych, gdzie miejsce jego użycia wpływa na to, czy rekord bez dopasowania pozostanie w wyniku.
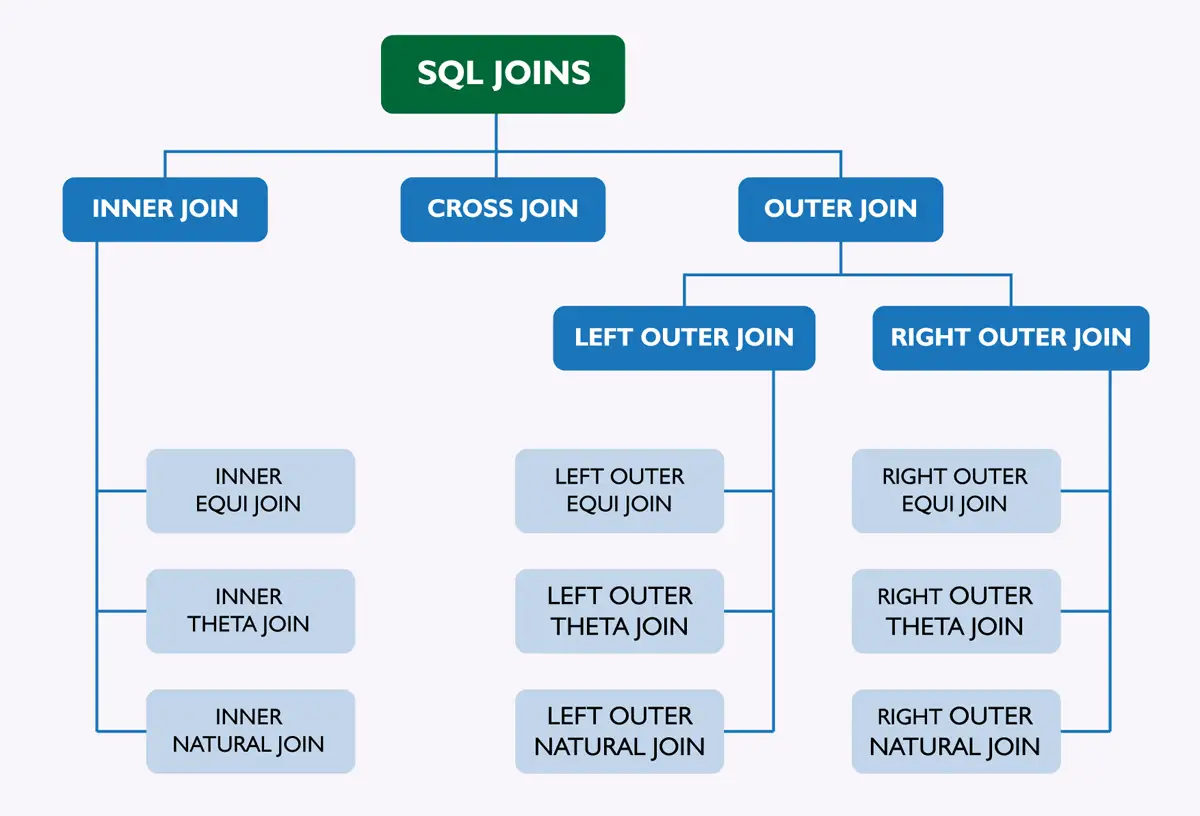
INNER JOIN, LEFT JOIN i pozostałe warianty
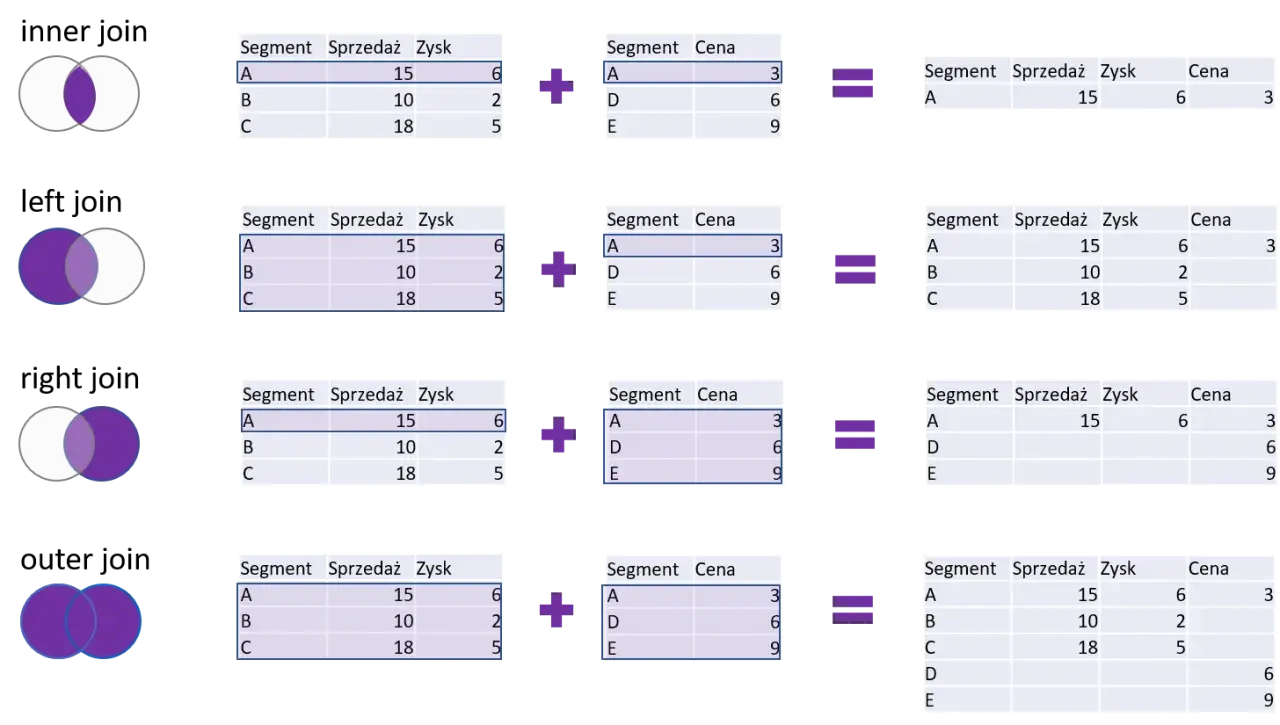
Samo słowo JOIN zwykle oznacza INNER JOIN. Zwraca ono wyłącznie te wiersze, dla których warunek po obu stronach został spełniony.
SELECT c.name, o.id
FROM customers AS c
INNER JOIN orders AS o
    ON o.customer_id = c.id;
Klient bez zamówień nie pojawi się w takim wyniku. To dobre rozwiązanie, gdy interesują mnie wyłącznie rekordy posiadające powiązanie, na przykład lista zamówień wraz z danymi klientów.
LEFT JOIN działa inaczej. Zachowuje wszystkie rekordy z lewej tabeli, a gdy nie znajdzie dopasowania po prawej stronie, wstawia wartości NULL.
SELECT
    c.name,
    o.id AS order_id
FROM customers AS c
LEFT JOIN orders AS o
    ON o.customer_id = c.id;
To zapytanie pokaże także klientów, którzy nigdy niczego nie zamówili. Mogę wykorzystać ten fakt do znalezienia takich osób:
SELECT c.id, c.name
FROM customers AS c
LEFT JOIN orders AS o
    ON o.customer_id = c.id
WHERE o.id IS NULL;
RIGHT JOIN zachowuje wszystkie rekordy z prawej tabeli, ale w praktyce często zamieniam kolejność tabel i używam LEFT JOIN. FULL OUTER JOIN zachowuje rekordy z obu stron, również te bez dopasowania. Dostępność tego wariantu zależy od konkretnego systemu bazodanowego, dlatego przed użyciem sprawdzam dokumentację danego silnika.
| Rodzaj złączenia | Co zachowuje | Typowe zastosowanie |
|---|---|---|
INNER JOIN |
Tylko dopasowane rekordy | Raporty dotyczące istniejących relacji |
LEFT JOIN |
Wszystkie rekordy z lewej tabeli | Wyszukiwanie brakujących powiązań |
RIGHT JOIN |
Wszystkie rekordy z prawej tabeli | Rzadziej używane odpowiedniki LEFT JOIN
|
FULL OUTER JOIN |
Rekordy z obu tabel | Porównywanie dwóch zbiorów danych |
ON a WHERE przy złączeniach zewnętrznych
Najczęstszy błąd polega na założeniu, że warunek w ON i identyczny warunek w WHERE zawsze dają ten sam rezultat. Przy INNER JOIN różnica często nie jest widoczna, ale przy LEFT JOIN może całkowicie zmienić sens zapytania.
Załóżmy, że chcę wyświetlić wszystkich klientów oraz ich zamówienia z 2026 roku. Warunek daty umieszczony w ON zachowa także klientów bez takiego zamówienia:
SELECT c.name, o.id, o.order_date
FROM customers AS c
LEFT JOIN orders AS o
    ON o.customer_id = c.id
   AND o.order_date >= '2026-01-01';
Jeśli tę samą datę przeniosę do WHERE, rekordy z NULL zostaną odrzucone:
SELECT c.name, o.id, o.order_date
FROM customers AS c
LEFT JOIN orders AS o
    ON o.customer_id = c.id
WHERE o.order_date >= '2026-01-01';
Drugie zapytanie zachowuje się praktycznie jak INNER JOIN, ponieważ klient bez zamówienia ma w kolumnie daty wartość NULL, a warunek w WHERE nie jest dla niego spełniony. Moją prostą zasadą jest taka: ON opisuje, co ma zostać dopasowane, a WHERE określa, co ma zostać pokazane po wykonaniu złączenia.
Łączenie po wielu warunkach i innych operatorach
Nie każda relacja opiera się na jednej kolumnie. Przy kluczach złożonych trzeba porównać wszystkie części klucza, inaczej można połączyć rekordy należące do różnych okresów, oddziałów albo wersji danych.
SELECT s.employee_id, s.work_date, e.name
FROM schedules AS s
JOIN employees AS e
    ON e.employee_id = s.employee_id
   AND e.branch_id = s.branch_id;
Warunek może również używać operatorów innych niż =. Przykładem jest złączenie przedziałowe, przydatne przy przypisywaniu ceny lub stawki obowiązującej w określonym czasie:
SELECT o.id, r.rate
FROM orders AS o
JOIN tax_rates AS r
    ON o.order_date >= r.valid_from
   AND o.order_date < r.valid_to;
Spotykam też złączenia oparte na przedziałach liczbowych, na przykład przypisanie klienta do segmentu wydatków. Trzeba jednak zachować ostrożność, bo jeden rekord może pasować do kilku przedziałów i wtedy wynik zawiera więcej wierszy, niż oczekujemy.
Przeczytaj również: PARTITION BY w SQL - składnia, przykłady i różnice względem GROUP BY
Relacja jeden do wielu i pozorne duplikaty
Jeżeli jeden klient ma pięć zamówień, połączenie tabel zwróci pięć wierszy tego klienta. To nie jest duplikat w sensie logicznym, tylko poprawny wynik relacji jeden do wielu.
SELECT c.name, o.id
FROM customers AS c
JOIN orders AS o
    ON o.customer_id = c.id;
Gdy potrzebuję jednego wiersza na klienta, agreguję dane zamiast usuwać rekordy przez przypadkowe DISTINCT:
SELECT
    c.id,
    c.name,
    COUNT(o.id) AS order_count
FROM customers AS c
LEFT JOIN orders AS o
    ON o.customer_id = c.id
GROUP BY c.id, c.name;COUNT(o.id), a nie COUNT(*), pozwala poprawnie otrzymać zero dla klienta bez zamówień. To drobny szczegół, który często decyduje o poprawności raportu.
Najczęstsze błędy przy JOIN ... ON
Najgroźniejszy błąd to pominięcie właściwego warunku łączenia. Jeśli połączę tabele bez ograniczenia, mogę uzyskać iloczyn kartezjański, czyli każdą kombinację wiersza z pierwszej tabeli z każdym wierszem z drugiej.
SELECT c.name, o.id
FROM customers AS c
CROSS JOIN orders AS o;
Przy 10 000 klientów i 50 000 zamówień taki wynik może teoretycznie zawierać nawet 500 milionów kombinacji. CROSS JOIN ma legalne zastosowania, ale przypadkowe uzyskanie takiego efektu zwykle oznacza brak warunku albo pomyłkę w aliasie.
Drugim problemem jest łączenie kolumn o niezgodnych typach lub różnych znaczeniach. Identyfikator klienta nie powinien być porównywany z numerem zamówienia tylko dlatego, że obie kolumny są liczbami. Sprawdzam także, czy po obu stronach relacji występują wartości NULL, ponieważ porównanie NULL = NULL nie zwraca wartości prawda.
- Używaj jednoznacznych aliasów tabel.
- Sprawdź, czy łączysz klucz główny z właściwym kluczem obcym.
- Policz oczekiwaną liczbę rekordów przed i po złączeniu.
- Nie dodawaj
DISTINCT, dopóki nie ustalisz źródła powtórzeń. - Przy
LEFT JOINświadomie wybieraj miejsce dla filtrów.
W praktyce zaczynam od małego zapytania, wybieram tylko identyfikatory i dopiero po sprawdzeniu relacji dodaję kolejne kolumny. Taka metoda szybciej ujawnia błędne dopasowanie niż rozbudowany raport z kilkunastoma tabelami.
Wydajność i czytelność zapytań
Sam zapis JOIN ... ON nie gwarantuje dobrego czasu wykonania. Duże znaczenie ma indeks na kolumnie używanej do łączenia, zwłaszcza po stronie klucza obcego. W tabelach zawierających miliony rekordów brak odpowiedniego indeksu może oznaczać odczyt dużej części danych zamiast szybkiego wyszukania dopasowania.
Nie zakładam jednak, że każdy indeks automatycznie rozwiąże problem. Sprawdzam plan wykonania zapytania i zwracam uwagę na selektywność warunku, liczbę przetwarzanych wierszy oraz to, czy filtr jest stosowany odpowiednio wcześnie.
SELECT
    o.id,
    c.name
FROM orders AS o
JOIN customers AS c
    ON c.id = o.customer_id
WHERE o.status = 'paid';
W tym przykładzie indeks na orders.customer_id wspiera złączenie, a indeks związany ze statusem może pomóc w filtrowaniu. Ostateczny efekt zależy od rozmiaru tabel, rozkładu wartości i konkretnego silnika bazy, dlatego plan wykonania jest bardziej wiarygodny niż ogólna reguła.
Gdy kolumny mają tę samą nazwę, nie muszę pisać długiego warunku. Niektóre systemy obsługują skróconą składnię USING:
SELECT c.name, o.id
FROM customers AS c
JOIN orders AS o
USING (customer_id);
Używam jej tylko wtedy, gdy kolumny rzeczywiście mają identyczną nazwę i znaczenie. W kodzie współdzielonym przez kilka zespołów jawne ON c.id = o.customer_id bywa czytelniejsze, a także lepiej pokazuje, które pola tworzą relację.
Jak szybko sprawdzić, czy złączenie jest poprawne
Najpierw ustalam, jaki wynik ma reprezentować jeden wiersz. Jeśli ma to być jedno zamówienie, identyfikator zamówienia powinien pozostać unikalny. Jeśli po dodaniu tabeli produktów liczba wierszy rośnie, prawdopodobnie wszedłem w relację jeden do wielu i muszę zdecydować, czy chcę szczegóły, czy agregat.
- Uruchom zapytanie tylko z identyfikatorami obu tabel.
- Sprawdź kilka rekordów, dla których relacja powinna istnieć.
- Sprawdź przypadek bez dopasowania, szczególnie przy
LEFT JOIN. - Porównaj liczbę wierszy z oczekiwaną kardynalnością relacji.
- Dopiero potem dodaj filtry, agregacje i kolumny opisowe.
Przydatny jest także test kontrolny z COUNT:
SELECT
    COUNT(*) AS rows_after_join,
    COUNT(DISTINCT o.id) AS unique_orders
FROM orders AS o
JOIN customers AS c
    ON c.id = o.customer_id;
Jeżeli liczba wierszy po złączeniu wyraźnie przewyższa liczbę unikalnych zamówień, trzeba sprawdzić, czy tabela po prawej stronie nie zawiera kilku pasujących rekordów. Najczęściej oznacza to brak unikalności danych, zbyt szeroki warunek albo niepełne połączenie po kluczu złożonym.
Dobry warunek łączenia zaczyna się od modelu danych
JOIN ... ON jest prostą składnią, ale jego poprawność zależy od tego, czy rozumiem relacje zapisane w bazie. Najpierw identyfikuję klucze, kardynalność i oczekiwany poziom szczegółowości wyniku, a dopiero później wybieram typ złączenia i dodatkowe warunki.
Jeśli zapamiętasz jedną zasadę, niech będzie nią ta: ON określa relację, a WHERE filtruje rezultat. Rozdzielenie tych dwóch odpowiedzialności chroni przed utratą rekordów w LEFT JOIN, przypadkowymi multiplikacjami i raportami, które wyglądają wiarygodnie, ale pokazują niepoprawne dane.