Co dzieje się z pieniędzmi, zamówieniem albo stanem magazynu, gdy druga operacja nie powiedzie się w połowie pracy? Transakcje bazy danych rozwiązują ten problem, łącząc kilka poleceń SQL w jedną logiczną całość. Pokażę, jak działają właściwości ACID, kiedy używać COMMIT i ROLLBACK, jak dobierać poziom izolacji oraz na co uważać w aplikacjach .NET i Azure.
Najważniejsze zasady bezpiecznej pracy z transakcjami
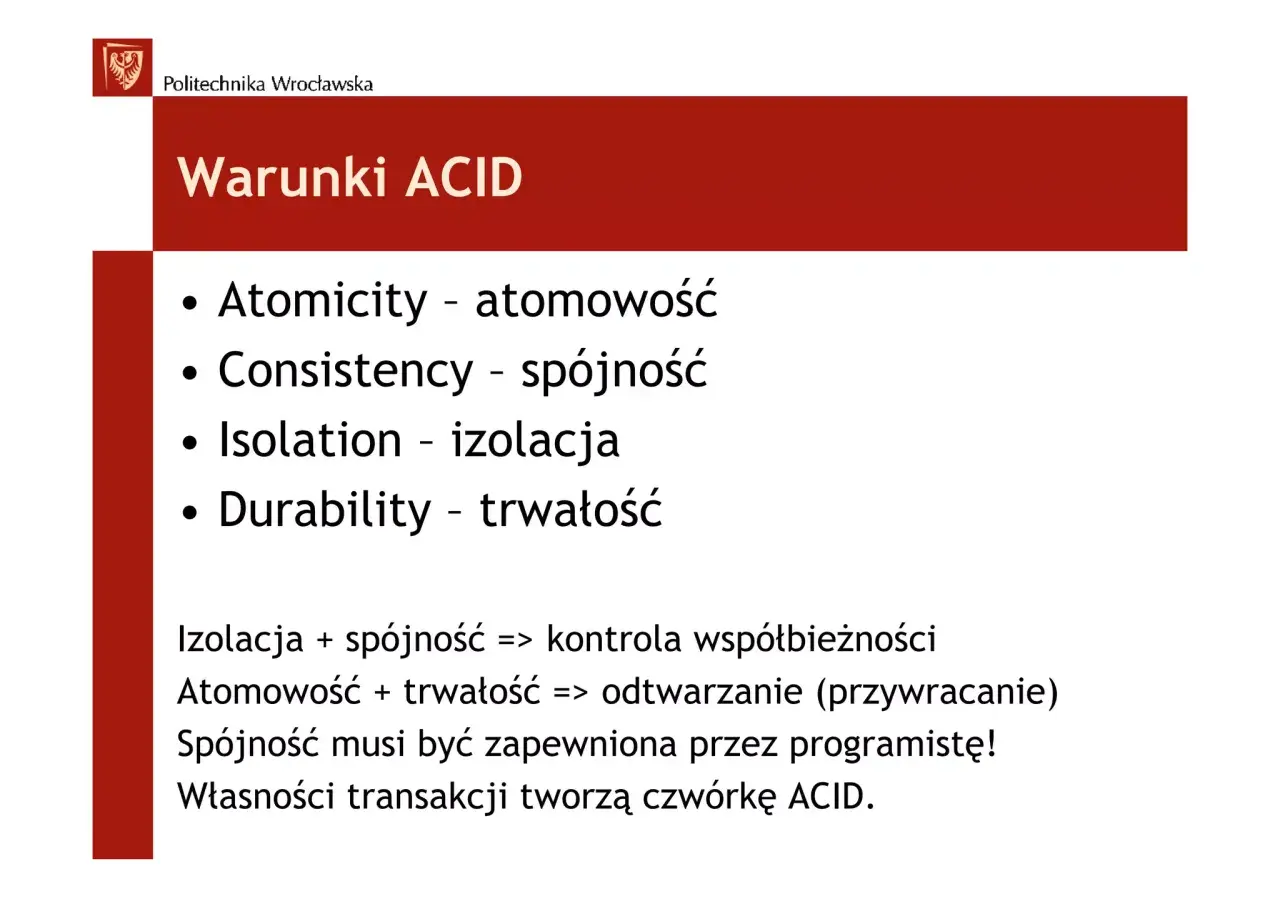
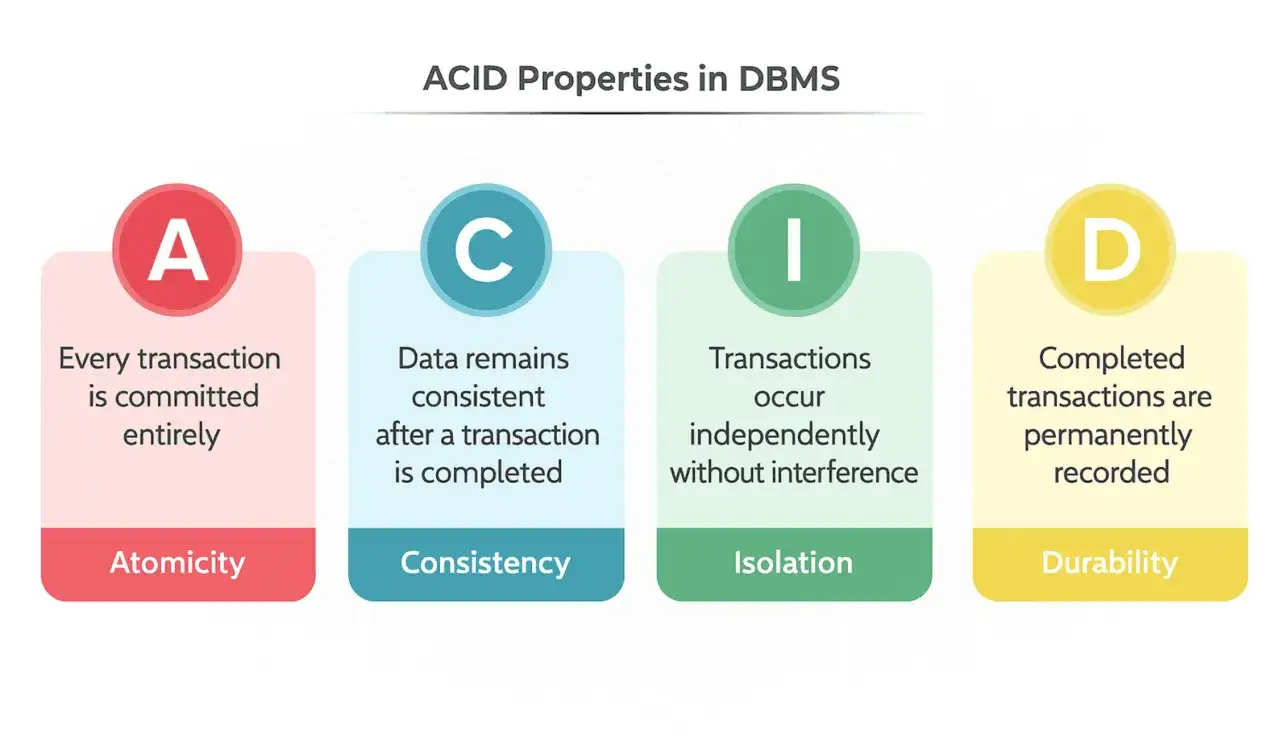
- ACID chroni atomowość, spójność, izolację i trwałość zmian.
- COMMIT zatwierdza całość, a ROLLBACK wycofuje niezapisane operacje.
- Transakcja powinna obejmować tylko operacje, które muszą zakończyć się razem.
- Poziom izolacji wpływa na blokady, widoczność danych i ryzyko odczytu nieaktualnych wartości.
- W aplikacji trzeba obsłużyć błędy, ponowienia oraz sytuację, w której baza pozostaje w stanie niezatwierdzonej transakcji.
Po co właściwie używa się transakcji
Wyobraźmy sobie przelew między dwoma kontami. System powinien zmniejszyć saldo jednego konta i zwiększyć saldo drugiego. Jeśli pierwsze polecenie się powiedzie, a drugie zakończy błędem, baza pozostanie w stanie, którego nie da się zaakceptować. Transakcja sprawia, że oba zapisy zostaną wykonane razem albo oba zostaną anulowane.
To samo dotyczy złożenia zamówienia. Zapis nagłówka zamówienia, pozycji, płatności i zmniejszenie stanu magazynowego często tworzą jedną jednostkę biznesową. Nie każda operacja musi należeć do tej samej transakcji, ale jeśli częściowy wynik byłby błędem, powinny zostać objęte wspólnym zakresem.
ACID w praktyce
| Właściwość | Znaczenie | Przykład |
|---|---|---|
| Atomicity | Atomowość, czyli wszystko albo nic | Nie można zapisać płatności bez powiązanego zamówienia. |
| Consistency | Spójność danych po zakończeniu operacji | Klucz obcy i ograniczenie unikalności nadal są respektowane. |
| Isolation | Odseparowanie równoległych operacji | Drugi proces nie powinien odczytać połowy przelewu. |
| Durability | Trwałość zatwierdzonych zmian | Po poprawnym zatwierdzeniu dane nie powinny zniknąć po restarcie serwera. |
ACID nie oznacza, że aplikacja automatycznie rozwiąże każdy problem. Baza może zagwarantować spójność własnych danych, ale nie cofnie wysłanego e-maila, żądania do zewnętrznego API ani pliku zapisanego na dysku. To jedna z granic, o których początkujący często dowiadują się dopiero po wdrożeniu.
Jak wygląda cykl transakcji w SQL
Najprostszy schemat składa się z rozpoczęcia pracy, wykonania poleceń i zakończenia przez zatwierdzenie albo wycofanie. W SQL Server używa się zwykle poleceń BEGIN TRANSACTION, COMMIT TRANSACTION i ROLLBACK TRANSACTION.
BEGIN TRANSACTION;

UPDATE Konta
SET Saldo = Saldo - 100
WHERE Id = 1;

UPDATE Konta
SET Saldo = Saldo + 100
WHERE Id = 2;

COMMIT TRANSACTION;
Jeżeli dowolne polecenie zgłosi błąd, aplikacja powinna wykonać wycofanie. W przeciwnym razie połączenie może nadal utrzymywać blokady, a kolejne zapytania będą pracować w nieoczekiwanym stanie.
BEGIN TRY
    BEGIN TRANSACTION;

    UPDATE Konta
    SET Saldo = Saldo - 100
    WHERE Id = 1;

    UPDATE Konta
    SET Saldo = Saldo + 100
    WHERE Id = 2;

    COMMIT TRANSACTION;
END TRY
BEGIN CATCH
    IF XACT_STATE() <> 0
        ROLLBACK TRANSACTION;

    THROW;
END CATCH;
Włączenie SET XACT_ABORT ON jest w SQL Server często rozsądnym zabezpieczeniem, ponieważ część błędów automatycznie kończy wtedy transakcję. Nie zastępuje to jednak obsługi wyjątków. Najważniejsza zasada brzmi: każda ścieżka wykonania musi kończyć się świadomym COMMIT-em albo ROLLBACK-iem.
Autocommit i jawny zakres
W trybie autocommit pojedyncze polecenie jest traktowane jako osobna transakcja. To wygodne przy prostym SELECT albo pojedynczym UPDATE, ale nie wystarcza, gdy kilka instrukcji musi zachować wspólną spójność.
W aplikacjach .NET jawny zakres można otworzyć przez DbTransaction, SqlTransaction albo mechanizmy używane przez Entity Framework Core. Samo wywołanie kilku metod repozytorium nie tworzy jeszcze jednej transakcji. Granica musi być ustawiona na poziomie jednostki pracy, a nie przypadkowo wewnątrz pojedynczego zapytania.
Poziomy izolacji decydują o zachowaniu równoległych operacji
Gdy kilka żądań działa jednocześnie, pojawia się pytanie, co jedno z nich może zobaczyć z pracy drugiego. Poziom izolacji określa między innymi, czy odczyt może czekać na blokadę, zobaczyć niezatwierdzone dane albo ponownie odczytać ten sam rekord z inną wartością.
| Poziom | Co dopuszcza | Kiedy uważać |
|---|---|---|
READ UNCOMMITTED |
Możliwy odczyt zmian, których inna transakcja jeszcze nie zatwierdziła. | Praktycznie nie nadaje się do danych finansowych ani biznesowych. |
READ COMMITTED |
Nie pokazuje niezatwierdzonych zmian, ale kolejny odczyt może zwrócić inną wartość. | To częsty poziom domyślny, lecz nie zawsze wystarcza dla złożonych procesów. |
REPEATABLE READ |
Chroni wcześniej odczytane wiersze przed zmianą w czasie transakcji. | Może zwiększyć liczbę blokad i nadal dopuszczać nowe wiersze spełniające warunek. |
SERIALIZABLE |
Najsilniejsza izolacja, z zachowaniem efektu wykonywania operacji jedna po drugiej. | Łatwo doprowadzić do długiego oczekiwania i zakleszczeń. |
W SQL Server i PostgreSQL domyślnie często spotyka się READ COMMITTED, ale sposób jego realizacji może być różny. Niektóre konfiguracje korzystają z wersjonowania wierszy, inne w większym stopniu z blokad. Dlatego przed zmianą izolacji sprawdzam nie tylko dokumentację silnika, lecz także rzeczywistą konfigurację środowiska.
Wyższa izolacja nie jest automatycznie lepsza. Daje silniejsze gwarancje, ale może obniżyć współbieżność. Dla raportu, który nie wykonuje zapisów, czasem wystarczy słabsza ochrona. Dla rezerwacji ostatniego produktu trzeba już dokładnie zabezpieczyć odczyt i zapis, aby dwa żądania nie przyznały tego samego zasobu.
Blokady, zakleszczenia i anomalie danych
Transakcja chroni dane, ale sama również korzysta z zasobów. Przy zapisie baza może założyć blokadę wiersza, strony albo większego zakresu. Im dłużej trwa operacja, tym dłużej inne procesy mogą czekać, dlatego czas trwania transakcji ma bezpośredni wpływ na wydajność.
Najczęstsze anomalie
- Brudny odczyt pojawia się wtedy, gdy proces widzi dane jeszcze niezatwierdzone przez inną transakcję.
- Odczyt niepowtarzalny oznacza, że ten sam rekord zwraca różne wartości podczas jednej pracy.
- Fantomy to nowe lub znikające wiersze pojawiające się przy ponownym wykonaniu tego samego warunku.
- Zakleszczenie występuje, gdy dwie transakcje czekają na zasoby trzymane przez siebie nawzajem.
Zakleszczenie nie musi oznaczać błędu projektu. Przy dużym ruchu może pojawić się nawet w poprawnej aplikacji, dlatego warstwa aplikacyjna powinna rozpoznać odpowiedni wyjątek i ponowić całą transakcję. Ponowienie pojedynczego polecenia zwykle nie wystarcza, bo pozostałe operacje muszą zostać wykonane w nowym, spójnym kontekście.
Najlepiej ograniczyć ryzyko przez krótkie transakcje, stałą kolejność dostępu do tabel oraz dobre indeksy. Nie otwieram transakcji przed wywołaniem zewnętrznego API i nie czekam w niej na interakcję użytkownika. Takie decyzje potrafią zablokować rekordy na sekundy lub minuty, a przy większym ruchu szybko zamieniają się w lawinę oczekujących zapytań.
Savepointy i obsługa błędów w aplikacjach .NET
Czasem większa operacja składa się z kilku etapów, z których jeden można wycofać bez anulowania wcześniejszych zmian. Do tego służy SAVEPOINT. Po utworzeniu punktu można wykonać ROLLBACK TO i wrócić do wskazanego miejsca, zachowując wcześniejszą część pracy.
BEGIN TRANSACTION;

INSERT INTO Zamowienia (KlientId)
VALUES (10);

SAVE TRANSACTION Pozycje;

INSERT INTO PozycjeZamowien (ZamowienieId, ProduktId, Ilosc)
VALUES (100, 5, 2);

-- W razie błędu:
ROLLBACK TRANSACTION Pozycje;

COMMIT TRANSACTION;
Savepoint nie jest jednak zamiennikiem dobrego podziału procesu. Jeśli etap jest niezależny biznesowo, często lepiej zapisać go w osobnej transakcji. W Entity Framework Core trzeba też pamiętać, że kontekst śledzi zmiany w pamięci, a wycofanie transakcji w bazie nie zawsze oznacza wyczyszczenie stanu śledzenia encji.
Co powinien robić kod aplikacji
- Otwierać transakcję możliwie blisko granicy jednostki biznesowej.
- Wykonywać rollback w bloku obsługi błędów.
- Logować identyfikator operacji, czas trwania i typ błędu.
- Ponawiać tylko błędy przejściowe, takie jak chwilowa niedostępność lub wybrane zakleszczenia.
- Zapewniać idempotencję, czyli możliwość bezpiecznego powtórzenia żądania.
Idempotencja jest szczególnie ważna przy płatnościach i kolejkach wiadomości. Jeśli klient nie wie, czy żądanie zakończyło się przed zerwaniem połączenia, może wysłać je ponownie. Unikalny identyfikator operacji pozwala rozpoznać duplikat i uniknąć podwójnego zapisu.
Najczęstsze błędy przy projektowaniu transakcji
Transakcja obejmuje zbyt dużo
Trzymanie otwartej transakcji podczas generowania raportu, wysyłania e-maila albo wywołania usługi płatniczej zwiększa liczbę blokad i ryzyko przekroczenia limitu czasu. Dane należy zapisać szybko, a komunikację z innymi systemami oprzeć na kolejce, zdarzeniu domenowym lub wzorcu outbox.
Rollback jest tylko teoretyczny
Częsty błąd polega na obsłużeniu wyjątku i zwróceniu komunikatu do klienta bez faktycznego wycofania zmian. W SQL Server trzeba też uważać na transakcję, która po błędzie jest już niezatwierdzalna. Sprawdzenie XACT_STATE() pomaga ustalić, czy można wykonać rollback.
Brak ograniczeń w samej bazie
Transakcja nie zastępuje kluczy obcych, indeksów unikalnych ani ograniczeń CHECK. Jeśli reguła ma chronić dane zawsze, powinna być zapisana również w schemacie bazy. Kod aplikacji może zawierać błąd, działać w kilku instancjach albo zostać ominięty przez skrypt administracyjny.
Przeczytaj również: Rekurencyjne zapytania SQL bez pułapek CTE i cykli
Mylenie transakcji z blokadą
Transakcja opisuje logiczną całość pracy, natomiast blokada jest jednym z mechanizmów ochrony współbieżnego dostępu. Można mieć transakcję, która prawie nie blokuje odczytów dzięki wersjonowaniu wierszy, albo krótkie zapytanie, które czeka na zasób zablokowany przez inną operację. To rozróżnienie bardzo ułatwia diagnozowanie problemów wydajnościowych.
Jak dobrać bezpieczny schemat dla konkretnej operacji
Zaczynam od pytania, co dokładnie musi być prawdziwe po zakończeniu procesu. Jeśli odpowiedź brzmi „albo wszystkie te zapisy, albo żaden”, tworzę jedną transakcję. Jeśli część procesu może zostać wykonana później, oddzielam ją i przekazuję dalej przez zdarzenie lub kolejkę.
Dla typowej operacji biznesowej stosuję prostą kolejność:
- Sprawdź dane wejściowe i uprawnienia przed otwarciem transakcji.
- Rozpocznij transakcję możliwie późno.
- Wykonaj wszystkie zależne od siebie odczyty i zapisy.
- Zatwierdź zmiany natychmiast po spełnieniu warunków.
- W przypadku błędu wycofaj całość i zwróć kontrolowany rezultat.
- Zmierz czas trwania oraz sprawdź, czy nie pojawiają się blokady.
Jeśli operacja dotyczy rezerwacji, dodaję kontrolę konkurencji, na przykład warunek w instrukcji UPDATE albo odpowiedni indeks i poziom izolacji. Sam wcześniejszy SELECT z informacją „produkt jest dostępny” nie gwarantuje jeszcze, że będzie dostępny w chwili zapisu.
Moim zdaniem najwięcej problemów bierze się nie z braku znajomości składni, lecz z niejasnej granicy procesu. Dobrze zaprojektowana transakcja jest krótka, przewidywalna, możliwa do ponowienia i obejmuje dokładnie te dane, które muszą zmienić się razem.
Spójność danych zaczyna się od dobrze wyznaczonej granicy
Transakcje są fundamentem bezpiecznych operacji w relacyjnych bazach danych, ale ich skuteczność zależy od decyzji projektowych. Trzeba dobrać właściwy zakres, poziom izolacji, obsługę błędów i strategię ponowień, a przy tym pamiętać, że system zewnętrzny nie zostanie automatycznie cofnięty razem z bazą.
Na początek wystarczy przeanalizować trzy rzeczy: które zapisy muszą być atomowe, jakie operacje mogą działać równolegle i co stanie się po zerwaniu połączenia. Taka krótka analiza zwykle daje większą poprawę jakości niż samo dodanie BEGIN TRANSACTION do istniejącego kodu.