Gdy trzeba policzyć pozycję klienta w jego regionie, porównać wynik pracownika ze średnią działu albo znaleźć trzy najnowsze rekordy dla każdej grupy, sama funkcja GROUP BY szybko przestaje wystarczać. Wtedy przydaje się PARTITION BY w SQL, czyli element funkcji okna, który dzieli wynik na logiczne części bez usuwania poszczególnych wierszy. Pokażę składnię, praktyczne przykłady, różnicę względem GROUP BY oraz błędy, które najczęściej prowadzą do niepoprawnych wyników.
PARTITION BY pozwala analizować każdą grupę bez utraty szczegółowych wierszy
- PARTITION BY dzieli wynik zapytania na niezależne grupy dla funkcji okna.
- GROUP BY zmniejsza liczbę wierszy, a funkcja okna zachowuje pełne dane szczegółowe.
- ORDER BY wewnątrz OVER ustala kolejność rankingu, numerowania lub obliczeń narastających.
- Najczęstsze zastosowania to ROW_NUMBER, RANK, sumy, średnie, LAG i LEAD.
- Po wyniku funkcji okna filtruje się zwykle w CTE lub podzapytaniu, a nie bezpośrednio w WHERE.
Jak działa PARTITION BY w SQL
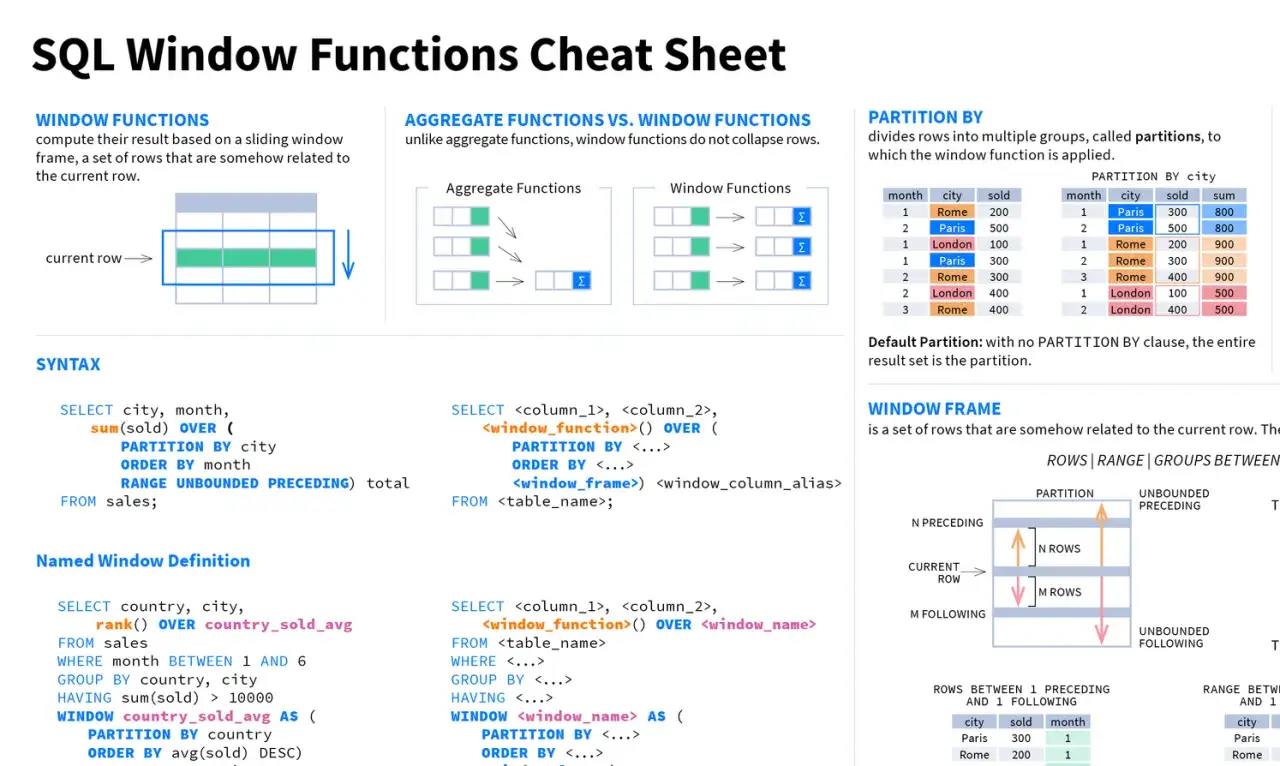
PARTITION BY działa wewnątrz klauzuli OVER(). Wskazana kolumna lub zestaw kolumn dzieli wynik zapytania na logiczne partycje, a funkcja okna wykonuje obliczenia osobno dla każdej z nich. Wiersze pozostają jednak w rezultacie, co odróżnia ten mechanizm od klasycznego grupowania.
SELECT
    pracownik,
    dzial,
    pensja,
    AVG(pensja) OVER (PARTITION BY dzial) AS srednia_w_dziale
FROM pracownicy;
Jeżeli dział „IT” ma pięciu pracowników, każdy z nich otrzyma w kolumnie srednia_w_dziale tę samą średnią dla działu IT. Jednocześnie zapytanie nadal zwróci pięć osobnych rekordów. To właśnie ten szczegół sprawia, że funkcje okna są tak wygodne w raportach i analizie danych.
Ogólny schemat zapytania
funkcja() OVER (
    PARTITION BY kolumna_grupujaca
    ORDER BY kolumna_sortujaca
)
Nie każda funkcja potrzebuje obu elementów. PARTITION BY określa, które wiersze mają być analizowane razem, natomiast ORDER BY ustala kolejność wewnątrz partycji. Dla AVG lub COUNT często wystarczy samo PARTITION BY, ale ROW_NUMBER, RANK, LAG i LEAD wymagają sensownie określonego porządku.
Gdy pominę PARTITION BY, całość wyniku jest traktowana jako jedna partycja. Przykładowo AVG(pensja) OVER () obliczy średnią dla wszystkich pracowników i powtórzy ją w każdym wierszu.
Najbardziej praktyczne zastosowania funkcji okna
Numerowanie rekordów w każdej grupie
ROW_NUMBER() nadaje kolejne numery wierszom, zaczynając od 1 w każdej partycji. To prosty sposób na znalezienie najnowszego zamówienia klienta albo ograniczenie wyników do kilku najlepszych rekordów.
SELECT
    klient_id,
    zamowienie_id,
    data_zamowienia,
    ROW_NUMBER() OVER (
        PARTITION BY klient_id
        ORDER BY data_zamowienia DESC
    ) AS numer_zamowienia
FROM zamowienia;
Dla każdego klienta najnowsze zamówienie dostanie numer 1, drugie numer 2 i tak dalej. W praktyce dodaję do ORDER BY także kolumnę jednoznacznie identyfikującą rekord, ponieważ sama data może się powtarzać.
ROW_NUMBER() OVER (
    PARTITION BY klient_id
    ORDER BY data_zamowienia DESC, zamowienie_id DESC
)
Ten drobny dodatek poprawia deterministyczność wyniku. Bez niego baza może różnie ustawić rekordy o identycznej dacie.
Ranking z uwzględnieniem remisów
ROW_NUMBER zawsze nadaje różne numery. Jeżeli dwa produkty mają taki sam wynik sprzedaży, jeden otrzyma pierwsze miejsce, a drugi drugie. Do klasyfikacji z remisami lepiej użyć RANK albo DENSE_RANK.
SELECT
    region,
    produkt,
    suma_sprzedazy,
    RANK() OVER (
        PARTITION BY region
        ORDER BY suma_sprzedazy DESC
    ) AS pozycja
FROM sprzedaz;| Funkcja | Wynik dla wartości 100, 100, 80 | Kiedy jej użyć |
|---|---|---|
| ROW_NUMBER | 1, 2, 3 | Gdy każdy rekord ma mieć unikalną pozycję |
| RANK | 1, 1, 3 | Gdy remis powinien pozostawić lukę w numeracji |
| DENSE_RANK | 1, 1, 2 | Gdy kolejne miejsce ma być numerowane bez luk |
Porównanie z sumą lub średnią grupy
Funkcje agregujące, takie jak SUM, COUNT i AVG, mogą działać jako funkcje okna. Dzięki temu każdy rekord może pokazywać zarówno własną wartość, jak i wynik dla całej grupy.
SELECT
    klient_id,
    zamowienie_id,
    wartosc,
    SUM(wartosc) OVER (
        PARTITION BY klient_id
    ) AS wartosc_wszystkich_zamowien,
    wartosc * 100.0 /
        SUM(wartosc) OVER (PARTITION BY klient_id) AS procent_wartosc
FROM zamowienia;
Takie zestawienie odpowiada na pytanie, jaki udział ma dane zamówienie w całkowitej wartości zakupów klienta. To znacznie wygodniejsze niż agregowanie danych w osobnym zapytaniu i ponowne łączenie ich przez JOIN.
Obliczenia narastające i poprzedni rekord
Gdy PARTITION BY połączę z ORDER BY, mogę budować sumę narastającą dla każdego klienta, konta albo produktu.
SELECT
    klient_id,
    data_operacji,
    kwota,
    SUM(kwota) OVER (
        PARTITION BY klient_id
        ORDER BY data_operacji
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS saldo_narastajaco
FROM operacje;
Klauzula ROWS precyzuje, które wiersze należą do bieżącego obliczenia. Przy powtarzających się datach ma to znaczenie, dlatego w rzeczywistych raportach często dodaję do ORDER BY identyfikator operacji.
Do porównywania rekordów w czasie służą LAG i LEAD. Przykład z LAG pokaże zmianę sprzedaży względem poprzedniego miesiąca w obrębie każdego produktu.
SELECT
    produkt_id,
    miesiac,
    sprzedaz,
    LAG(sprzedaz) OVER (
        PARTITION BY produkt_id
        ORDER BY miesiac
    ) AS sprzedaz_poprzednia
FROM raport_miesieczny;
Pierwszy wiersz każdej partycji nie ma poprzednika, więc wynik LAG będzie dla niego wartością NULL. To normalne zachowanie, a nie błąd zapytania.
PARTITION BY a GROUP BY i ORDER BY
Najwięcej nieporozumień wynika z traktowania PARTITION BY jak zamiennika GROUP BY. Obie konstrukcje dzielą dane według wartości, ale robią to na innym poziomie i dają inny rezultat.
| Konstrukcja | Co robi | Co dzieje się z wierszami |
|---|---|---|
| GROUP BY | Tworzy grupy i agreguje ich dane | Liczba rekordów zwykle maleje |
| PARTITION BY | Dzieli dane dla funkcji okna | Wiersze szczegółowe pozostają w wyniku |
| ORDER BY w OVER() | Ustala kolejność obliczeń wewnątrz partycji | Nie musi zmieniać kolejności końcowego wyniku |
| ORDER BY na końcu zapytania | Sortuje rezultat zwracany użytkownikowi | Wpływa na prezentację całego wyniku |
Przykładowo GROUP BY zwróci jedną linię dla każdego działu:
SELECT dzial, AVG(pensja) AS srednia
FROM pracownicy
GROUP BY dzial;
PARTITION BY pokaże średnią działu przy każdym pracowniku:
SELECT
    pracownik,
    dzial,
    pensja,
    AVG(pensja) OVER (PARTITION BY dzial) AS srednia
FROM pracownicy;
Sam wybieram GROUP BY wtedy, gdy raport ma zawierać wyłącznie poziom grupy. PARTITION BY jest lepsze, gdy trzeba zachować szczegóły i jednocześnie dodać kontekst, na przykład udział procentowy, ranking albo różnicę względem średniej.
Trzeba też rozdzielić dwa znaczenia ORDER BY. To użyte w OVER steruje obliczeniem funkcji okna, a ORDER BY zapisane na końcu zapytania sortuje gotowy rezultat. Jedno nie zastępuje drugiego.
Jak filtrować wynik i unikać typowych błędów
Filtrowanie po numerze wiersza
Nie można w większości popularnych silników użyć aliasu funkcji okna bezpośrednio w WHERE tego samego poziomu SELECT. Najpierw obliczam numer w CTE lub podzapytaniu, a dopiero później go filtruję.
WITH ranking AS (
    SELECT
        region,
        produkt,
        sprzedaz,
        ROW_NUMBER() OVER (
            PARTITION BY region
            ORDER BY sprzedaz DESC
        ) AS pozycja
    FROM sprzedaz
)
SELECT *
FROM ranking
WHERE pozycja <= 3;
To zapytanie zwraca trzy produkty z każdego regionu, a nie trzy produkty z całej tabeli. Ten wzorzec jest jednym z najbardziej użytecznych zastosowań PARTITION BY w codziennej pracy.
Niejasna kolejność rekordów
Ranking bez ORDER BY jest błędem logicznym, nawet jeśli konkretna baza zaakceptuje składnię. Gdy kolejność ma znaczenie, sortowanie powinno być jednoznaczne i obejmować kolumnę rozstrzygającą remisy.
Nieprawidłowy dobór kolumny partycji
Kolumna w PARTITION BY powinna odpowiadać biznesowemu podziałowi danych. Podział po identyfikatorze transakcji, który jest unikalny, sprawi, że niemal każdy rekord stanie się osobną partycją. Funkcja zadziała, ale wynik zwykle nie będzie miał sensu.
Można użyć kilku kolumn jednocześnie:
ROW_NUMBER() OVER (
    PARTITION BY klient_id, rok
    ORDER BY data_zamowienia DESC
)
W tym przypadku numerowanie zaczyna się od nowa dla każdej pary klient i rok. To często lepsze rozwiązanie niż tworzenie dodatkowej kolumny łączącej te wartości.
Przeczytaj również: LAG w SQL bez błędów - PARTITION BY, ORDER BY i przykłady
NULL i różnice między silnikami
Wartość NULL jest traktowana jako należąca do jednej wspólnej grupy przez funkcję partycjonującą, ale szczegóły sortowania wartości NULL mogą zależeć od silnika. Jeżeli kolejność pustych wartości jest istotna, ustal ją jawnie wyrażeniem CASE albo składnią obsługiwaną przez konkretną bazę.
Podstawowa składnia jest podobna w SQL Server, PostgreSQL, Oracle i MySQL 8+, ale dostępność poszczególnych funkcji, obsługa ramek oraz szczegóły typów danych mogą się różnić. Przed przeniesieniem zapytania między systemami sprawdzam przede wszystkim ROWS, RANGE, sortowanie NULL oraz możliwość użycia funkcji okna w danym miejscu zapytania.
Wydajność i dobre praktyki w większych tabelach
PARTITION BY nie tworzy fizycznych partycji tabeli i samo w sobie nie przyspiesza zapytania. To logiczny mechanizm obliczeń w wyniku SELECT, a nie instrukcja dzielenia danych na osobne fragmenty na dysku.
Przy dużych tabelach koszt zwykle wynika z sortowania danych według kolumn z PARTITION BY i ORDER BY. Pomóc może indeks obejmujący kolumny używane do podziału oraz sortowania, ale jego skuteczność zależy od silnika, selektywności danych i całego planu wykonania.
- Filtruj dane w WHERE przed obliczeniem funkcji okna, jeśli nie potrzebujesz całej tabeli.
- Ogranicz liczbę kolumn używanych w PARTITION BY do tych, które naprawdę opisują grupę.
- Dodaj stabilny klucz do ORDER BY, gdy wartości mogą się powtarzać.
- Sprawdzaj plan wykonania zamiast zakładać, że sam indeks rozwiąże problem.
- Przy raportach uruchamianych cyklicznie rozważ wcześniejsze agregowanie danych.
Najczęstszy błąd optymalizacyjny polega na użyciu funkcji okna na milionach rekordów, a dopiero potem odrzuceniu większości danych. Jeżeli raport dotyczy tylko bieżącego roku, filtr po dacie powinien znaleźć się możliwie wcześnie, zanim baza wykona kosztowne sortowanie i numerowanie.
Nie warto też zastępować funkcji okna wieloma zagnieżdżonymi podzapytaniami tylko dlatego, że GROUP BY wydaje się bardziej znajomy. Dobrze zapisane zapytanie z PARTITION BY jest często czytelniejsze, ale ostateczną decyzję powinien potwierdzić plan wykonania i rzeczywisty czas działania.
Jak dobierać PARTITION BY do konkretnego problemu
Zaczynam od pytania, dla jakiej grupy ma być liczony wynik. Jeśli chcę wskazać najlepsze produkty w każdym regionie, partycją będzie region. Jeśli porównuję kolejne operacje rachunku, użyję identyfikatora rachunku. Dopiero później dobieram funkcję i kolejność.
- Potrzebujesz numeru rekordu w grupie? Użyj ROW_NUMBER.
- Potrzebujesz rankingu z remisami? Wybierz RANK albo DENSE_RANK.
- Chcesz pokazać sumę przy każdym szczególe? Użyj SUM() OVER (PARTITION BY ...).
- Porównujesz bieżący rekord z poprzednim? Sięgnij po LAG.
- Potrzebujesz kolejnego rekordu? Użyj LEAD.
- Chcesz znaleźć pierwsze N rekordów w każdej grupie? Połącz funkcję okna z CTE i filtrem po pozycji.
W mojej praktyce najwięcej problemów nie wynika ze składni, tylko z błędnego modelu wyniku. Zanim napiszę zapytanie, zapisuję na kartce jeden przykładowy rekord i odpowiadam, z którymi innymi rekordami powinien być porównywany. Ta prosta metoda szybko pokazuje, czy partycją powinien być klient, miesiąc, produkt, czy ich kombinacja.
PARTITION BY jest więc przede wszystkim narzędziem do zachowania szczegółów przy jednoczesnym liczeniu wyników dla grup. Gdy połączysz właściwą partycję z jednoznacznym ORDER BY i odpowiednią funkcją okna, możesz budować rankingi, sumy narastające i porównania bez skomplikowanych JOIN-ów. To jeden z tych elementów SQL, który początkowo wygląda jak dodatkowa składnia, a po kilku realnych raportach staje się naturalnym sposobem myślenia o danych.