Gdy raport ma pokazać zmianę sprzedaży, statusu urządzenia albo czasu między zdarzeniami, samo sortowanie rekordów szybko przestaje wystarczać. Funkcja LAG pozwala odczytać wartość z poprzedniego wiersza tego samego wyniku, a potem porównać ją z bieżącym rekordem bez skomplikowanych self-joinów. Poniżej pokazuję składnię, praktyczne przykłady, znaczenie PARTITION BY i ORDER BY oraz błędy, przez które wynik potrafi być pozornie poprawny, ale biznesowo błędny.
LAG ułatwia porównywanie bieżącego rekordu z wcześniejszym
- Funkcja LAG zwraca wartość z poprzedniego wiersza w ustalonej kolejności.
- ORDER BY określa, który rekord SQL uzna za wcześniejszy.
- PARTITION BY pozwala prowadzić niezależną historię dla klienta, produktu lub urządzenia.
- Brak poprzedniego wiersza daje zwykle NULL, chyba że ustawisz wartość domyślną.
- Najczęstszy błąd to analiza danych bez deterministycznego sortowania.
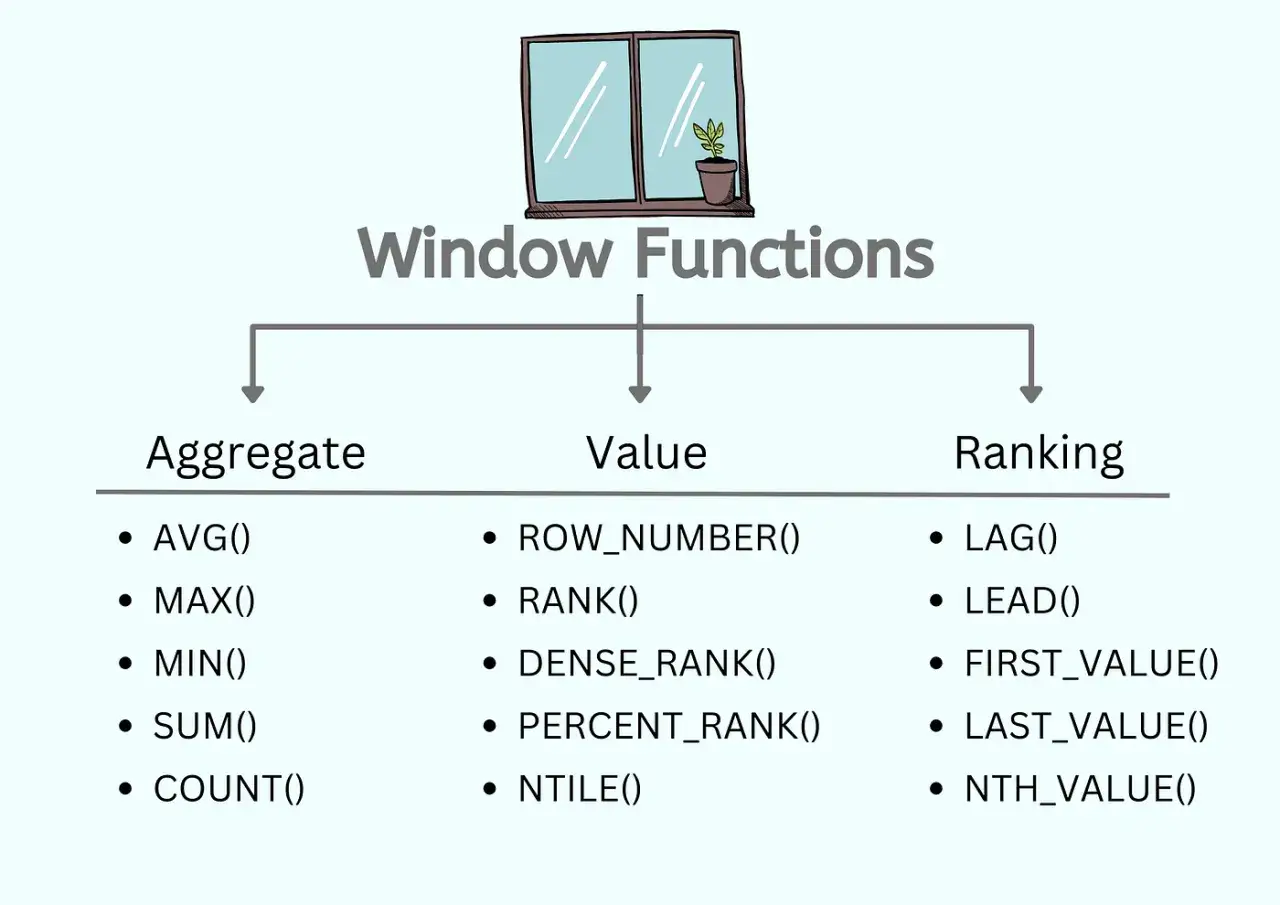
Jak działa funkcja LAG w SQL
Najprostsza wersja wygląda tak:
SELECT
    order_date,
    amount,
    LAG(amount) OVER (ORDER BY order_date) AS previous_amount
FROM orders;
Dla każdego rekordu baza zwróci wartość amount z poprzedniego wiersza. Pierwszy rekord nie ma poprzednika, dlatego otrzyma NULL. To ważne, bo brak wartości nie oznacza zera ani błędu, tylko informację, że porównanie nie jest jeszcze możliwe.
Pełna postać funkcji może zawierać przesunięcie i wartość zastępczą:
LAG(wyrażenie, przesunięcie, wartość_domyslna)
OVER (
    PARTITION BY kolumna_grupująca
    ORDER BY kolumna_sortująca
)
Przesunięcie równe 1 oznacza poprzedni wiersz, 2 oznacza rekord sprzed dwóch pozycji, a 3 rekord sprzed trzech pozycji. W praktyce najczęściej korzystam z domyślnego przesunięcia, bo kod jest wtedy czytelniejszy.
Co robią poszczególne elementy
-
wyrażenieto kolumna lub obliczenie, którego wcześniejszą wartość chcesz odczytać. -
PARTITION BYdzieli wynik na niezależne grupy. -
ORDER BYustala kolejność rekordów wewnątrz każdej grupy. -
wartość_domyslnazastępujeNULL, gdy wcześniejszy wiersz nie istnieje.
Funkcja nie zmienia liczby rekordów i nie agreguje danych. Dodaje jedynie kolumnę wyliczoną na podstawie sąsiedniego wiersza, dlatego dobrze sprawdza się w raportach, analizie trendów i kontroli sekwencji zdarzeń.
ORDER BY decyduje, czym naprawdę jest poprzedni wiersz
W funkcjach okienkowych słowo „poprzedni” nie oznacza poprzedniego rekordu w tabeli. Oznacza rekord wcześniejszy według kolejności zdefiniowanej w klauzuli ORDER BY. To drobna różnica w składni, ale bardzo częste źródło błędnych raportów.
SELECT
    customer_id,
    order_date,
    order_id,
    amount,
    LAG(amount) OVER (
        PARTITION BY customer_id
        ORDER BY order_date, order_id
    ) AS previous_amount
FROM orders;
Drugie kryterium, czyli order_id, rozstrzyga sytuację, gdy dwa zamówienia mają tę samą datę. Bez niego kolejność może być niejednoznaczna, a wynik zależny od planu wykonania lub fizycznego sposobu odczytu danych. Moja praktyczna zasada jest prosta: jeżeli data nie jest unikalna, dodaj do sortowania stabilny identyfikator.
PARTITION BY customer_id sprawia, że pierwszy zakup jednego klienta nie zostanie porównany z ostatnim zakupem innej osoby. Bez podziału funkcja przeanalizowałaby całą tabelę jako jedną sekwencję, co w większości raportów byłoby merytorycznym błędem.
Praktyczne przykłady użycia funkcji LAG
Zmiana wartości względem poprzedniego okresu
Załóżmy, że tabela zawiera miesięczne przychody klientów. Najpierw pobieramy poprzednią wartość, a dopiero potem obliczamy różnicę:
WITH sales_with_previous AS (
    SELECT
        customer_id,
        month_start,
        revenue,
        LAG(revenue) OVER (
            PARTITION BY customer_id
            ORDER BY month_start
        ) AS previous_revenue
    FROM monthly_sales
)
SELECT
    customer_id,
    month_start,
    revenue,
    previous_revenue,
    revenue - previous_revenue AS revenue_change
FROM sales_with_previous;
Na pierwszym miesiącu klienta różnica będzie równa NULL, ponieważ nie ma jeszcze okresu odniesienia. Nie zastępowałbym tej wartości zerem bez wyraźnego powodu, bo raport może wtedy sugerować, że przychód wzrósł od zera, choć w rzeczywistości po prostu nie mamy wcześniejszych danych.
Obliczanie zmiany procentowej
Do wyliczenia dynamiki potrzebna jest ochrona przed dzieleniem przez zero:
WITH sales_with_previous AS (
    SELECT
        month_start,
        revenue,
        LAG(revenue) OVER (ORDER BY month_start) AS previous_revenue
    FROM monthly_sales
)
SELECT
    month_start,
    revenue,
    previous_revenue,
    (revenue - previous_revenue) * 100.0
        / NULLIF(previous_revenue, 0) AS change_percent
FROM sales_with_previous;
NULLIF(previous_revenue, 0) zamienia zero na NULL, dzięki czemu zapytanie nie kończy się błędem. Taki wynik wymaga później świadomej interpretacji, bo brak procentu może oznaczać zarówno pierwszy okres, jak i poprzednią wartość równą zero.
Wykrywanie zmiany statusu
To jeden z najbardziej użytecznych scenariuszy w systemach monitoringu i aplikacjach biznesowych:
WITH status_history AS (
    SELECT
        device_id,
        event_time,
        event_id,
        status,
        LAG(status) OVER (
            PARTITION BY device_id
            ORDER BY event_time, event_id
        ) AS previous_status
    FROM device_events
)
SELECT
    device_id,
    event_time,
    previous_status,
    status
FROM status_history
WHERE previous_status IS NULL
   OR previous_status <> status;
Zapytanie zwraca pierwszy znany status urządzenia oraz momenty, w których status faktycznie się zmienił. Dodanie event_id jest istotne, gdy kilka zdarzeń ma identyczny czas zapisu.
Pomiar przerwy między zdarzeniami
Możesz również pobrać poprzedni czas zdarzenia, a następnie obliczyć odstęp między rekordami. Samo odejmowanie dat zależy od silnika SQL, dlatego w SQL Server użyjesz na przykład DATEDIFF, a w PostgreSQL możesz operować bezpośrednio na wartościach typu timestamp.
WITH events_with_previous AS (
    SELECT
        user_id,
        occurred_at,
        LAG(occurred_at) OVER (
            PARTITION BY user_id
            ORDER BY occurred_at
        ) AS previous_occurred_at
    FROM user_events
)
SELECT
    user_id,
    occurred_at,
    previous_occurred_at
FROM events_with_previous;
To podejście pozwala znaleźć długie przerwy w aktywności, czas między logowaniami albo opóźnienia w procesie. Najpierw pobieram poprzedni rekord, a dopiero później stosuję funkcję dat właściwą dla konkretnej bazy.
LAG, LEAD czy self-join
Funkcja LAG nie jest jedynym sposobem porównywania rekordów. Wybór zależy od kierunku analizy i od tego, czy potrzebujesz tylko sąsiedniego wiersza, czy bardziej złożonego dopasowania.
| Rozwiązanie | Kiedy użyć | Najważniejsza cecha |
|---|---|---|
LAG |
Porównanie z wcześniejszym rekordem | Czytelna funkcja okienkowa |
LEAD |
Porównanie z kolejnym rekordem | Patrzy do przodu w ustalonej kolejności |
ROW_NUMBER plus join |
Niestandardowe dopasowanie rekordów | Większa kontrola, ale więcej kodu |
| Self-join | Porównanie według kilku niezależnych warunków | Elastyczny, lecz często trudniejszy w utrzymaniu |
Jeśli pytanie brzmi „jaka była poprzednia wartość?”, zaczynam od LAG. Jeżeli interesuje mnie następny termin lub następne zdarzenie, wybieram LEAD. Self-join zostawiam na sytuacje, w których wcześniejszy rekord nie jest po prostu poprzednią pozycją po sortowaniu.
Typowe błędy i ograniczenia
Brak deterministycznego sortowania
Najgroźniejszy błąd polega na sortowaniu wyłącznie po kolumnie, która może mieć powtarzające się wartości. Dwie transakcje z tą samą datą mogą wtedy zostać ułożone w nieprzewidywalnej kolejności. Rozwiązaniem jest dodanie klucza głównego, numeru zdarzenia albo innej kolumny gwarantującej jednoznaczny porządek.
Traktowanie NULL jak zera
Domyślnie pierwszy rekord w każdej partycji zwraca NULL. Możesz użyć konstrukcji LAG(amount, 1, 0), ale rób to tylko wtedy, gdy zero ma właściwe znaczenie biznesowe. W raportach finansowych bezpieczniej jest zachować NULL i obsłużyć pierwszy okres osobno.
Łączenie agregacji i LAG w jednym kroku
W wielu silnikach nie można bezpośrednio użyć funkcji okienkowej jako argumentu innej funkcji okienkowej ani mieszać jej z agregacją w sposób, który zmienia poziom szczegółowości. Dlatego praktyczny wzorzec to dwa etapy: najpierw agregacja w CTE lub podzapytaniu, później zastosowanie LAG do gotowego wyniku.
Oczekiwanie, że funkcja zawsze przyspieszy zapytanie
LAG upraszcza logikę, ale nie gwarantuje automatycznie najlepszego czasu wykonania. Baza często musi posortować dane według kolumn z PARTITION BY i ORDER BY. Przy dużych tabelach sprawdź plan wykonania i rozważ indeks pokrywający kolejność używaną w analizie, na przykład indeks zaczynający się od customer_id i month_start.
Jak bezpiecznie wdrożyć LAG w projekcie
Zaczynam od opisania, co dokładnie oznacza „poprzedni rekord”. Czy chodzi o poprzedni zakup klienta, poprzedni dzień kalendarzowy, ostatni status urządzenia, czy może poprzednią wersję dokumentu? Dopiero potem dobieram kolumny do PARTITION BY i ORDER BY.
- Zdefiniuj grupę, dla której ma powstać niezależna historia.
- Ustal jednoznaczną kolejność i dodaj kolumnę rozstrzygającą remisy.
-
Sprawdź pierwszy rekord każdej partycji i sposób obsługi wartości
NULL. - Przetestuj powtarzające się daty, brakujące okresy oraz wartości równe zero.
- Uruchom plan wykonania, jeśli zapytanie pracuje na dużej tabeli.
W aplikacjach .NET szczególnie pilnuję, aby obliczenia wykonywały się po stronie bazy, zanim dane trafią do pamięci aplikacji. Pobieranie całej historii do C# i szukanie poprzedniego elementu w kodzie zwykle zwiększa transfer, komplikuje paginację i utrudnia wykorzystanie indeksów.
Mała kontrola przed użyciem funkcji LAG
Jeżeli potrafisz jednym zdaniem opisać, jaki rekord jest poprzednikiem bieżącego, masz dobry punkt wyjścia do napisania zapytania. W większości przypadków wystarczy poprawnie ustawić PARTITION BY, ORDER BY i obsługę NULL, a cała reszta jest już prostym obliczeniem różnicy, zmiany statusu albo odstępu czasu.
Największą wartość daje nie samo poznanie składni, lecz świadome zdefiniowanie kolejności danych. Dobrze ustawiona funkcja LAG skraca zapytania i poprawia ich czytelność, ale źle ustawione sortowanie potrafi równie szybko wygenerować wiarygodnie wyglądający, błędny raport.