Model danych zaczyna się dziś często nie od diagramu w narzędziu graficznym, lecz od klas C# opisujących reguły aplikacji. Podejście entity framework code first pozwala na tej podstawie zbudować model relacyjny, wygenerować migracje i kontrolowanie rozwijać bazę danych razem z kodem. Pokażę, jak działa ten proces w Entity Framework Core, kiedy ma sens, gdzie pojawiają się pułapki oraz jak przygotować rozwiązanie do pracy z SQL Serverem lub SQLite.
Model w kodzie, migracje i baza rozwijane jako jedna całość
- Code First zaczyna od klas C# i konfiguracji modelu, a nie od gotowych tabel.
- DbContext odpowiada za mapowanie encji, zapytania, śledzenie zmian i zapis danych.
- Migracje opisują różnice między kolejnymi wersjami modelu i aktualizują schemat bez kasowania danych.
- Fluent API daje większą kontrolę niż same konwencje i adnotacje.
- W produkcji migracje trzeba przejrzeć, przetestować i wdrażać kontrolowanie, a nie wykonywać bezrefleksyjnie przy każdym uruchomieniu aplikacji.
Na czym polega Code First w Entity Framework Core
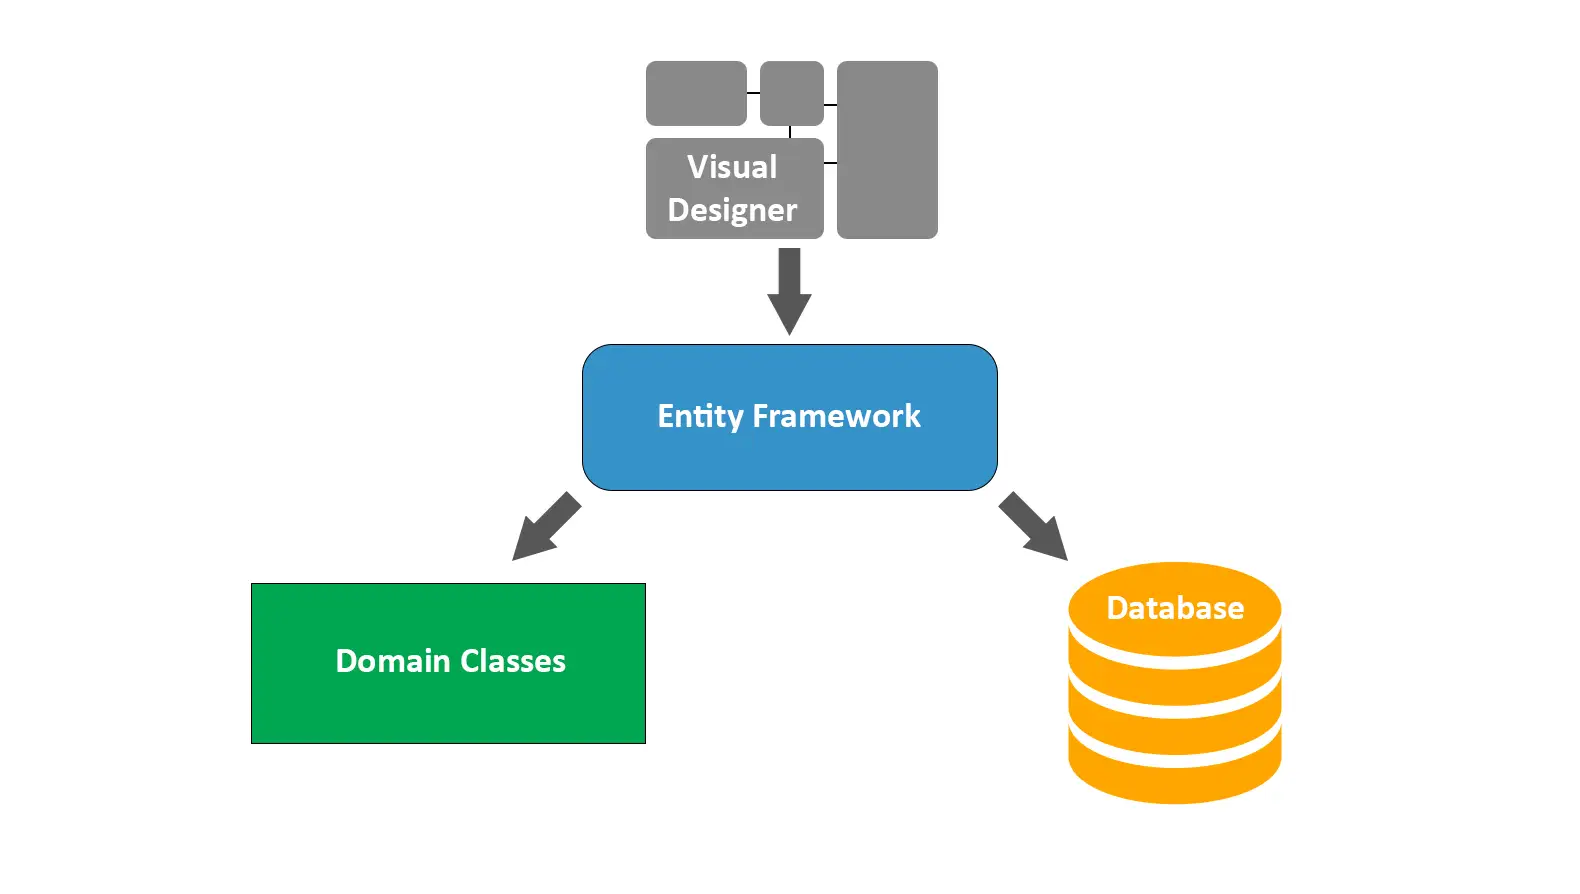
W tym podejściu źródłem prawdy jest przede wszystkim model zapisany w kodzie. Tworzę klasy encji, opisuję ich właściwości i relacje, a Entity Framework Core buduje wewnętrzną reprezentację modelu. Na jej podstawie może wygenerować SQL tworzący tabele, klucze, indeksy i ograniczenia.
Nie oznacza to jednak, że sama zmiana klasy automatycznie zmieni bazę produkcyjną. Pomiędzy kodem a schematem znajduje się mechanizm migracji. To pliki C#, które opisują operacje potrzebne do przejścia z jednego modelu danych do kolejnego.
Przykładowy model może wyglądać tak:
public class Product
{
    public int Id { get; set; }
    public string Name { get; set; } = string.Empty;
    public decimal Price { get; set; }

    public int CategoryId { get; set; }
    public Category Category { get; set; } = null!;
}

public class Category
{
    public int Id { get; set; }
    public string Name { get; set; } = string.Empty;

    public ICollection Products { get; set; } = new List();
}
W tym przykładzie EF Core rozpozna dwie encje, klucze główne oraz relację wiele do jednego. W praktyce nie zostawiam jednak ważnych decyzji wyłącznie konwencjom. Długość nazwy, precyzja ceny i zachowanie klucza obcego powinny być świadomie określone, bo późniejsza korekta schematu może wymagać migracji danych.
Rola DbContext
DbContext jest punktem kontaktu aplikacji z bazą. Udostępnia kolekcje encji, śledzi zmiany obiektów i podczas SaveChanges tłumaczy je na polecenia SQL. Można powiedzieć, że jest jednocześnie mapą modelu i krótkotrwałą sesją pracy z bazą danych.
public class ShopDbContext : DbContext
{
    public DbSet Products => Set();
    public DbSet Categories => Set();

    public ShopDbContext(DbContextOptions options)
        : base(options)
    {
    }
}
W aplikacji ASP.NET Core kontekst zwykle rejestruję w kontenerze zależności:
builder.Services.AddDbContext(options =>
    options.UseSqlServer(
        builder.Configuration.GetConnectionString("ShopDatabase")));
Connection string powinien pochodzić z konfiguracji środowiska, sekretów lub bezpiecznego magazynu. Nie zapisuj haseł do bazy bezpośrednio w kodzie, nawet jeśli projekt jest na początku mały i działa tylko lokalnie.
Jak uruchomić pierwszy model od zera
Najprostszy przepływ składa się z czterech elementów. Wybieram provider bazy, tworzę encje, konfiguruję DbContext, a potem generuję i uruchamiam pierwszą migrację. Provider to pakiet, który tłumaczy operacje EF Core na dialekt konkretnej bazy, na przykład SQL Servera, SQLite lub PostgreSQL.
Pakiety i konfiguracja
Dla SQL Servera potrzebne są zwykle pakiet providera oraz pakiet narzędzi projektowych:
dotnet add package Microsoft.EntityFrameworkCore.SqlServer
dotnet add package Microsoft.EntityFrameworkCore.Design
Narzędzie CLI można zainstalować globalnie:
dotnet tool install --global dotnet-efDla SQLite zmienia się przede wszystkim provider:
dotnet add package Microsoft.EntityFrameworkCore.SqliteNie mieszałbym przypadkowo wersji pakietów z różnych głównych wydań. Wersja EF Core i providera powinna być zgodna, ponieważ provider uczestniczy w generowaniu SQL oraz obsłudze typów danych.
Pierwsza migracja
Gdy model i konfiguracja są gotowe, tworzę migrację:
dotnet ef migrations add InitialCreate
dotnet ef database update
Pierwsze polecenie zapisuje w projekcie operacje tworzące schemat. Drugie wykonuje je na wskazanej bazie. EF Core zapisuje historię zastosowanych migracji w specjalnej tabeli, dzięki czemu wie, które zmiany zostały już wdrożone.
Wygenerowane pliki powinny trafić do kontroli wersji. Nie traktuję ich jako tymczasowego kodu, który można usunąć po utworzeniu bazy. Migracje są historią ewolucji schematu i powinny być dostępne dla innych programistów oraz procesu CI/CD.
Co faktycznie powstaje w bazie
Dla przykładowych klas EF Core utworzy tabele Products i Categories, kolumny odpowiadające właściwościom, klucze główne oraz klucz obcy łączący produkt z kategorią. Konkretne nazwy i typy zależą od konwencji, konfiguracji i wybranego providera.
Przed zastosowaniem migracji w ważnym środowisku sprawdzam wygenerowany kod. Zmiana nazwy właściwości może zostać odczytana jako usunięcie starej kolumny i utworzenie nowej. Dla danych produkcyjnych taka operacja może oznaczać ich utratę, jeśli migracja nie zostanie ręcznie poprawiona.
Jak kontrolować mapowanie klas na tabele
Konwencje są wygodne na początku, ale szybko pojawiają się wymagania, których nie da się dobrze opisać samym nazewnictwem. Chodzi o długości tekstów, indeksy, relacje, wartości domyślne, typy dziesiętne czy nazwy tabel. Wtedy korzystam z adnotacji albo Fluent API.
Adnotacje danych
Adnotacje są szybkie i czytelne przy prostych regułach:
public class Product
{
    public int Id { get; set; }

    [MaxLength(200)]
    [Required]
    public string Name { get; set; } = string.Empty;

    [Precision(18, 2)]
    public decimal Price { get; set; }
}
To rozwiązanie sprawdza się w nieskomplikowanych modelach. Gdy konfiguracja zaczyna mieszać się z klasą domenową, przenoszę ją do osobnych klas. Dzięki temu encja opisuje zachowanie biznesowe, a mapowanie pozostaje w warstwie infrastruktury.
Fluent API dla ważnych reguł
Fluent API daje większą kontrolę i dobrze nadaje się do relacji oraz indeksów:
protected override void OnModelCreating(ModelBuilder modelBuilder)
{
    modelBuilder.Entity(entity =>
    {
        entity.ToTable("Products");

        entity.HasKey(product => product.Id);

        entity.Property(product => product.Name)
            .HasMaxLength(200)
            .IsRequired();

        entity.Property(product => product.Price)
            .HasPrecision(18, 2);

        entity.HasIndex(product => product.Name);

        entity.HasOne(product => product.Category)
            .WithMany(category => category.Products)
            .HasForeignKey(product => product.CategoryId)
            .OnDelete(DeleteBehavior.Restrict);
    });
}
DeleteBehavior.Restrict jest dobrym przykładem decyzji, której nie zostawiam przypadkowi. Jeśli kategoria ma produkty, usunięcie jej może być niedozwolone. Automatyczne usuwanie kaskadowe bywa wygodne, ale przy bardziej złożonym grafie encji potrafi skasować więcej danych, niż zakładał użytkownik.
W większych projektach warto rozdzielić konfiguracje:
public class ProductConfiguration
    : IEntityTypeConfiguration
{
    public void Configure(EntityTypeBuilder builder)
    {
        builder.HasKey(product => product.Id);
        builder.Property(product => product.Name)
            .HasMaxLength(200)
            .IsRequired();
    }
}
Następnie rejestruję je automatycznie:
modelBuilder.ApplyConfigurationsFromAssembly(
    typeof(ShopDbContext).Assembly);
Najważniejsza zasada brzmi prosto: konwencje dla oczywistych przypadków, adnotacje dla prostych wyjątków, a Fluent API dla reguł, które mają znaczenie dla bazy i domeny.
Migracje jako bezpieczny sposób rozwijania schematu
Model Code First jest użyteczny głównie dlatego, że pozwala rozwijać bazę razem z aplikacją. Dodaję właściwość, zmieniam relację albo tworzę nową encję, a potem generuję kolejną migrację:
dotnet ef migrations add AddProductSku
dotnet ef database update
EF Core porównuje aktualny model z poprzednim snapshotem i proponuje zestaw zmian. Zwykle będzie to dodanie kolumny, tabeli, indeksu lub klucza obcego. Nie należy jednak zakładać, że wygenerowana migracja zawsze rozumie intencję autora.
Zmiana nazwy kolumny
Jeśli właściwość Code zmienię na Sku, narzędzie może wygenerować usunięcie kolumny Code i dodanie kolumny Sku. Dla pustej bazy nie ma to większego znaczenia. Dla istniejących danych trzeba poprawić migrację tak, aby wykonała zmianę nazwy zamiast kasowania zawartości.
migrationBuilder.RenameColumn(
    name: "Code",
    table: "Products",
    newName: "Sku");
Zmiana wymaganej właściwości
Dodanie wymaganej kolumny do tabeli, która ma już tysiące rekordów, wymaga wartości dla istniejących wierszy albo etapowego wdrożenia. Najpierw można dodać kolumnę jako opcjonalną, uzupełnić dane, a dopiero później zmienić ją na wymaganą. To jeden z tych przypadków, w których model obiektowy nie pokazuje całego kosztu zmiany w SQL.
Wdrażanie na produkcji
Lokalnie polecenie database update jest bardzo wygodne. Na produkcji wolę wygenerować skrypt SQL lub pakiet migracyjny, poddać go przeglądowi i uruchomić w ramach kontrolowanego wdrożenia. Daje to możliwość sprawdzenia blokad, czasu wykonania i wpływu na duże tabele.
Nie polecam uruchamiania migracji przez każdą instancję aplikacji podczas startu. Przy kilku instancjach może dojść do wyścigu, a aplikacja otrzymuje uprawnienia do zmiany schematu, których zwykle nie powinna mieć na co dzień. Proces wdrożeniowy powinien być właścicielem zmian struktury bazy.
Code First a Database First i ręczne SQL
Wybór podejścia zależy przede wszystkim od tego, gdzie znajduje się główna odpowiedzialność za model. W nowej aplikacji, której domena dopiero powstaje, kod często lepiej pokazuje intencje niż gotowa baza. W systemie korzystającym z istniejącego, współdzielonego schematu sytuacja może być odwrotna.
| Podejście | Źródło modelu | Najlepsze zastosowanie | Główne ryzyko |
|---|---|---|---|
| Code First | Klasy C# i konfiguracja | Nowe aplikacje rozwijane razem z domeną | Niedopasowanie migracji do realnych danych |
| Database First | Istniejący schemat SQL | Systemy z utrwaloną bazą i procedurami | Model wygenerowany z bazy może być mało domenowy |
| Ręczne SQL | Skrypty i decyzje administratora | Precyzyjna kontrola nad wydajnością i wdrożeniem | Więcej kodu i większa odpowiedzialność zespołu |
Code First nie oznacza rezygnacji z SQL. Nadal można używać zapytań surowych, procedur składowanych czy skryptów migracyjnych. Dla raportów, nietypowych optymalizacji i operacji masowych często łączę EF Core z ręcznie napisanym SQL, zamiast zmuszać ORM do obsługi każdego przypadku.
Warto też rozróżnić EF6 od EF Core. Oba rozwiązania mają podobne idee, ale różnią się pakietami, narzędziami i częścią API. W nowych aplikacjach .NET zazwyczaj wybiera się EF Core, natomiast starsze systemy na .NET Framework mogą nadal korzystać z Entity Framework 6.
Najczęstsze błędy przy pracy z Code First
Traktowanie migracji jak przycisku do naprawy bazy
Usunięcie wszystkich migracji i utworzenie jednej nowej może wyglądać na szybkie rozwiązanie, ale jest bezpieczne głównie dla lokalnej, tymczasowej bazy. W zespole lub na produkcji niszczy historię zmian i utrudnia odtworzenie właściwego stanu. Migracje należy poprawiać świadomie, a nie regularnie resetować.
Brak indeksów wynikających z zapytań
EF Core potrafi wygenerować poprawne tabele, ale nie zna całego sposobu używania aplikacji. Jeśli często wyszukuję zamówienia po numerze klienta i dacie, powinienem rozważyć odpowiedni indeks, także złożony. Samo mapowanie encji nie gwarantuje dobrego planu wykonania SQL.
Ładowanie całego grafu encji
Nawigacje są wygodne, lecz bez kontroli mogą prowadzić do zbyt dużej liczby zapytań albo pobierania niepotrzebnych danych. Do ekranów list stosuję projekcje do DTO, na przykład wybierając tylko identyfikator, nazwę i cenę. Nie każda encja pobrana z bazy musi być pełnym obiektem domenowym.
Brak testu migracji na kopii danych
Migracja, która działa na pustej bazie, nie musi działać na bazie zawierającej miliony rekordów. Przed wdrożeniem sprawdzam ją na reprezentatywnym zrzucie, mierzę czas operacji i analizuję blokady. Przy dużych tabelach czasem dzielę zmianę na kilka wdrożeń, aby ograniczyć ryzyko przerwy w działaniu.
Przeczytaj również: ORM w .NET - jak działa i kiedy warto go użyć?
Używanie niewłaściwego typu danych
Cena jako double, długi tekst bez limitu albo data zapisana jako zwykły tekst to decyzje, które później komplikują sortowanie i obliczenia. Dla pieniędzy wybieram decimal, dla identyfikatorów i relacji typy zgodne z bazą, a dla tekstów jawnie ustalam długość. Typ w klasie C# wpływa na typ kolumny SQL, więc nie jest wyłącznie detalem implementacyjnym.
Kiedy to podejście sprawdza się najlepiej
Code First dobrze pasuje do nowych aplikacji, projektów rozwijanych iteracyjnie i zespołów, które chcą trzymać model oraz jego historię w repozytorium. Szczególnie wygodne jest wtedy, gdy wymagania biznesowe zmieniają się często, a baza nie jest niezależnym produktem używanym przez wiele aplikacji.
Ostrożność zachowałbym przy współdzielonych bazach, rozbudowanych procedurach, ręcznie zarządzanych tabelach oraz systemach, w których schemat podlega osobnemu procesowi administracyjnemu. W takich przypadkach EF Core może nadal służyć do odczytu i zapisu, ale źródłem prawdy niekoniecznie powinny być migracje generowane przez aplikację.
Moja praktyczna reguła jest następująca. Jeśli zespół projektuje domenę i bazę równolegle, wybieram Code First z migracjami, Fluent API i przeglądem zmian. Jeśli baza już istnieje i ma własny cykl życia, najpierw ustalam właściciela schematu, a dopiero potem dobieram sposób generowania modeli.
Jak podejść do pierwszego projektu bez późniejszego długu
Zacznij od małego modelu, ale od początku stosuj zasady potrzebne w większym systemie. Wydziel konfigurację encji, trzymaj migracje w kontroli wersji, testuj zapytania na realistycznych danych i nie przechowuj sekretów w kodzie. Taki początek kosztuje niewiele, a oszczędza dużo pracy przy pierwszej poważnej zmianie schematu.
Największą wartością tego podejścia nie jest samo wygenerowanie tabel. Jest nią spójność między domeną, kodem i historią zmian bazy. Gdy migracje są traktowane jak część aplikacji, Entity Framework Core staje się praktycznym narzędziem do rozwijania danych, a nie tylko skrótem do tworzenia tabel.