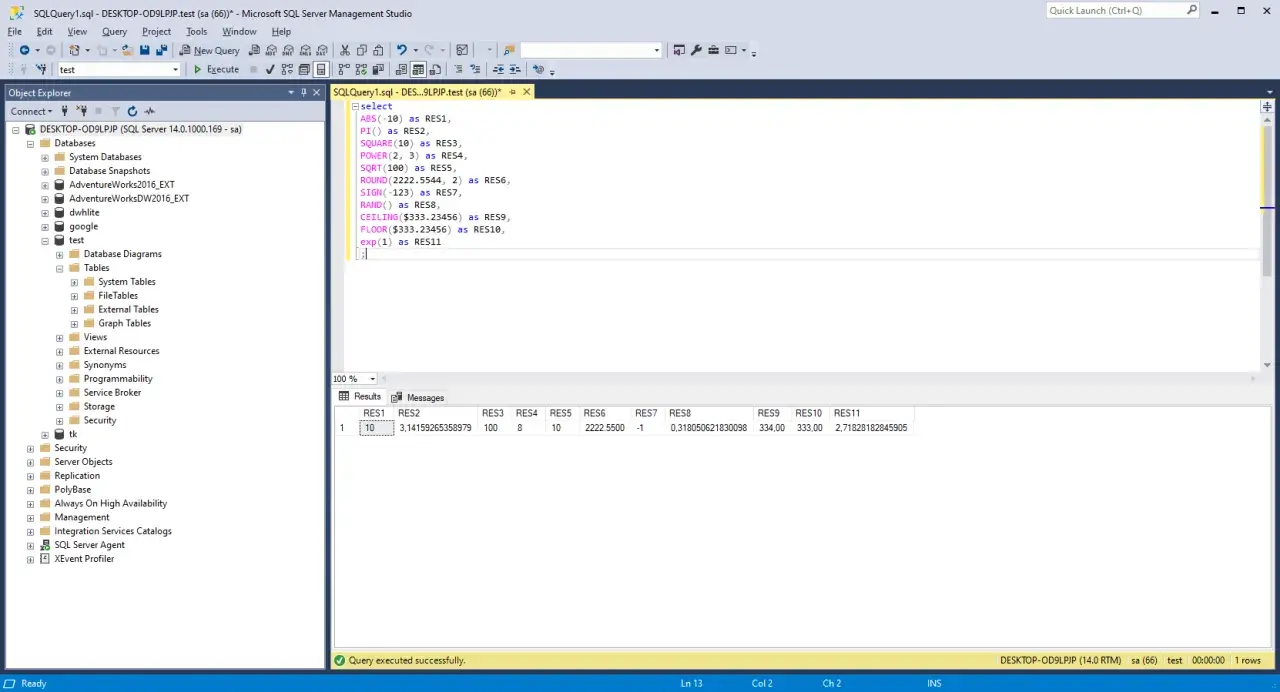
Gdy ta sama reguła biznesowa pojawia się w kilku zapytaniach, kopiowanie kodu szybko zaczyna się mścić. W dokumentacji anglojęzycznej taki temat bywa opisywany jako sql function, czyli funkcja SQL: wielokrotnego użytku fragment kodu, który przyjmuje dane wejściowe, wykonuje określoną operację i zwraca wynik. Pokażę, jak działają funkcje skalarne i tabelaryczne, kiedy lepiej wybrać procedurę oraz na co uważać w SQL Server, PostgreSQL i MySQL.
Funkcja SQL porządkuje logikę i zwraca gotowy wynik
- Funkcja skalarna zwraca jedną wartość, na przykład liczbę, tekst albo datę.
- Funkcja tabelaryczna zwraca zestaw wierszy, który można wykorzystać w zapytaniu.
- CREATE FUNCTION tworzy funkcję, ale składnia różni się między silnikami baz danych.
- Procedura składowana lepiej pasuje do operacji wykonujących akcje, a funkcja do obliczania i zwracania danych.
- Wydajność zależy od sposobu użycia funkcji, liczby przetwarzanych wierszy i możliwości optymalizatora.
Czym jest funkcja SQL i jak działa
Funkcja SQL to nazwany, zapisany w bazie fragment logiki, który można wywołać w wielu zapytaniach. Najczęściej przyjmuje zero lub więcej parametrów, wykonuje obliczenia albo odczytuje dane i zwraca rezultat w określonym typie.
Najprostszy przykład to funkcja obliczająca cenę brutto. Zamiast powtarzać wzór w raportach, widokach i zapytaniach aplikacji, zapisuję go raz i później wywołuję podobnie jak funkcję w C#:
SELECT dbo.CalculateGrossPrice(100.00, 23);Wynik może być pojedynczą wartością, ale nie zawsze musi nią być. W zależności od silnika funkcja może zwrócić także tabelę z wierszami i kolumnami, którą da się połączyć z innymi tabelami za pomocą JOIN, WHERE lub APPLY.
W praktyce funkcje dobrze sprawdzają się przy regułach, które są stabilne i używane w wielu miejscach. Przykładami są przeliczanie kwot, normalizacja numerów telefonu, wyznaczanie kategorii klienta czy filtrowanie danych według parametrów.
Funkcje systemowe i własne
Codziennie korzystamy z funkcji dostarczonych przez bazę, takich jak COUNT(), SUM(), COALESCE(), LOWER() czy DATEADD(). Są gotowymi elementami języka i zwykle nie wymagają tworzenia dodatkowych obiektów.
Funkcja użytkownika, określana często skrótem UDF, powstaje wtedy, gdy standardowy zestaw operacji nie wystarcza albo chcemy ukryć powtarzalną logikę za czytelną nazwą. To wygodne, ale nie oznacza, że każdą dłuższą instrukcję SQL trzeba automatycznie zamieniać w funkcję.
Dwa główne rodzaje funkcji
Najważniejszy podział dotyczy tego, co funkcja zwraca. Jeżeli rezultat mieści się w jednej wartości, używamy funkcji skalarnej. Jeżeli potrzebujemy wielu wierszy, właściwsza będzie funkcja tabelaryczna.
Funkcja skalarna zwraca jedną wartość
Funkcja skalarna może zwracać między innymi liczbę, tekst, wartość logiczną lub datę. W SQL Server przykładowa definicja może wyglądać tak:
CREATE FUNCTION dbo.CalculateGrossPrice
(
    @NetPrice decimal(10, 2),
    @VatRate decimal(5, 2)
)
RETURNS decimal(10, 2)
AS
BEGIN
    RETURN @NetPrice * (1 + @VatRate / 100);
END;
Wywołanie funkcji jest proste:
SELECT
    ProductName,
    NetPrice,
    dbo.CalculateGrossPrice(NetPrice, 23) AS GrossPrice
FROM Products;
Ten wariant jest czytelny i przydatny, gdy reguła ma charakter czysto obliczeniowy. Trzeba jednak pamiętać, że funkcja może zostać wykonana dla każdego przetwarzanego wiersza. Przy milionach rekordów nawet niewielki narzut może mieć znaczenie.
Funkcja tabelaryczna zwraca zestaw danych
Funkcja tabelaryczna jest bliższa parametryzowanemu widokowi. Przyjmuje argumenty i oddaje wynik, który można dalej filtrować lub łączyć z innymi danymi.
Przykład funkcji inline w SQL Server:
CREATE FUNCTION dbo.GetOrdersForCustomer
(
    @CustomerId int
)
RETURNS TABLE
AS
RETURN
(
    SELECT
        OrderId,
        OrderDate,
        TotalAmount
    FROM Orders
    WHERE CustomerId = @CustomerId
);
Taką funkcję można wykorzystać w zapytaniu:
SELECT *
FROM dbo.GetOrdersForCustomer(42)
WHERE TotalAmount > 1000;
W tym przypadku baza otrzymuje wynik w formie tabeli, a nie pojedynczej liczby. To dobry wybór, gdy logika filtrująca ma być współdzielona przez raporty, endpointy API i zadania administracyjne.
Funkcje agregujące to osobna kategoria
Funkcje takie jak SUM(), AVG() i COUNT() przetwarzają wiele wierszy i zwracają wynik zbiorczy. Nie należy ich mylić z typową funkcją użytkownika, choć również realizują ideę wielokrotnego użycia.
Jak utworzyć funkcję w popularnych bazach
Ogólny schemat zawsze opiera się na podobnych elementach: nazwie, parametrach, typie zwracanej wartości i ciele funkcji. Składnia nie jest jednak identyczna, dlatego kod napisany dla SQL Server nie zawsze można wkleić bez zmian do PostgreSQL albo MySQL.
SQL Server i Azure SQL
W środowisku Microsoft najczęściej korzysta się z języka T-SQL. Funkcja skalarna ma sekcję RETURNS oraz ciało zamknięte w BEGIN i END. Funkcja tabelaryczna może zwracać bezpośrednio wynik pojedynczego zapytania SELECT.
SQL Server rozróżnia między innymi inline table-valued function oraz wieloinstrukcyjną funkcję tabelaryczną. Pierwsza jest zazwyczaj łatwiejsza do optymalizacji, ponieważ jej wynik opiera się na jednym zapytaniu. Druga daje więcej swobody, ale może mieć większy koszt wykonania.
PostgreSQL
W PostgreSQL funkcję tworzy się poleceniem CREATE FUNCTION, a język implementacji określa się między innymi przez LANGUAGE SQL albo LANGUAGE plpgsql:
CREATE FUNCTION calculate_discount(
    price numeric,
    discount_percent numeric
)
RETURNS numeric
LANGUAGE SQL
IMMUTABLE
AS $$
    SELECT price * (1 - discount_percent / 100);
$$;
Ważne słowo to IMMUTABLE. Informuje bazę, że dla tych samych argumentów funkcja zawsze zwraca ten sam wynik i nie zależy od danych zmieniających się poza jej parametrami. PostgreSQL pozwala też oznaczyć funkcję jako STABLE lub VOLATILE, gdy jej wynik może zależeć od stanu bazy albo czasu.
MySQL
W MySQL funkcję przechowywaną definiuje się z użyciem CREATE FUNCTION. Trzeba wskazać typ zwracanej wartości oraz ciało funkcji. Przy definicjach zawierających średniki często zmienia się tymczasowo delimiter klienta:
DELIMITER //

CREATE FUNCTION calculate_net_price(
    gross_price DECIMAL(10, 2),
    vat_rate DECIMAL(5, 2)
)
RETURNS DECIMAL(10, 2)
DETERMINISTIC
BEGIN
    RETURN gross_price / (1 + vat_rate / 100);
END//

DELIMITER ;
W MySQL parametry funkcji są parametrami wejściowymi. Jeżeli logika ma zwracać wiele rekordów albo wykonywać rozbudowaną operację sterującą, często lepszym rozwiązaniem będzie procedura lub zwykłe zapytanie z CTE.
Funkcja SQL a procedura składowana
Te dwa obiekty bywają mylone, bo oba przechowują kod po stronie bazy. Różnica jest praktyczna: funkcję wywołuję zwykle wewnątrz wyrażenia lub zapytania, natomiast procedurę uruchamiam jako osobną operację.
| Cecha | Funkcja | Procedura |
|---|---|---|
| Główny cel | Obliczenie lub zwrócenie danych | Wykonanie operacji lub procesu |
| Sposób wywołania | W zapytaniu, na przykład w SELECT
|
Osobnym poleceniem, na przykład EXEC lub CALL
|
| Wynik | Wartość skalarna albo tabela | Parametry wyjściowe, komunikaty lub zestawy wyników |
| Modyfikacja danych | Często ograniczona przez silnik | Zwykle przeznaczona do zapisu i zmian danych |
| Typowe zastosowanie | Reguły obliczeniowe i filtrowanie | Import, zapis zamówienia, rozliczenie lub proces wieloetapowy |
Jeśli tworzę funkcję do obliczania rabatu, jej użycie w SELECT ma sens. Jeżeli natomiast trzeba zapisać zamówienie, zmniejszyć stan magazynowy, dodać wpis do dziennika i obsłużyć błędy, wybieram procedurę. Próba upchnięcia całego procesu biznesowego w funkcji zwykle kończy się ograniczeniami i trudniejszym debugowaniem.
Warto też sprawdzić możliwości konkretnego silnika. SQL Server ogranicza funkcje użytkownika między innymi w zakresie trwałych zmian danych. PostgreSQL i MySQL mają własne reguły dotyczące modyfikacji, transakcji, uprawnień i odczytu danych.
Kiedy funkcja poprawia kod, a kiedy go spowalnia
Największą zaletą funkcji jest centralizacja logiki. Gdy sposób liczenia punktów lojalnościowych zmienia się w jednym miejscu, poprawka może objąć wszystkie raporty i zapytania. Zyskuję też spójne nazewnictwo oraz mniejsze ryzyko, że dwie części aplikacji policzą tę samą rzecz inaczej.
Druga korzyść to możliwość przeniesienia części logiki bliżej danych. W aplikacji .NET funkcja może być używana przez wiele endpointów, usług i zadań, bez kopiowania tego samego kodu w C#. To szczególnie wygodne przy raportowaniu i walidacji danych współdzielonych przez kilka aplikacji.
Problem zaczyna się wtedy, gdy funkcja skalarna jest wywoływana dla bardzo dużej liczby rekordów. W starszych lub niekorzystnych planach wykonania może działać niemal jak osobna operacja dla każdego wiersza. Nowsze wersje SQL Server potrafią automatycznie wbudować część funkcji skalarnych w zapytanie, ale nie każda funkcja spełnia warunki optymalizacji.
Przed wdrożeniem sprawdzam plan wykonania i czas zapytania na reprezentatywnych danych. Funkcja, która działa świetnie na 10 tysiącach rekordów, może stać się wąskim gardłem przy 50 milionach. W takim przypadku lepsze bywają operacje zbiorcze, jawny JOIN, widok, kolumna wyliczana albo funkcja tabelaryczna inline.
Najczęstsze problemy wydajnościowe
- Wywoływanie funkcji skalarnej w filtrze dla każdego wiersza dużej tabeli.
- Ukrywanie zapytania do tabeli wewnątrz funkcji używanej wielokrotnie w jednym raporcie.
- Konwersja typów danych przy każdym wywołaniu, na przykład tekstu na datę lub liczbę.
- Funkcja obejmująca zbyt dużo logiki, przez co optymalizator ma mniej swobody.
- Brak indeksów na kolumnach używanych przez funkcję tabelaryczną.
Sam fakt, że kod jest zapisany w bazie, nie gwarantuje szybkości. Najpierw patrzę na kształt zapytania, kardynalność danych i plan wykonania, a dopiero później decyduję, czy funkcja jest właściwą abstrakcją.
Jak projektować funkcje, żeby nie żałować po kilku miesiącach
Dobra funkcja powinna mieć jedno jasno nazwane zadanie. Nazwa CalculateCustomerRiskScore mówi znacznie więcej niż ogólne ProcessData. Dzięki temu osoba czytająca zapytanie rozumie intencję bez zaglądania do definicji.
Typy parametrów powinny odpowiadać typom kolumn i regułom domenowym. Nie warto przyjmować ceny jako tekstu tylko dlatego, że dane pochodzą z formularza. Konwersję wykonuję na granicy aplikacji lub podczas kontrolowanego importu, a w samej funkcji operuję na właściwych typach liczbowych.
Trzeba też świadomie obsłużyć wartości NULL. Funkcja może zwrócić NULL, gdy jeden z argumentów jest pusty, albo przyjąć wartość domyślną przez COALESCE(). Nie ma jednej poprawnej decyzji, ale powinna wynikać z reguły biznesowej, a nie z przypadku.
CREATE FUNCTION dbo.GetCustomerLabel
(
    @CustomerType varchar(20),
    @IsBlocked bit
)
RETURNS varchar(50)
AS
BEGIN
    RETURN
        CASE
            WHEN @IsBlocked = 1 THEN 'Zablokowany'
            WHEN @CustomerType IS NULL THEN 'Nieznany'
            WHEN @CustomerType = 'business' THEN 'Firma'
            ELSE 'Klient indywidualny'
        END;
END;
Taką funkcję warto przetestować przynajmniej dla wartości standardowej, NULL, granicznej i nieoczekiwanej. W praktyce właśnie przypadki brzegowe, takie jak zerowa stawka, ujemna kwota albo pusta data, ujawniają najwięcej błędów.
Przeczytaj również: Pętla do-while w C# - składnia, przykłady i pułapki
Bezpieczeństwo i uprawnienia
Funkcja działa w kontekście uprawnień zależnym od konkretnego silnika i sposobu jej zdefiniowania. Jeżeli odczytuje wrażliwe dane, nie traktuję jej jako automatycznego mechanizmu bezpieczeństwa. Uprawnienia do tabel, widoków i samej funkcji powinny być sprawdzone osobno.
Warto również rozważyć związanie funkcji ze schematem, jeśli baza to umożliwia. W SQL Server opcja SCHEMABINDING ogranicza możliwość zmiany obiektów, od których zależy funkcja. To zwiększa stabilność, ale utrudnia późniejsze modyfikacje schematu, więc używam jej świadomie.
Praktyczna decyzja przed użyciem CREATE FUNCTION
Przed utworzeniem funkcji odpowiadam sobie na kilka konkretnych pytań. Czy ta sama logika jest naprawdę używana w wielu miejscach? Czy ma zwracać jedną wartość, czy zbiór danych? Czy musi działać dla każdego wiersza, czy da się ją wykonać zbiorczo?
- Wybierz funkcję skalarną, gdy obliczasz pojedynczy wynik na podstawie kilku parametrów.
- Wybierz funkcję tabelaryczną, gdy chcesz zwracać filtrowany zestaw rekordów.
- Wybierz procedurę, gdy operacja ma zapisywać dane, wykonywać kilka kroków lub obsługiwać proces.
- Wybierz zwykłe zapytanie albo widok, gdy logika nie jest parametryzowana i nie wymaga osobnego obiektu.
- Wybierz kod aplikacji, gdy reguła często się zmienia, wymaga złożonych bibliotek albo powinna być testowana poza bazą.
Moja praktyczna zasada jest prosta: funkcja powinna skracać drogę do poprawnego zapytania, a nie ukrywać przed programistą kolejną warstwę złożoności. Jeżeli po jej dodaniu trudniej zrozumieć plan wykonania, testować reguły lub diagnozować błąd, abstrakcja prawdopodobnie jest zbyt ciężka.
Funkcja SQL jako mały kontrakt między aplikacją a bazą
Dobrze zaprojektowana funkcja jest czymś więcej niż skrótem do kilku instrukcji. Tworzy stabilny kontrakt: przyjmuje określone dane, przestrzega jednej reguły i zwraca przewidywalny wynik. To właśnie dlatego dobrze nadaje się do wspólnych zasad obliczeniowych używanych przez aplikację .NET, raporty i zadania uruchamiane w Azure.
Najbezpieczniej zaczynać od małej funkcji, przetestować ją na danych rzeczywistych i sprawdzić plan wykonania. Dopiero gdy wynik, wydajność i zachowanie dla wartości NULL są jasne, warto udostępniać ją kolejnym częściom systemu. Taki proces zwykle daje więcej niż tworzenie rozbudowanych funkcji tylko dlatego, że baza pozwala przechowywać w niej dużo kodu.